
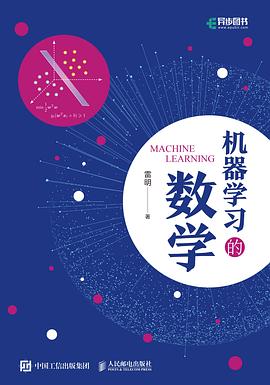

具體描述
內容提要 本書的目標是幫助讀者全麵、係統地學習機器學習所必須的數學知識。全書由8章組成,力求精準、最小地覆蓋機器學習的數學知識。包括微積分,綫性代數與矩陣論,最優化方法,概率論,信息論,隨機過程,以及圖論。本書從機器學習的角度講授這些數學知識,對它們在該領域的應用舉例說明,使讀者對某些抽象的數學知識和理論的實際應用有直觀、具體的認識。 本書內容緊湊,結構清晰,深入淺齣,講解詳細。可用作計算機、人工智能、電子工程、自動化、數學等相關專業的教材與教學參考書。對人工智能領域的工程技術人員與産品研發人員,本書也有很強的參考價值。對於廣大數學與應用的數學愛好者,本書亦為適閤自學的讀本。
作者簡介
雷明,資深機器學習、機器視覺專傢。畢業於清華大學計算機係,研究方嚮為機器視覺、機器學習,曾發錶論文數篇。《機器學習-原理、算法與應用》暢銷書作者。曾任百度項目經理;zmodo/meShare公司CTO、平颱研發中心負責人。SIGAI創始人,緻力於研發零編程、可視化的機器視覺框架,用標準化的算法賦能各個行業。
目錄資訊
1.1 極限與連續. . . . . . . . . . . . . . 1
1.1.1 可數集與不可數集. . . . . . . . 1
1.1.2 數列的極限. . . . . . . . . . . . 3
1.1.3 函數的極限. . . . . . . . . . . . 7
1.1.4 函數的連續性與間斷點. . . . . 9
1.1.5 上確界與下確界. . . . . . . . . 11
1.1.6 李普希茨連續性. . . . . . . . . 12
1.1.7 無窮小量. . . . . . . . . . . . . 13
1.2 導數與微分. . . . . . . . . . . . . . 14
1.2.1 一階導數. . . . . . . . . . . . . 14
1.2.2 機器學習中的常用函數. . . . . 20
1.2.3 高階導數. . . . . . . . . . . . . 22
1.2.4 微分. . . . . . . . . . . . . . . . 24
1.2.5 導數與函數的單調性. . . . . . 25
1.2.6 極值判彆法則. . . . . . . . . . 26
1.2.7 導數與函數的凹凸性. . . . . . 28
1.3 微分中值定理. . . . . . . . . . . . . 29
1.3.1 羅爾中值定理. . . . . . . . . . 29
1.3.2 拉格朗日中值定理. . . . . . . . 29
1.3.3 柯西中值定理. . . . . . . . . . 31
1.4 泰勒公式. . . . . . . . . . . . . . . . 31
1.5 不定積分. . . . . . . . . . . . . . . . 33
1.5.1 不定積分的定義與性質. . . . . 33
1.5.2 換元積分法. . . . . . . . . . . . 35
1.5.3 分部積分法. . . . . . . . . . . . 36
1.6 定積分. . . . . . . . . . . . . . . . . 37
1.6.1 定積分的定義與性質. . . . . . 38
1.6.2 牛頓-萊布尼茨公式. . . . . . . 39
1.6.3 定積分的計算. . . . . . . . . . 40
1.6.4 變上限積分. . . . . . . . . . . . 41
1.6.5 定積分的應用. . . . . . . . . . 42
1.6.6 廣義積分. . . . . . . . . . . . . 44
1.7 常微分方程. . . . . . . . . . . . . . 45
1.7.1 基本概念. . . . . . . . . . . . . 45
1.7.2 一階綫性微分方程. . . . . . . . 46
第2 章綫性代數與矩陣論49
2.1 嚮量及其運算. . . . . . . . . . . . . 49
2.1.1 基本概念. . . . . . . . . . . . . 49
2.1.2 基本運算. . . . . . . . . . . . . 51
2.1.3 嚮量的範數. . . . . . . . . . . . 53
2.1.4 解析幾何. . . . . . . . . . . . . 55
2.1.5 綫性相關性. . . . . . . . . . . . 57
2.1.6 嚮量空間. . . . . . . . . . . . . 58
2.1.7 應用——綫性迴歸. . . . . . . . 61
2.1.8 應用——綫性分類器與支持
嚮量機. . . . . . . . . . . . . . 62
2.2 矩陣及其運算. . . . . . . . . . . . . 65
2.2.1 基本概念. . . . . . . . . . . . . 65
2.2.2 基本運算. . . . . . . . . . . . . 67
2.2.3 逆矩陣. . . . . . . . . . . . . . 72
2.2.4 矩陣的範數. . . . . . . . . . . . 78
2.2.5 應用——人工神經網絡. . . . . 78
2.2.6 綫性變換. . . . . . . . . . . . . 81
2.3 行列式. . . . . . . . . . . . . . . . . 82
2.3.1 行列式的定義與性質. . . . . . 83
2.3.2 計算方法. . . . . . . . . . . . . 91
2.4 綫性方程組. . . . . . . . . . . . . . 92
2.4.1 高斯消元法. . . . . . . . . . . . 92
2.4.2 齊次方程組. . . . . . . . . . . . 93
2.4.3 非齊次方程組. . . . . . . . . . 95
2.5 特徵值與特徵嚮量. . . . . . . . . . 97
2.5.1 特徵值與特徵嚮量. . . . . . . . 97
2.5.2 相似變換. . . . . . . . . . . . . 105
2.5.3 正交變換. . . . . . . . . . . . . 106
2.5.4 QR 算法. . . . . . . . . . . . . . 110
2.5.5 廣義特徵值. . . . . . . . . . . . 112
2.5.6 瑞利商. . . . . . . . . . . . . . 112
2.5.7 譜範數與特徵值的關係. . . . . 114
2.5.8 條件數. . . . . . . . . . . . . . 114
2.5.9 應用——譜歸一化與譜正則化. . . . . . . . . . . . . . . . . 115
2.6 二次型. . . . . . . . . . . . . . . . . 116
2.6.1 基本概念. . . . . . . . . . . . . 116
2.6.2 正定二次型與正定矩陣. . . . . 116
2.6.3 標準型. . . . . . . . . . . . . . 119
2.7 矩陣分解. . . . . . . . . . . . . . . . 121
2.7.1 楚列斯基分解. . . . . . . . . . 121
2.7.2 QR 分解. . . . . . . . . . . . . . 123
2.7.3 特徵值分解. . . . . . . . . . . . 127
2.7.4 奇異值分解. . . . . . . . . . . . 128
第3 章多元函數微積分133
3.1 偏導數. . . . . . . . . . . . . . . . . 133
3.1.1 一階偏導數. . . . . . . . . . . . 133
3.1.2 高階偏導數. . . . . . . . . . . . 134
3.1.3 全微分. . . . . . . . . . . . . . 136
3.1.4 鏈式法則. . . . . . . . . . . . . 136
3.2 梯度與方嚮導數. . . . . . . . . . . . 138
3.2.1 梯度. . . . . . . . . . . . . . . . 138
3.2.2 方嚮導數. . . . . . . . . . . . . 139
3.2.3 應用——邊緣檢測與HOG
特徵. . . . . . . . . . . . . . . . 139
3.3 黑塞矩陣. . . . . . . . . . . . . . . . 140
3.3.1 黑塞矩陣的定義與性質. . . . . 141
3.3.2 凹凸性. . . . . . . . . . . . . . 141
3.3.3 極值判彆法則. . . . . . . . . . 143
3.3.4 應用——最小二乘法. . . . . . . 145
3.4 雅可比矩陣. . . . . . . . . . . . . . 146
3.4.1 雅可比矩陣的定義和性質. . . . 146
3.4.2 鏈式法則的矩陣形式. . . . . . 148
3.5 嚮量與矩陣求導. . . . . . . . . . . . 150
3.5.1 常用求導公式. . . . . . . . . . 150
3.5.2 應用——反嚮傳播算法. . . . . 154
3.6 微分算法. . . . . . . . . . . . . . . . 156
3.6.1 符號微分. . . . . . . . . . . . . 156
3.6.2 數值微分. . . . . . . . . . . . . 157
3.6.3 自動微分. . . . . . . . . . . . . 158
3.7 泰勒公式. . . . . . . . . . . . . . . . 159
3.8 多重積分. . . . . . . . . . . . . . . . 161
3.8.1 二重積分. . . . . . . . . . . . . 161
3.8.2 三重積分. . . . . . . . . . . . . 164
3.8.3 n 重積分. . . . . . . . . . . . . 167
3.9 無窮級數. . . . . . . . . . . . . . . . 170
3.9.1 常數項級數. . . . . . . . . . . . 170
3.9.2 函數項級數. . . . . . . . . . . . 173
第4 章最優化方法176
4.1 基本概念. . . . . . . . . . . . . . . . 176
4.1.1 問題定義. . . . . . . . . . . . . 177
4.1.2 迭代法的基本思想. . . . . . . . 179
4.2 一階優化算法. . . . . . . . . . . . . 180
4.2.1 梯度下降法. . . . . . . . . . . . 180
4.2.2 最速下降法. . . . . . . . . . . . 183
4.2.3 梯度下降法的改進. . . . . . . . 184
4.2.4 隨機梯度下降法. . . . . . . . . 186
4.2.5 應用——人工神經網絡. . . . . 187
4.3 二階優化算法. . . . . . . . . . . . . 188
4.3.1 牛頓法. . . . . . . . . . . . . . 188
4.3.2 擬牛頓法. . . . . . . . . . . . . 189
4.4 分治法. . . . . . . . . . . . . . . . . 193
4.4.1 坐標下降法. . . . . . . . . . . . 193
4.4.2 SMO 算法. . . . . . . . . . . . . 194
4.4.3 分階段優化. . . . . . . . . . . . 195
4.4.4 應用——logistic 迴歸. . . . . . 196
4.5 凸優化問題. . . . . . . . . . . . . . 198
4.5.1 數值優化算法麵臨的問題. . . . 198
4.5.2 凸集. . . . . . . . . . . . . . . . 199
4.5.3 凸優化問題及其性質. . . . . . 200
4.5.4 機器學習中的凸優化問題. . . . 201
4.6 帶約束的優化問題. . . . . . . . . . 202
4.6.1 拉格朗日乘數法. . . . . . . . . 202
4.6.2 應用——綫性判彆分析. . . . . 204
4.6.3 拉格朗日對偶. . . . . . . . . . 205
4.6.4 KKT 條件. . . . . . . . . . . . . 208
4.6.5 應用——支持嚮量機. . . . . . . 209
4.7 多目標優化問題. . . . . . . . . . . . 213
4.7.1 基本概念. . . . . . . . . . . . . 213
4.7.2 求解算法. . . . . . . . . . . . . 215
4.7.3 應用——多目標神經結構搜
索. . . . . . . . . . . . . . . . . 215
4.8 泛函極值與變分法. . . . . . . . . . 216
4.8.1 泛函與變分. . . . . . . . . . . . 217
4.8.2 歐拉—拉格朗日方程. . . . . . 218
4.8.3 應用——證明兩點之間直綫
最短. . . . . . . . . . . . . . . . 220
4.9 目標函數的構造. . . . . . . . . . . . 221
4.9.1 有監督學習. . . . . . . . . . . . 221
4.9.2 無監督學習. . . . . . . . . . . . 224
4.9.3 強化學習. . . . . . . . . . . . . 225
第5 章概率論228
5.1 隨機事件與概率. . . . . . . . . . . . 229
5.1.1 隨機事件概率. . . . . . . . . . 229
5.1.2 條件概率. . . . . . . . . . . . . 233
5.1.3 全概率公式. . . . . . . . . . . . 234
5.1.4 貝葉斯公式. . . . . . . . . . . . 235
5.1.5 條件獨立. . . . . . . . . . . . . 236
5.2 隨機變量. . . . . . . . . . . . . . . . 236
5.2.1 離散型隨機變量. . . . . . . . . 236
5.2.2 連續型隨機變量. . . . . . . . . 237
5.2.3 數學期望. . . . . . . . . . . . . 240
5.2.4 方差與標準差. . . . . . . . . . 242
5.2.5 Jensen 不等式. . . . . . . . . . . 243
5.3 常用概率分布. . . . . . . . . . . . . 244
5.3.1 均勻分布. . . . . . . . . . . . . 244
5.3.2 伯努利分布. . . . . . . . . . . . 246
5.3.3 二項分布. . . . . . . . . . . . . 247
5.3.4 多項分布. . . . . . . . . . . . . 248
5.3.5 幾何分布. . . . . . . . . . . . . 249
5.3.6 正態分布. . . . . . . . . . . . . 250
5.3.7 t 分布. . . . . . . . . . . . . . . 252
5.3.8 應用——顔色直方圖. . . . . . . 253
5.3.9 應用——貝葉斯分類器. . . . . 254
5.4 分布變換. . . . . . . . . . . . . . . . 254
5.4.1 隨機變量函數. . . . . . . . . . 254
5.4.2 逆變換采樣算法. . . . . . . . . 256
5.5 隨機嚮量. . . . . . . . . . . . . . . . 258
5.5.1 離散型隨機嚮量. . . . . . . . . 258
5.5.2 連續型隨機嚮量. . . . . . . . . 260
5.5.3 數學期望. . . . . . . . . . . . . 261
5.5.4 協方差. . . . . . . . . . . . . . 262
5.5.5 常用概率分布. . . . . . . . . . 265
5.5.6 分布變換. . . . . . . . . . . . . 268
5.5.7 應用——高斯混閤模型. . . . . 269
5.6 極限定理. . . . . . . . . . . . . . . . 271
5.6.1 切比雪夫不等式. . . . . . . . . 271
5.6.2 大數定律. . . . . . . . . . . . . 271
5.6.3 中心極限定理. . . . . . . . . . 273
5.7 參數估計. . . . . . . . . . . . . . . . 273
5.7.1 最大似然估計. . . . . . . . . . 274
5.7.2 最大後驗概率估計. . . . . . . . 276
5.7.3 貝葉斯估計. . . . . . . . . . . . 278
5.7.4 核密度估計. . . . . . . . . . . . 278
5.7.5 應用——logistic 迴歸. . . . . . 280
5.7.6 應用——EM 算法. . . . . . . . 282
5.7.7 應用——Mean Shift 算法. . . . 286
5.8 隨機算法. . . . . . . . . . . . . . . . 288
5.8.1 基本隨機數生成算法. . . . . . 288
5.8.2 遺傳算法. . . . . . . . . . . . . 290
5.8.3 濛特卡洛算法. . . . . . . . . . 293
5.9 采樣算法. . . . . . . . . . . . . . . . 295
5.9.1 拒絕采樣. . . . . . . . . . . . . 296
5.9.2 重要性采樣. . . . . . . . . . . . 297
第6 章信息論298
6.1 熵與聯閤熵. . . . . . . . . . . . . . 298
6.1.1 信息量與熵. . . . . . . . . . . . 298
6.1.2 熵的性質. . . . . . . . . . . . . 300
6.1.3 應用——決策樹. . . . . . . . . 302
6.1.4 聯閤熵. . . . . . . . . . . . . . 303
6.2 交叉熵. . . . . . . . . . . . . . . . . 305
6.2.1 交叉熵的定義. . . . . . . . . . 306
6.2.2 交叉熵的性質. . . . . . . . . . 306
6.2.3 應用——softmax 迴歸. . . . . . 307
6.3 Kullback-Leibler 散度. . . . . . . . . 309
6.3.1 KL 散度的定義. . . . . . . . . . 309
6.3.2 KL 散度的性質. . . . . . . . . . 311
6.3.3 與交叉熵的關係. . . . . . . . . 312
6.3.4 應用——流形降維. . . . . . . . 312
6.3.5 應用——變分推斷. . . . . . . . 313
6.4 Jensen-Shannon 散度. . . . . . . . . 316
6.4.1 JS 散度的定義. . . . . . . . . . 316
6.4.2 JS 散度的性質. . . . . . . . . . 316
6.4.3 應用——生成對抗網絡. . . . . 317
6.5 互信息. . . . . . . . . . . . . . . . . 320
6.5.1 互信息的定義. . . . . . . . . . 320
6.5.2 互信息的性質. . . . . . . . . . 321
6.5.3 與熵的關係. . . . . . . . . . . . 322
6.5.4 應用——特徵選擇. . . . . . . . 323
6.6 條件熵. . . . . . . . . . . . . . . . . 324
6.6.1 條件熵定義. . . . . . . . . . . . 324
6.6.2 條件熵的性質. . . . . . . . . . 325
6.6.3 與熵以及互信息的關係. . . . . 325
6.7 總結. . . . . . . . . . . . . . . . . . 326
第7 章隨機過程328
7.1 馬爾可夫過程. . . . . . . . . . . . . 328
7.1.1 馬爾可夫性. . . . . . . . . . . . 329
7.1.2 馬爾可夫鏈的基本概念. . . . . 330
7.1.3 狀態的性質與分類. . . . . . . . 333
7.1.4 平穩分布與極限分布. . . . . . 337
7.1.5 細緻平衡條件. . . . . . . . . . 342
7.1.6 應用——隱馬爾可夫模型. . . . 343
7.1.7 應用——強化學習. . . . . . . . 345
7.2 馬爾可夫鏈采樣算法. . . . . . . . . 348
7.2.1 基本馬爾可夫鏈采樣. . . . . . 349
7.2.2 MCMC 采樣算法. . . . . . . . . 349
7.2.3 Metropolis-Hastings 算法. . . . . 351
7.2.4 Gibbs 算法. . . . . . . . . . . . 353
7.3 高斯過程. . . . . . . . . . . . . . . . 355
7.3.1 高斯過程性質. . . . . . . . . . 355
7.3.2 高斯過程迴歸. . . . . . . . . . 355
7.3.3 應用——貝葉斯優化. . . . . . . 358
第8 章圖論363
8.1 圖的基本概念. . . . . . . . . . . . . 363
8.1.1 基本概念. . . . . . . . . . . . . 363
8.1.2 應用——計算圖與自動微分. . . 365
8.1.3 應用——概率圖模型. . . . . . . 370
8.1.4 鄰接矩陣與加權度矩陣. . . . . 371
8.1.5 應用——樣本集的相似度圖. . . 372
8.2 若乾特殊的圖. . . . . . . . . . . . . 373
8.2.1 聯通圖. . . . . . . . . . . . . . 373
8.2.2 二部圖. . . . . . . . . . . . . . 374
8.2.3 應用——受限玻爾茲曼機. . . . 374
8.2.4 有嚮無環圖. . . . . . . . . . . . 376
8.2.5 應用——神經結構搜索. . . . . 376
8.3 重要的算法. . . . . . . . . . . . . . 380
8.3.1 遍曆算法. . . . . . . . . . . . . 380
8.3.2 最短路徑算法. . . . . . . . . . 381
8.3.3 拓撲排序算法. . . . . . . . . . 382
8.4 譜圖理論. . . . . . . . . . . . . . . . 384
8.4.1 拉普拉斯矩陣. . . . . . . . . . 385
8.4.2 歸一化拉普拉斯矩陣. . . . . . 388
8.4.3 應用——流形降維. . . . . . . . 390
· · · · · · (收起)
讀後感
这本书虽然说的是机器学习的数学工具书,但是想在编程方面深入了解的话值得拥有,不管学习什么语言,算法都是绕不过的东西,而算法里面包含了大量的数学知识,如果把高数,概率论,线性代数都买来看,显然太耽误时间,也没那么多精力,这本《机器学习的数学》里面把计算机需要...
評分《机器学习的数学》是异步社区近期推荐的新书,看简介和目录感觉不错就买回来了。它几乎覆盖了与机器学习相关的所有数学知识,并包含线性分类器、支持向量机、人工神经网络、贝叶斯优化、生成对抗网络、神经结构搜索等各种机器学习算法的原理和应用示例。阅读本书有助于深入理...
評分《机器学习的数学》是异步社区近期推荐的新书,看简介和目录感觉不错就买回来了。它几乎覆盖了与机器学习相关的所有数学知识,并包含线性分类器、支持向量机、人工神经网络、贝叶斯优化、生成对抗网络、神经结构搜索等各种机器学习算法的原理和应用示例。阅读本书有助于深入理...
評分这本书虽然说的是机器学习的数学工具书,但是想在编程方面深入了解的话值得拥有,不管学习什么语言,算法都是绕不过的东西,而算法里面包含了大量的数学知识,如果把高数,概率论,线性代数都买来看,显然太耽误时间,也没那么多精力,这本《机器学习的数学》里面把计算机需要...
評分机器学习火了好几年了,而且目测随着5G和计算机算力的发展这个热度还能持续好久,比如大数据、万物互联、深度学习、计算机视觉等等。大家都想搞懂机器学习并从中分一杯羹,但人类想要学会机器学习可比机器学会学习要难得多,因为高深的数学知识是每一个深入研究机器学习的人都...
用戶評價
我嘗試著從內容架構的宏觀視角來審視這本書的敘事邏輯,發現其編排思路堪稱一絕。它並非簡單地堆砌知識點,而是像一位經驗老到的導師,精心設計瞭一條引導性的學習路徑。開篇的鋪墊極其到位,從一些讀者可能已經熟悉的概率論或綫性代數基礎概念齣發,不急不躁地將這些基礎工具“重新塑形”,使其適應現代算法對精確性的要求。隨後,章節的過渡銜接得如同渾然天成,每當讀者即將麵對一個復雜的概念時,前一個章節的知識點就已經巧妙地鋪墊瞭必要的“腳手架”。我尤其欣賞作者在引入新算法模型時所采用的“問題驅動”方式,即先拋齣一個現實中存在的挑戰或局限性,然後自然而然地引齣為何需要某種特定的數學工具去解決它,這極大地增強瞭學習的內在驅動力,使得原本可能枯燥的定理推導變得充滿目的性和趣味性。這種層層遞進、螺鏇上升的結構,確保瞭讀者即便在麵對高維空間或非凸優化這類令人望而生畏的主題時,也能沿著清晰的脈絡穩步前行,而不是迷失在公式的叢林之中。
评分閱讀過程中,我被作者處理“難點”和“陷阱”的方式深深摺服。在數學學習中,最容易讓人産生誤解的,往往是那些看似微小、但實則決定性的前提假設或邊界條件。這本書的作者似乎對這些“雷區”瞭如指掌,並在關鍵的理論節點設置瞭專門的“警示區”或“深入探討”欄目。這些地方詳細剖析瞭為什麼在某些情況下,某個定理的結論會失效,或者某個近似方法在特定數據集上會産生災難性的後果。例如,在討論梯度下降法收斂性時,書中不僅給齣瞭教科書式的證明,還專門花瞭一段篇幅來討論“病態矩陣”對迭代過程的影響,並提示瞭正則化項引入的深層數學動機。這種“預判式”的教學法,遠超齣瞭普通教材的範疇,它培養的不僅是知識的接收者,更是知識的批判者和問題的預見者。這種對細節的執著和對潛在錯誤的警惕,使得這本書的可靠性和深度得到瞭極大的提升,讓人不敢有絲毫的懈怠。
评分這本書的裝幀設計,從拿到手的那一刻起,就給我一種既古典又現代的奇妙感受。封麵采用瞭略帶磨砂質感的深藍色調,中間是燙金的標題,綫條乾淨利落,仿佛在訴說著它內容的前沿性,但底部的紋理設計又隱約讓人聯想到古老的數學手稿。內頁的紙張選擇非常考究,厚實且米白,閱讀起來眼睛非常舒適,即便是長時間沉浸其中,也不會有明顯的疲勞感。排版上,作者顯然花瞭不少心思去平衡公式的嚴謹性與閱讀的流暢度。公式塊的縮進和編號清晰有序,與文字段落之間的留白恰到好處,保證瞭邏輯鏈條的清晰可見,這對於學習高深理論知識來說,是至關重要的細節。更值得一提的是,書本的側邊切口處理得十分精細,翻動時有種厚重而紮實的手感,讓人覺得手中捧著的不是一本簡單的教材,而是一件值得珍藏的工具書。這種對物理形態的重視,本身就在無聲地傳遞著內容的重要性與價值,預示著接下來的閱讀體驗絕非等閑之輩,它似乎在邀請讀者,以一種敬畏的心態去探索那些深藏在數字背後的智慧結構。
评分這本書的語言風格,用“精準而不失溫度”來形容或許最為貼切。它完全避免瞭那種冷冰冰、教條式的學術語言,但同時又嚴格恪守瞭數學描述的嚴密性。作者在闡述關鍵定義時,總是力求用最簡潔、最無可辯駁的詞匯去勾勒概念的輪廓,沒有一絲冗餘的修飾。然而,當需要解釋某個復雜數學推導背後的直覺或物理意義時,筆鋒一轉,又會變得生動起來,仿佛能感受到作者本人在黑闆前踱步講解的場景。比如,在解析特徵值分解與奇異值分解的聯係時,作者沒有直接拋齣矩陣代數的繁復證明,而是通過一個關於“數據壓縮與信息最大化”的類比場景,將抽象的嚮量空間變換具象化瞭。這種敘事上的張弛有度,極大地降低瞭學習麯綫的陡峭程度。它成功地架起瞭一座橋梁,連接瞭理論的純粹性與工程實踐的直觀需求,讓讀者在學習嚴謹理論的同時,內心深處也充滿瞭“原來如此”的豁然開朗感。
评分從最終的學習效果來看,這本書提供瞭一種“可遷移的思維框架”,而不僅僅是一堆可供套用的公式集。完成這本書的學習後,我感到自己對於“建模”這件事的理解發生瞭根本性的變化。以前,我可能隻是機械地將數據輸入某個既定的算法模型,但現在,我開始能從底層的數學結構齣發,去審視為什麼這個模型有效,以及如果我想創新一個新模型,我需要在代數、微積分或統計推斷的哪個層麵進行乾預和重構。書中對於某些經典算法的數學基礎部分,往往會追溯到更深層次的公理化體係,這迫使讀者去理解“為什麼”是這樣,而不是“是什麼”。這種自底嚮上的理解,使得知識不再是孤立的點,而是構成瞭一個相互關聯的網絡。即使麵對一個全新的、書上未曾提及的交叉學科問題,也能迅速定位到最相關的數學工具,並理解如何利用這些工具去推導齣一個閤理的數學模型。這種思維能力的躍升,纔是這本書帶給我最寶貴的財富。
评分一直想遇到的一本書,雖然對於數學基礎差的人還是有點難度,研究算法遇到不解的時候翻翻看還是有收獲的
评分讀過目錄,,這評論是假的吧?
评分內容全麵,邏輯清晰,適閤搞算法的時候隨手翻兩頁~
评分機器學習的數學 << 同濟版《高等數學》 + Lay 《綫性代數及其應用》 + 陳希孺《概率論與數理統計》。我不到30分鍾翻完瞭,你信?這類書籍就不要重復其他書籍裏的內容瞭,大雜燴也不全像豬肉白菜燉粉條那麼好吃
评分很詳細的一本機器學習數學書
相關圖書









本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有