

具体描述
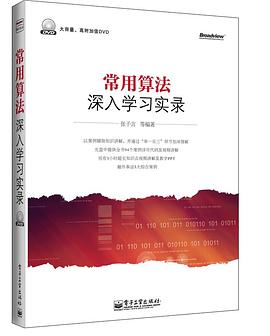
对于任何一门编程语言来说,算法都是程序的“灵魂”。正是因为算法如此重要,所以笔者精心编写了本书,希望通过书中的内容引领广大读者一起探讨学习算法的奥秘,带领广大读者真正步入程序开发的高级世界。
本书共分15章,循序渐进、由浅入深地详细讲解算法的核心内容,并通过具体实例的实现过程演练各个知识点的具体用法。本书首先详细讲解算法的基础知识,剖析了将算法称为“程序灵魂”的原因。然后详细讲解算法技术的核心内容,主要包括八大算法思想、数据结构、树、图、查找、内部排序、外部排序和文件等知识点的具体用法。接下来通过具体实例详细讲解各种算法经典问题的解决方案,主要包括解决经典的数据结构问题、解决数学问题、解决趣味问题、解决图像问题和解决奥赛问题的具体方案等。另外,书中还讲解了算法技术在现实编程项目中的作用和具体用法。
本书不但适合C语言的初学者学习,也适合有一定程序开发基础的读者阅读。对于有一定C/C++开发经验的读者来说,本书具有很高的参考价值。
作者简介
目录信息
1.1 开始学习算法 1
1.1.1 算法的特征和发展由来 1
1.1.2 何为算法 2
1.2 计算机中的算法 3
1.2.1 认识计算机中的算法 3
1.2.2 为什么是程序的“灵魂” 4
1.3 表示算法的方法 4
1.3.1 用流程图来表示算法 5
1.3.2 用N-S流程图来表示算法 6
1.3.3 用计算机语言表示算法 7
1.4 学好算法的秘诀 8
第2章 分析妙趣横生的算法思想 9
2.1 八大算法思想 9
2.2 比较“笨”的枚举算法思想 9
2.2.1 枚举算法基础 10
2.2.2 实践演练 10
2.3 聪明一点的递推算法思想 15
2.3.1 递推算法基础 15
2.3.2 实践演练 15
2.4 充分利用自己的递归算法思想 18
2.4.1 递归算法基础 18
2.4.2 实践演练 18
2.5 各个击破的分治算法思想 22
2.5.1 分治算法基础 23
2.5.2 实践演练 23
2.6 贪心算法思想并不贪婪 29
2.6.1 贪心算法基础 29
2.6.2 实践演练 30
2.7 试探法算法思想是一种委婉的做法 35
2.7.1 试探法算法基础 35
2.7.2 实践演练 36
2.8 迭代算法 39
2.8.1 迭代算法基础 40
2.8.2 实践演练 40
2.9 模拟算法思想 42
2.9.1 模拟算法的思路 42
2.9.2 实践演练 42
第3章 走在算法的路上之——分析简单的数据结构 47
3.1 学习编程的注意事项 47
3.2 什么是线性表 47
3.2.1 线性表的特性 48
3.2.2 顺序表操作 49
3.2.3 链表操作 60
3.3 守规矩的先进先出的队列 74
3.3.1 队列基础 74
3.3.2 链队列和循环队列 75
3.3.3 队列的基本操作 75
3.3.4 队列的链式存储 76
3.4 后进先出的栈 83
3.4.1 什么是栈 83
3.4.2 栈的基本分类 84
3.4.3 实践演练 87
第4章 走在算法的路上之——树 91
4.1 树引发的关系 91
4.1.1 树的概念 92
4.1.2 何谓二叉树 94
4.1.3 二叉树存储 96
4.1.4 操作二叉树 99
4.1.5 遍历二叉树 102
4.1.6 测试二叉树 106
4.1.7 线索二叉树 113
4.1.8 线索二叉树的表示 113
4.1.9 实践演练线索二叉树的操作 116
4.2 霍夫曼树 121
4.2.1 霍夫曼树基础 121
4.2.2 实践演练 123
第5章 走在算法的路上之——图 131
5.1 从哥尼斯堡七桥问题说起 131
5.2 几个相关概念 132
5.3 存储结构 136
5.3.1 表示顶点之间相邻关系的邻接矩阵 137
5.3.2 邻接表 138
5.3.3 合作的产物——十字链表 141
5.3.4 实践演练 143
5.4 遍历图 148
5.4.1 深度优先搜索 148
5.4.2 广度优先搜索 151
5.4.3 遍历算法的那点事 155
5.4.4 测试图的遍历实例 157
5.5 图的连通性 160
5.5.1 无向图的连通分量 161
5.5.2 最小生成树 161
5.5.3 关键路径 165
5.6 寻求最短的路径 170
5.6.1 求某一顶点到其他各顶点的最短路径 170
5.6.2 任意一对顶点间的最短路径 174
第6章 体验查找算法带来的魅力 179
6.1 几个相关概念 179
6.2 基于线性表的查找法 180
6.2.1 顺序查找法 180
6.2.2 折半查找法 183
6.2.3 分块查找法 186
6.3 基于树的查找 188
6.3.1 二叉排序树 188
6.3.2 平衡二叉排序树 203
6.4 哈希法 209
6.4.1 哈希法基础 209
6.4.2 处理冲突 211
6.4.3 哈希表的查找过程 212
6.5 索引查找 215
6.5.1 索引查找的过程 215
6.5.2 实践演练 215
第7章 内部排序 220
7.1 排序基础 220
7.1.1 排序的目的和过程 220
7.1.2 内部排序与外部排序 221
7.1.3 稳定排序与不稳定排序 221
7.2 霸道的插入排序 222
7.2.1 直接插入排序 222
7.2.2 折半插入排序 225
7.2.3 表插入排序 226
7.2.4 希尔排序 227
7.3 交换类排序法 230
7.3.1 冒泡排序(相邻比序法) 231
7.3.2 快速排序 232
7.4 选择类排序法 237
7.4.1 直接选择排序 237
7.4.2 树形选择排序 238
7.4.3 堆排序 239
7.4.4 实践演练 242
7.5 归并排序 245
7.5.1 归并排序思想 245
7.5.2 二路归并算法的思路 246
7.5.3 实现归并排序 248
7.5.4 实践演练 250
7.6 基数排序 253
7.6.1 多关键字排序 253
7.6.2 链式基数排序 254
第8章 外部排序和文件 258
8.1 外部信息方便了我们的生活 258
8.1.1 磁带存储器 258
8.1.2 磁盘存储器 259
8.2 外部排序的基本方法 261
8.2.1 磁盘排序 261
8.2.2 磁带排序 266
8.3 什么是文件 268
8.4 文件的组织方式 270
8.4.1 顺序文件 270
8.4.2 索引文件 270
8.4.3 ISAM文件 271
8.4.4 VSAM文件 273
8.4.5 散列文件 275
8.4.6 多关键字文件 275
第9章 从应聘开始谈算法 277
9.1 面试 277
9.1.1 面试前的准备 277
9.1.2 常见的面试错误 278
9.2 常见的算法笔试题 279
第10章 经典的数据结构问题 303
10.1 约瑟夫环 303
10.2 大整数运算 306
10.2.1 数组实现大整数运算 306
10.2.2 使用链表实现大整数运算 315
10.3 计算机进制转换 321
10.4 将中序表达式转换为后序表达式 325
第11章 解决数学问题 331
11.1 最大公约数和最小公倍数 331
11.2 哥德巴赫猜想 333
11.3 完全数 336
11.4 亲密数 338
11.5 自守数 340
11.6 方程求解 341
11.6.1 高斯消元法解方程组 342
11.6.2 用二分法解非线性方程 346
11.6.3 用牛顿迭代法解非线性方程 346
11.7 矩阵运算 348
11.8 一元多项式运算 352
11.8.1 一元多项式的加法运算 352
11.8.2 一元多项式的减法运算 357
第12章 解决趣味问题 366
12.1 歌星大奖赛 366
12.2 借书方案 367
12.3 打鱼还是晒网 368
12.4 捕鱼和分鱼 370
12.5 出售金鱼 371
12.6 平分七筐鱼 372
12.7 绳子的长度和井深 373
12.8 鸡兔同笼 375
12.9 汉诺塔 376
12.9.1 递归法 376
12.9.2 非递归法 378
12.10 马踏棋盘 380
12.10.1 使用循环查找法 380
12.10.2 使用递归法 384
12.10.3 使用栈方法 386
12.11 三色球问题 390
12.12 新郎和新娘问题 391
12.13 计算年龄几何 394
第13章 解决图像问题 395
13.1 八皇后问题 395
13.1.1 使用递归法 395
13.1.2 使用循环法 398
13.2 生命游戏 401
13.3 黑白棋问题 406
13.4 骑士迷宫问题 415
13.5 迷宫中的所有路径 422
第14章 算法的经典问题 425
14.1 存钱利息最大化 425
14.2 背包问题 428
14.2.1 使用动态规划法 429
14.2.2 使用递归法 434
14.3 农夫过河 437
14.4 三色旗 440
14.5 取石子 443
14.6 停车场管理 447
14.7 约瑟夫生者死者游戏 456
第15章 解决奥赛问题 459
15.1 孪生素数问题 459
15.2 百钱买百鸡问题 461
15.3 马克思手稿中的数学题 463
15.4 正整数分解为质因数 464
15.5 水仙花数 465
15.6 素数 466
15.6.1 求1000以内的所有素数 466
15.6.2 求1000以内的回文素数 467
15.6.3 求1000以内的平方回文数 469
15.7 阶乘 470
15.7.1 使用递归法 470
15.7.2 实现大数的阶乘 471
15.8 青蛙过河 477
15.9 过河卒 481
15.10 素数组合 484
15.11 校验码问题 487
15.12 老师排座位 488
15.13 模拟立体图 491
15.14 采药问题 495
15.15 等价表达式问题 497
15.16 购买年货问题 501
· · · · · · (收起)
读后感
用户评价
这本书绝对是我近期阅读过的最令人印象深刻的技术书籍之一。它以一种非常独特且深刻的方式,探讨了各种核心算法的设计理念与应用。作者的写作风格非常吸引人,他似乎能够洞察读者可能遇到的困惑,并提前给予解答。在讲解数据压缩算法时,书中不仅介绍了霍夫曼编码,更将其与信息论中的熵概念相结合,让我深刻理解了数据压缩的理论极限。随后,它进一步介绍了LZ系列算法,如LZ77和LZ78,并通过生动的比喻解释了它们如何利用重复模式进行编码,这让我对无损压缩有了更清晰的认识。我特别欣赏书中对于“算法的权衡”的讨论,比如时间与空间复杂度之间的取舍,以及在不同应用场景下,如何选择最合适的算法。在并发与并行算法的部分,作者深入剖析了多线程、多进程的原理,以及各种同步机制(如锁、信号量、条件变量)的使用,并通过实际的并发编程示例,展示了如何避免死锁、竞态条件等常见问题。这本书的价值在于,它不仅仅教授“如何做”,更重要的是教导“为什么这么做”,以及“如何做得更好”。它是一本真正能激发思考、提升解决问题能力的算法进阶读物。
评分这本书真是太让人惊喜了!我一直在寻找一本能真正帮助我理解算法背后原理的书,而不是仅仅罗列公式和代码。这本书完全超出了我的预期。它不仅仅是讲解了各种算法,更是深入剖析了它们的设计思想、适用场景以及优化技巧。作者用一种非常引人入胜的方式,将抽象的概念变得具体可感,仿佛亲眼见证了这些算法的诞生和演进。比如,在讲解图论算法时,它没有停留在Dijkstra或Floyd-Warshall的实现上,而是花了大量篇幅探讨图的表示方法,以及不同表示方法对算法效率的影响,让我恍然大悟。此外,书中还穿插了大量的实际案例,从现实世界的交通调度到网络路由,都巧妙地将算法应用其中,让我看到了算法的强大生命力。我尤其喜欢它在介绍回溯算法时,那种抽丝剥茧的讲解方式,一步步引导我理解如何构建搜索空间,如何剪枝,让我在解决复杂问题时不再感到无从下手。这本书的语言风格也非常棒,既有严谨的学术深度,又不失通俗易懂的趣味性,读起来一点都不会感到枯燥。我强烈推荐给所有对算法感兴趣的开发者、学生,以及任何希望提升自身解决问题能力的人。
评分读完这本书,我感觉自己像是经历了一场算法的“思想洗礼”。它不是那种堆砌代码、讲解API的“速成”读物,而是真正地带领读者走进算法的“内心世界”。作者在阐述数据结构时,并没有简单地给出定义和实现,而是深入挖掘了不同数据结构之间的内在联系,以及它们如何协同工作来解决复杂问题。例如,在讲解树结构时,它详细对比了二叉搜索树、平衡二叉搜索树(AVL、红黑树)以及B树等,不仅分析了它们的查找、插入、删除操作的时间复杂度,更重要的是解释了它们各自适用于什么样的数据访问模式和应用场景。我特别欣赏书中对于“为什么”的深入探讨,比如为什么需要平衡二叉搜索树?平衡的机制是如何工作的?它在实际应用中解决了哪些核心痛点?这些问题都得到了清晰且详尽的解答。读到动态规划部分,作者运用了大量的实例,从经典的背包问题到更复杂的路径规划,都一步步引导读者如何识别子问题、定义状态转移方程,直至最终得到最优解。这种层层递进的讲解方式,让我在理解复杂的动态规划问题时,思路变得无比清晰。这本书对于理解算法的“道”而非仅仅是“术”有着极其重要的意义,是一本不可多得的宝藏。
评分这本书的阅读体验简直是一种享受,它让我重新认识了算法的魅力。作者的叙述方式非常独特,充满了智慧和洞察力。他没有直接给出各种排序算法的实现,而是从“比较”和“交换”这两个最基本的元素出发,引导我们去思考“如何才能更快地把无序的数据变得有序”。这种从底层逻辑出发的讲解,让我对冒泡排序、选择排序、插入排序等基础排序算法有了更深层次的理解,也为之后理解更复杂的排序算法(如快速排序、归并排序)打下了坚实的基础。在讲解查找算法时,书中不仅介绍了顺序查找和二分查找,更深入地探讨了哈希表的原理,以及如何通过哈希函数和冲突解决机制来实现近乎常数时间的查找。我特别喜欢书中对于“数据结构与算法的关系”的阐述,它强调了两者是相辅相成的,选择合适的数据结构是设计高效算法的前提。这本书的逻辑结构也非常清晰,每一章都像是在为下一章铺垫,阅读过程中你会有一种“原来如此”的顿悟感。对于那些希望在算法领域有所建树的读者来说,这本书绝对是必备的读物,它能极大地开阔你的视野,提升你的思维层次。
评分这本书给我带来的最大感受是“豁然开朗”。我之前对某些算法一直有些模糊的概念,觉得它们很强大,但又不知道具体是怎么实现的,也无法灵活运用。这本书就像一位经验丰富的向导,带领我一步步走进算法的“殿堂”。它在介绍字符串匹配算法时,不仅仅是讲解了KMP算法,更是深入分析了朴素匹配算法的低效之处,然后引出如何通过预处理模式串来优化查找过程,这让我对KMP算法的“前缀函数”有了全新的理解,也明白了它为何能达到线性时间复杂度。在讲到图算法时,作者并没有局限于图的遍历,而是花了很大的篇幅来讲解最小生成树(Prim和Kruskal算法)以及最短路径问题(Dijkstra和Floyd-Warshall算法),并且详细分析了它们各自的时间复杂度以及适用条件。我尤其喜欢书中对于“贪心算法”的讲解,它不仅给出了很多经典的贪心应用场景,更重要的是,它引导读者去思考“为什么贪心策略在这种情况下是有效的”,以及如何证明贪心解的最优性。这本书的内容深度和广度都非常令人满意,让我觉得自己的算法功底得到了质的提升。
评分后编写的太不走心
评分后编写的太不走心
评分后编写的太不走心
评分后编写的太不走心
评分后编写的太不走心
相关图书







本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈图书下载中心 版权所有