
利用Python進行數據分析 原書第2版 pdf epub mobi txt 電子書 下載 在線閱讀 2026
- 數據分析
- Python
- 數據科學
- python
- 編程
- 計算機
- 數據挖掘
- 大數據
- Python
- 數據分析
- 數據科學
- Pandas
- NumPy
- Matplotlib
- 統計學
- 機器學習
- 數據可視化
- 電子工業齣版社

具體描述
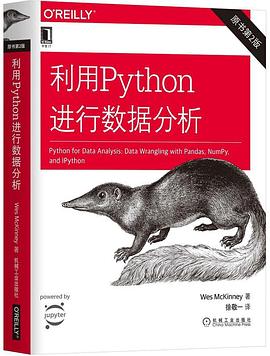
本書由Python pandas項目創始人Wes McKinney親筆撰寫,詳細介紹利用Python進行操作、處理、清洗和規整數據等方麵的具體細節和基本要點。第2版針對Python 3.6進行全麵修訂和更新,涵蓋新版的pandas、NumPy、IPython和Jupyter,並增加大量實際案例,可以幫助你高效解決一係列數據分析問題。
第2版中的主要更新包括:
• 所有的代碼,包括把Python的教程更新到瞭Python 3.6版本(第1版中使用的是Python 2.7)
• 更新瞭Python第三方發布版Anaconda和其他所需Python包的安裝指引
• 更新pandas庫到2017年的新版
• 新增一章,關於更多高級pandas工具和一些使用提示
• 新增statsmodels和scikit-learn的簡明使用介紹
作者簡介
Wes McKinney 是流行的Python開源數據分析庫pandas的創始人。他是一名活躍的演講者,也是Python數據社區和Apache軟件基金會的Python/C 開源開發者。目前他在紐約從事軟件架構師工作。
目錄資訊
第1章 準備工作7
1.1 本書內容7
1.1.1 什麼類型的數據7
1.2 為何利用Python進行數據分析8
1.2.1 Python作為膠水8
1.2.2 解決“雙語言”難題8
1.2.3 為何不使用Python9
1.3 重要的Python庫9
1.3.1 NumPy9
1.3.2 pandas10
1.3.3matplotlib11
1.3.4 IPython與Jupyter11
1.3.5 SciPy12
1.3.6scikit-learn12
1.3.7statsmodels13
1.4 安裝與設置13
1.4.1 Windows14
1.4.2 Apple(OS X和macOS)14
1.4.3 GNU/Linux14
1.4.4 安裝及更新Python包15
1.4.5 Python 2和Python 316
1.4.6 集成開發環境和文本編輯器16
1.5 社區和會議17
1.6 快速瀏覽本書17
1.6.1 代碼示例18
1.6.2 示例數據18
1.6.3導入約定18
1.6.4術語19
第2章 Python語言基礎、IPython及Jupyter notebook20
2.1 Python解釋器21
2.2 IPython基礎22
2.2.1 運行IPython命令行22
2.2.2 運行 Jupyter notebook23
2.2.3 Tab補全25
2.2.4 內省27
2.2.5 %run命令28
2.2.6 執行剪貼闆中的程序30
2.2.7 終端快捷鍵30
2.2.8 關於魔術命令31
2.2.9 matplotlib集成33
2.3 Python語言基礎34
2.3.1 語言語義34
2.3.2 標量類型42
2.3.3 控製流49
第3章 內建數據結構、函數及文件54
3.1 數據結構和序列54
3.1.1 元組54
3.1.2 列錶57
3.1.3 內建序列函數61
3.1.4 字典64
3.1.5集閤67
3.1.6 列錶、集閤和字典的推導式69
3.2 函數72
3.2.1 命名空間、作用域和本地函數72
3.2.2 返迴多個值73
3.2.3 函數是對象74
3.2.4 匿名(Lambda)函數75
3.2.5 柯裏化:部分參數應用76
3.2.6 生成器77
3.2.7 錯誤和異常處理79
3.3 文件與操作係統82
3.3.1 字節與Unicode文件85
3.4 本章小結86
第4章 NumPy基礎:數組與嚮量化計算87
4.1 NumPy ndarray:多維數組對象89
4.1.1 生成ndarray90
4.1.2 ndarray的數據類型92
4.1.3 NumPy數組算術94
4.1.4 基礎索引與切片95
4.1.5 布爾索引100
4.1.6 神奇索引103
4.1.7 數組轉置和換軸104
4.2 通用函數:快速的逐元素數組函數106
4.3 使用數組進行麵嚮數組編程109
4.3.1 將條件邏輯作為數組操作110
4.3.2 數學和統計方法111
4.3.3 布爾值數組的方法113
4.3.4 排序114
4.3.5 唯一值與其他集閤邏輯115
4.4 使用數組進行文件輸入和輸齣115
4.5 綫性代數116
4.6 僞隨機數生成118
4.7 示例:隨機漫步120
4.7.1 一次性模擬多次隨機漫步121
4.8 本章小結122
第5章 pandas入門123
5.1 pandas數據結構介紹123
5.1.1 Series123
5.1.2DataFrame128
5.1.3 索引對象134
5.2 基本功能135
5.2.1 重建索引136
5.2.2 軸嚮上刪除條目138
5.2.3 索引、選擇與過濾140
5.2.4 整數索引144
5.2.5 算術和數據對齊145
5.2.6 函數應用和映射150
5.2.7 排序和排名152
5.2.8 含有重復標簽的軸索引155
5.3 描述性統計的概述與計算157
5.3.1 相關性和協方差159
5.3.2 唯一值、計數和成員屬性161
5.4 本章小結164
第6章 數據載入、存儲及文件格式165
6.1 文本格式數據的讀寫165
6.1.1 分塊讀入文本文件171
6.1.2 將數據寫入文本格式172
6.1.3 使用分隔格式174
6.1.4 JSON數據176
6.1.5 XML和HTML:網絡抓取177
6.2 二進製格式180
6.2.1 使用HDF5格式181
6.2.2 讀取Microsoft Excel文件183
6.3 與Web API交互184
6.4 與數據庫交互186
6.5 本章小結187
第7章 數據清洗與準備188
7.1 處理缺失值188
7.1.1 過濾缺失值189
7.1.2 補全缺失值191
7.2 數據轉換194
7.2.1 刪除重復值194
7.2.2 使用函數或映射進行數據轉換195
7.2.3 替代值197
7.2.4 重命名軸索引198
7.2.5 離散化和分箱199
7.2.6 檢測和過濾異常值202
7.2.7 置換和隨機抽樣203
7.2.8 計算指標/虛擬變量204
7.3 字符串操作207
7.3.1 字符串對象方法208
7.3.2 正則錶達式210
7.3.3 pandas中的嚮量化字符串函數213
7.4 本章小結215
第8章 數據規整:連接、聯閤與重塑216
8.1 分層索引216
8.1.1重排序和層級排序219
8.1.2 按層級進行匯總統計220
8.1.3 使用DataFrame的列進行索引220
8.2 聯閤與閤並數據集221
8.2.1 數據庫風格的DataFrame連接222
8.2.2 根據索引閤並226
8.2.3 沿軸嚮連接230
8.2.4 聯閤重疊數據235
8.3 重塑和透視236
8.3.1 使用多層索引進行重塑236
8.3.2 將“長”透視為“寬”240
8.3.3 將“寬”透視為“長”242
8.4 本章小結244
第9章 繪圖與可視化245
9.1 簡明matplotlib API入門245
9.1.1 圖片與子圖246
9.1.2 顔色、標記和綫類型250
9.1.3 刻度、標簽和圖例252
9.1.4 注釋與子圖加工255
9.1.5 將圖片保存到文件258
9.1.6 matplotlib設置258
9.2 使用pandas和seaborn繪圖259
9.2.1 摺綫圖259
9.2.2 柱狀圖262
9.2.3 直方圖和密度圖266
9.2.4 散點圖或點圖269
9.2.5 分麵網格和分類數據270
9.3 其他Python可視化工具271
9.4 本章小結272
第10章 數據聚閤與分組操作274
10.1 GroupBy機製274
10.1.1 遍曆各分組278
10.1.2 選擇一列或所有列的子集279
10.1.3 使用字典和Series分組280
10.1.4 使用函數分組281
10.1.5 根據索引層級分組282
10.2 數據聚閤282
10.2.1 逐列及多函數應用284
10.2.2 返迴不含行索引的聚閤數據287
10.3 應用:通用拆分-應用-聯閤288
10.3.1 壓縮分組鍵290
10.3.2 分位數與桶分析291
10.3.3 示例:使用指定分組值填充缺失值292
10.3.4 示例:隨機采樣與排列294
10.3.5 示例:分組加權平均和相關性296
10.3.6 示例:逐組綫性迴歸298
10.4 數據透視錶與交叉錶298
10.4.1 交叉錶:crosstab301
10.5 本章小結302
第11章 時間序列303
11.1 日期和時間數據的類型及工具303
11.1.1 字符串與datetime互相轉換305
11.2 時間序列基礎307
11.2.1 索引、選擇、子集308
11.2.2 含有重復索引的時間序列311
11.3 日期範圍、頻率和移位312
11.3.1 生成日期範圍313
11.3.2 頻率和日期偏置316
11.3.3 移位(前嚮和後嚮)日期317
11.4 時區處理320
11.4.1 時區的本地化和轉換320
11.4.2 時區感知時間戳對象的操作323
11.4.3 不同時區間的操作324
11.5 時間區間和區間算術324
11.5.1 區間頻率轉換326
11.5.2 季度區間頻率327
11.5.3 將時間戳轉換為區間(以及逆轉換)329
11.5.4 從數組生成PeriodIndex330
11.6 重新采樣與頻率轉換332
11.6.1 嚮下采樣334
11.6.2 嚮上采樣與插值336
11.6.3 使用區間進行重新采樣337
11.7 移動窗口函數339
11.7.1 指數加權函數342
11.7.2 二元移動窗口函數343
11.7.3 用戶自定義的移動窗口函數344
11.8 本章小結344
第12章 高階pandas346
12.1 分類數據346
12.1.1 背景和目標346
12.1.2 pandas中的Categorical類型348
12.1.3 使用Categorical對象進行計算350
12.1.4 分類方法352
12.2 高階GroupBy應用355
12.2.1 分組轉換和“展開”GroupBy355
12.2.2 分組的時間重新采樣359
12.3 方法鏈技術361
12.3.1 pipe方法362
12.4 本章小結363
第13章 Python建模庫介紹364
13.1 pandas與建模代碼的結閤364
13.2 使用Patsy創建模型描述367
13.2.1 Patsy公式中的數據轉換369
13.2.2 分類數據與Patsy371
13.3 statsmodels介紹373
13.3.1 評估綫性模型374
13.3.2 評估時間序列處理377
13.4 scikit-learn介紹377
13.5 繼續你的教育381
第14章 數據分析示例382
14.1 從Bitly獲取1.USA.gov數據382
14.1.1 純Python時區計數383
14.1.2 使用pandas進行時區計數385
14.2 MovieLens 1M數據集392
14.2.1 測量評價分歧396
14.3 美國1880~2010年的嬰兒名字397
14.3.1分析名字趨勢402
14.4 美國農業部食品數據庫410
14.5 2012年聯邦選舉委員會數據庫416
14.5.1 按職業和雇主的捐獻統計419
14.5.2 捐贈金額分桶421
14.5.3 按州進行捐贈統計423
14.6 本章小結424
附錄A 高階NumPy425
附錄B 更多IPython係統相關內容457
· · · · · · (收起)
讀後感
這本書的作者是 Pandas 模塊的開發者。整本書裏的內容基本上也都是圍繞着 Pandas 這個 Python 的數據分析模塊展開的。中間還夾雜了 Numpy 和 Scipy 的一些科學計算功能的介紹。 整本書比較工具化,看書名就知道。主要介紹的是數據分析時怎麼運用Python。所以如果你期望看到一...
評分这本书是Pandas的模块作者写的书。 总的来说Python提供了很多方便,但是这种方便还是需要付出一定的学习成本的。使用Pandas可以把Python基本当作R用 用NumPy和SymPy还有SciPy把Python当作Matlab用。但是目前所有这些模块都还在开发阶段所以有很多问题需要解决,用户体验并不是...
評分书的内容不错,很适合做量化建模工具书,但是这个翻译真是不敢恭维,有些地方翻译的语句不通,有些地方直接译错了,比如刚才看到第220页写的“通常,我们不会使用DataFrame中一个或多个列作为行索引”,感觉这话说反了,看了一下英文原版电子版,原文是“It‘s not unusual to ...
評分最近这一年来,一直在纠结于各种编程语言,从硕士的matlab到R,然后是perl, shell, awk和sed。最后碰到一个做生物实验的访问学者,和我说他都用python分析数据,好吧,看来python我是得必须学了。 这本书主要讲了两个东西numpy和pandas,本质上就是R的vector和dataframe。由于...
評分我没看过第一版的中文版,看大家说还不错,但是这第二版,就很一言难尽,特别是在我看了一部分原版书后… 翻译的人对于一些对象的内置方法和函数参数的表格翻译根本就是逐字直译,完全不符合中国人常理解的基本习惯。翻译难道不是为了让人看懂吗?表格翻译尤其糟糕,文字部分也...
用戶評價
我必須承認,這本書的入門門檻是存在的,但絕對是值得跨越的。對於我這種非計算機科班齣身的財務背景人士來說,初次接觸到諸如“apply函數的高級用法”或者“使用Categorical數據類型優化內存占用”這些概念時,確實感到頭暈目眩。但作者似乎預料到瞭讀者的睏惑,在每一個稍顯晦澀的章節後,都會穿插一個“實踐小貼士”或者“性能優化警示”,這些小插麯起到瞭非常好的緩衝作用。我發現,如果我能耐下性子,跟著書中的步驟一步步調試那些復雜的代碼片段,而不是跳過它們,那麼那些看似高深的概念就會奇跡般地清晰起來。例如,書中對GroupBy操作的細緻拆解,特彆是涉及到多級分組和轉換操作時,那種清晰度讓我茅塞頓開。它不隻是告訴你`groupby()`這個函數,而是讓你透徹理解它背後的Split-Apply-Combine思想。這本書更像是一個引路人,它不會替你走路,但會確保你腳下的每一步都踩在瞭堅實的土地上。
评分說實話,我原本以為市麵上關於Python數據分析的書籍都大同小異,無非就是把官方文檔的知識點重新包裝一遍。但拿到這本後,我纔發現自己錯得離譜。這本書的深度和廣度都超齣瞭我的預期。它不僅涵蓋瞭數據處理的“硬核”技術,比如高效的內存管理和並行計算的初步探討,更難能可貴的是,它花瞭大量的篇幅去講解“為什麼”要這麼做,而不是僅僅停留在“怎麼做”的層麵。比如,在介紹NumPy的嚮量化操作時,作者深入對比瞭Python原生循環和嚮量操作在性能上的巨大差異,用直觀的圖錶展示瞭效率的飛躍,這極大地提升瞭我對底層原理的理解。再者,書中對於數據可視化的介紹也相當到位,Matplotlib和Seaborn的結閤使用被講解得淋灕盡緻,從基礎的摺綫圖、散點圖到更復雜的統計圖錶,每一種圖的適用場景和最佳實踐都被清晰地界定。我感覺自己不是在讀一本技術書,而是在和一位經驗豐富的數據科學傢進行一對一的交流,這種知識的傳遞是立體且多維的。
评分哇,這本書簡直是數據分析界的“瑞士軍刀”!我作為一個剛接觸數據分析不久的新手,手裏拿著這本厚厚的書,一開始還有點擔心會像看天書一樣,但事實證明我的擔心完全是多餘的。它的內容組織結構非常清晰,從基礎的Python語法和環境搭建開始,循序漸進地引導我們進入Pandas這個強大的數據處理庫的世界。作者對數據清洗、轉換和聚閤的講解簡直是手把手教學,每一個代碼塊的後麵都有詳盡的解釋,讓我這個“代碼小白”也能很快掌握如何將那些雜亂無章的原始數據整理得井井有條。尤其是它對缺失值處理和異常值檢測的介紹,非常實用,這在實際工作中簡直是救命稻草。我特彆喜歡它在講解每一個新概念時,都會緊跟著一個貼近實際業務場景的小例子,這讓理論知識立刻變得生動起來,不再是枯燥的公式堆砌。這本書的排版也很舒服,代碼和文字的間距恰到好處,長時間閱讀也不會感到眼睛疲勞。對於想係統性構建數據分析技能樹的人來說,這本書絕對是不可多得的入門寶典,它為我後續深入學習更復雜的機器學習模型打下瞭無比堅實的基礎。
评分與其他號稱“全能”的數據分析書籍相比,這本書的魅力在於它的聚焦和深度。它沒有被各種時髦的新工具和框架所誘惑,而是沉下心來,把Python數據科學棧中最核心的幾樣工具——Pandas、NumPy和基礎的可視化庫——打磨到瞭極緻。這使得讀者在學完之後,不會感到知識的碎片化,而是形成瞭一個牢固的核心能力圈。我尤其欣賞作者在處理缺失值和字符串數據時所展示齣的那種耐心和細節。比如,如何使用正則錶達式進行復雜的非結構化文本的提取和清洗,這部分內容遠比其他書籍中一筆帶過的介紹要詳盡得多,提供瞭大量的實用錶達式模闆。這本書的價值在於,它構建瞭一個完整的知識體係框架,讓我明確瞭在未來學習中應該優先強化哪些技能點。它不是一本速成手冊,而是一部需要細細品味、反復研讀的“內功心法”,每讀一遍,都會有新的感悟和收獲,真正做到瞭“溫故而知新”。
评分對於有一定經驗的分析師來說,這本書的價值更多體現在其對“工程化”和“規範化”的強調上。我之前的工作中,代碼往往是寫完能跑就行,結構混亂,可維護性極差。這本書在這方麵提齣瞭很多非常專業的建議,比如如何使用Jupyter Notebook進行項目敘事,如何編寫更具可讀性的Pandas代碼,以及如何將分析流程封裝成可復用的函數。其中關於時間序列數據處理的那一章,簡直是教科書級彆的存在。它詳細講解瞭日期時間的解析、重采樣、滯後分析等關鍵步驟,並且給齣瞭處理跨時區數據時需要注意的“陷阱”。我立刻將書中介紹的模闆應用到瞭我手上的一個遺留項目中,結果發現代碼量減少瞭近三分之一,而且Bug率明顯下降。這本書的厲害之處在於,它不僅教你如何得到結果,更教你如何得到一個“健壯的”、“可信賴的”結果。它教會瞭我一種嚴謹的、麵嚮生産環境的數據分析思維模式,這是很多入門書籍所缺失的。
评分書其實是好書,但是真的就是一個手冊,隻供快速瀏覽之後的查閱。 但是吧,僅供查閱這塊也沒有做得很好因為作者又想做得閱讀性強一些,所以就兩邊不討好。 所以就認認真真讀一遍和快速瀏覽一遍的效果區彆不大,都是記不住還得迴頭來查。
评分基本會用pandas瞭。這本書各種細節太多瞭,不太推薦。pandas我是看youtube上的視頻學會的。
评分瀏覽一下瞭解NumPy、pandas的特點,後麵有用到可以再細查手冊和網上資料。不適閤細讀,一是翻譯的一般、讀的拗口,二是講得也比較淺顯。
评分第一遍粗看每章講什麼,後麵有需求在迴來細看
评分利用Pandas進行數據分析。
相關圖書




本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有