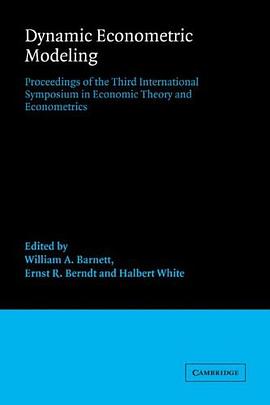
This book brings together presentations of some of the fundamental new research that has begun to appear in the areas of dynamic structural modeling, nonlinear structural modeling, time series modeling, nonparametric inference, and chaotic attractor inference. The contents of this volume comprise the proceedings of the third of a conference series entitled International Symposia in Economic Theory and Econometrics. This conference was held at the IC;s2 (Innovation, Creativity and Capital) Institute at the University of Texas at Austin on May 22-23, l986.
《时序建模与预测:从理论到实践》 一、 导论:理解动态世界的基石 在当今这个信息爆炸、瞬息万变的时代,对经济现象的深入理解和精准预测变得前所未有的重要。无论是政府制定宏观经济政策,企业进行战略规划,还是投资者把握市场脉搏,都离不开对经济变量随时间演变的深刻洞察。传统的静态分析模型往往难以捕捉经济运行的内在动态性、复杂性和非线性特征,因此,发展和运用能够反映经济系统随时间变化的动态模型,已成为现代经济学研究的核心议题之一。 《时序建模与预测:从理论到实践》一书,正是应这一时代需求而生,旨在为读者构建一个全面、深入且具备实际操作指导意义的时序分析框架。本书并非简单罗列各种模型和技术,而是着力于揭示这些方法背后蕴含的经济学思想、统计学原理以及数据处理技巧。我们希望通过严谨的理论阐释与丰富的实证案例相结合,引导读者掌握从理解经济现象的动态规律,到构建恰当的模型,再到进行准确预测的完整过程。 本书的内容涵盖了从基础的时序数据特性分析,到经典的线性模型,再到更为复杂的非线性模型和机器学习在时序分析中的应用。我们力求使内容既有学术的深度,又不乏实践的指导性,帮助读者克服在实际应用中可能遇到的各种挑战。本书的适用读者范围广泛,包括但不限于经济学、金融学、统计学、管理学等相关领域的学生、研究人员、从业者以及对经济数据分析感兴趣的公众。我们相信,通过本书的学习,读者将能够提升分析和预测经济变量的能力,从而在各自的领域做出更明智的决策。 二、 时序数据基础:洞察时间序列的语言 任何有效的时序建模都始于对数据本身的深入理解。时序数据,顾名思义,是按照时间顺序收集和排列的数据点集合。与横截面数据不同,时序数据中的观测值之间存在着内在的依赖关系,即“过去”的事件或状态会影响“现在”和“未来”的观测值。理解这种时间依赖性是构建有效模型的第一步。 本书的第一部分将详细探讨时序数据的基本特征。我们将从描述性统计入手,介绍如何计算均值、方差、自协方差和自相关系数,并通过图示(如自相关函数图 ACF 和偏自相关函数图 PACF)来直观地识别数据的平稳性、季节性、趋势性以及周期性。 平稳性:平稳性是许多经典时序模型的基本假设。我们将阐述严平稳和弱平稳的概念,以及如何通过单位根检验(如 ADF 检验、PP 检验)来判断序列的平稳性。对于非平稳序列,本书将介绍差分、对数变换等常用的处理方法,以使其满足模型的平稳性要求。 趋势与季节性:经济变量常常表现出明显的上升或下降趋势,以及周期性的季节波动。我们将讨论如何通过分解方法(如加法模型、乘法模型)来分离出趋势、季节和残差成分,并介绍如何利用趋势和季节调整技术来处理这些特征。 自相关与偏自相关:自相关函数(ACF)衡量了序列在不同滞后下的线性相关程度,而偏自相关函数(PACF)则衡量了在排除了中间滞后项的影响后,序列与其自身在某一滞后下的相关程度。我们将深入分析 ACF 和 PACF 图的解读方法,它们是识别 ARIMA 类模型阶数的重要依据。 异方差性:在许多经济和金融时间序列中,误差项的方差会随时间变化,即存在异方差性。这将影响模型的效率和统计推断的有效性。本书将介绍检测异方差性的方法,如图示法、LM 检验,并为后续介绍 GARCH 等模型打下基础。 结构性断点:经济系统中可能发生突发的事件,导致变量的统计特性发生改变,即存在结构性断点。我们将探讨如何识别和处理结构性断点,以及它们对模型选择和预测的影响。 通过对这些基本概念的深入理解和熟练掌握,读者将能够初步判断数据的性质,为后续的模型选择和构建奠定坚实的基础。 三、 经典线性时序模型:时间序列分析的基石 在理解了时序数据的基本特性后,我们将进入经典线性时序模型的学习。这些模型是时序分析的基石,理解它们对于掌握更复杂的模型至关重要。本书将系统介绍最常用且理论完备的线性模型,并强调其在经济分析中的应用。 ARIMA 模型族:自回归移动平均 (ARIMA) 模型是处理平稳时间序列最经典和广泛应用的工具。 AR(p) 模型:自回归模型假设当前观测值是过去 p 个观测值的线性组合,加上一个随机误差项。我们将详细阐述 AR(p) 模型的构建、参数估计(如 Yule-Walker 方程、最大似然估计)以及模型诊断。 MA(q) 模型:移动平均模型假设当前观测值是过去 q 个误差项的线性组合,加上一个随机误差项。我们将讨论 MA(q) 模型的特性,并与 AR(p) 模型进行对比。 ARMA(p,q) 模型:ARMA 模型结合了 AR 和 MA 部分,能够更灵活地描述序列的动态。我们将阐述 ARMA 模型的特点,以及如何通过信息准则(如 AIC、BIC)来选择最优的 p 和 q 阶数。 ARIMA(p,d,q) 模型:对于非平稳时间序列,ARIMA 模型通过 d 阶差分将其转化为平稳序列,然后应用 ARMA 模型。本书将重点讲解差分操作的原理和效果,以及如何通过单位根检验和 ACF/PACF 图来确定 d 的值。 季节性 ARIMA (SARIMA) 模型:许多经济数据表现出明显的季节性模式。SARIMA 模型是对 ARIMA 模型的扩展,能够同时捕捉非季节性和季节性模式。我们将详细介绍 SARIMA 模型的结构,包括季节性 AR、MA 和差分项,以及如何进行模型识别和参数估计。 因果关系与协整:当分析多个经济变量的时间序列时,我们不仅关心每个变量自身的动态,还关心它们之间的相互影响。 格兰杰因果检验:我们将介绍格兰杰因果检验,用以判断一个时间序列是否能够“格兰杰”地预测另一个时间序列,揭示变量之间的动态预测关系。 向量自回归 (VAR) 模型:VAR 模型是处理多个相关时间序列的强大工具,它将每个变量都视为所有变量的滞后值的函数。我们将阐述 VAR 模型的构建、估计、模型检验(如残差分析、稳定性检验)以及脉冲响应函数(IRF)和方差分解的应用,用于分析经济冲击的传导效应。 协整理论:当两个或多个非平稳的时间序列具有长期稳定的均衡关系时,它们就被认为是协整的。我们将引入协整的概念,讲解恩格尔-格兰杰两步法和约翰森检验,以及向量误差修正模型 (VECM),用以分析具有长期均衡关系的经济变量。 通过对这些经典模型的深入学习,读者将能够理解时间序列建模的基本思想,并掌握分析和预测单变量及多变量经济系统的基本方法。 四、 波动率建模与预测:金融时间序列的特殊性 金融市场的时间序列,除了具有时序性之外,还表现出一些独特的属性,最显著的就是“波动率聚集”(Volatility Clustering)现象,即大的价格变动倾向于与大的变动相伴,小的价格变动倾向于与小的变动相伴。这意味着误差项的方差不是恒定的,存在明显的异方差性。因此,专门的波动率模型对于金融时间序列的分析和预测至关重要。 本书将专门辟出一章,系统介绍各类波动率模型及其应用。 ARCH 模型:自回归条件异方差 (ARCH) 模型由 Engle 提出,它将当前时期的条件方差建模为过去误差平方项的函数。我们将详细阐述 ARCH(q) 模型的形式、参数估计(如最大似然估计)以及模型选择。 GARCH 模型:广义自回归条件异方差 (GARCH) 模型由 Bollerslev 提出,它是 ARCH 模型的扩展,通过引入过去条件方差的滞后项,能够更有效地捕捉波动率的持续性。我们将深入分析 GARCH(p,q) 模型的数学形式,讨论其参数的解释,并讲解如何进行模型拟合和诊断。 EGARCH、GJR-GARCH 等改进模型:现实中的波动率可能受到正负冲击不对称的影响(即“杠杆效应”)。我们将介绍 EGARCH(指数 GARCH)和 GJR-GARCH(Glosten-Jagannathan-Runkle GARCH)等模型,它们能够更好地捕捉这种非对称性。 波动率预测的应用:本书将重点讲解如何利用这些模型进行波动率预测,并阐述波动率预测在风险管理(如 Value-at-Risk, VaR)、期权定价等领域的广泛应用。通过实际案例,读者将学会如何为金融资产构建可靠的波动率预测模型。 五、 现代时序分析方法:拓展模型的边界 随着计算能力的提升和数据量的增大,传统的线性模型可能不足以捕捉经济系统中的复杂非线性动态。本书的最后部分将介绍一些现代的时序分析方法,这些方法在处理更复杂的问题时表现出更强的能力。 状态空间模型与卡尔曼滤波:状态空间模型提供了一种灵活的框架来描述动态系统,其中系统的状态是不可观测的,但可以通过观测值进行推断。卡尔曼滤波是估计状态空间模型中不可观测状态的最优线性滤波器。我们将介绍状态空间模型的构建,卡尔曼滤波器的原理和应用,以及它在处理具有测量误差或潜在状态的经济变量时的优势。 非线性时序模型: 门限自回归 (TAR) 模型:TAR 模型允许模型的系数在达到某个门限值时发生改变,从而捕捉经济系统的分段非线性行为。 平滑时间序列模型(如 STAR 模型):STAR 模型通过平滑函数来描述变量之间的非线性关系,能够捕捉比 TAR 模型更平滑的非线性动态。 马尔可夫切换模型 (MSM):MSM 假设系统可能在不同的“状态”之间切换,每个状态都有其自身的动态方程。我们将介绍 MSM 的基本思想,以及如何估计模型并判断状态的切换。 机器学习在时序分析中的应用: 用于特征工程:如何利用滞后变量、滚动统计量等来为机器学习模型构建有效的时序特征。 预测模型:介绍如何将传统的机器学习算法(如支持向量机 SVM、随机森林 Random Forest、梯度提升树 Gradient Boosting)应用于时序预测任务,以及它们在处理高维和非线性数据方面的优势。 深度学习模型:简要介绍循环神经网络 (RNN) 及其变种(如 LSTM、GRU)在时序预测中的应用,重点阐述它们捕捉长程依赖关系的能力。 模型选择与评估:在应用了各种模型之后,如何科学地选择最优模型并对其预测性能进行评估至关重要。我们将详细介绍模型选择准则(如 AIC、BIC、HQIC),以及交叉验证、回测等模型评估技术,确保模型具有良好的泛化能力和预测精度。 六、 结论:走向精准预测的未来 《时序建模与预测:从理论到实践》一书,旨在提供一个系统、全面且实用的时序分析学习指南。我们从时序数据的基本特征出发,逐步深入到经典的线性模型,再拓展到处理金融市场特性的波动率模型,最后引入了现代的非线性与机器学习方法。 本书始终强调理论与实践的结合,通过丰富的案例分析,帮助读者将所学知识应用于解决真实的经济问题。我们相信,掌握了本书所介绍的时序分析工具和方法,读者将能够更深刻地理解经济系统的动态运行规律,更准确地预测未来走向,从而在复杂多变的经济环境中做出更明智的决策。 在未来,随着数据科学和计算技术的不断发展,时序分析领域还将涌现出更多新的理论和方法。本书旨在为您打下坚实的基础,使您能够不断学习和适应这些新的发展,在时序建模与预测的道路上不断前行。