
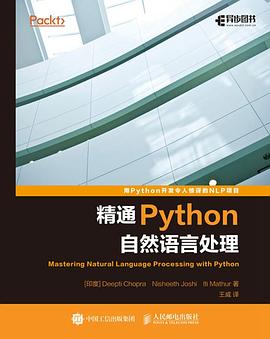

具体描述
自然语言处理是计算语言学和人工智能之中与人机交互相关的领域之一。
本书是学习自然语言处理的一本综合学习指南,介绍了如何用Python实现各种NLP任务,以帮助读者创建基于真实生活应用的项目。全书共10章,分别涉及字符串操作、统计语言建模、形态学、词性标注、语法解析、语义分析、情感分析、信息检索、语篇分析和NLP系统评估等主题。
本书适合熟悉Python语言并对自然语言处理开发有一定了解和兴趣的读者阅读参考。
作者简介
目录信息
1.1切分1
1.1.1将文本切分为语句2
1.1.2其他语言文本的切分2
1.1.3将句子切分为单词3
1.1.4使用TreebankWordTokenizer执行切分4
1.1.5使用正则表达式实现切分5
1.2标准化8
1.2.1消除标点符号8
1.2.2文本的大小写转换9
1.2.3处理停止词9
1.2.4计算英语中的停止词10
1.3替换和校正标识符11
1.3.1使用正则表达式替换单词11
1.3.2用另一个文本替换文本的示例12
1.3.3在执行切分前先执行替换操作12
1.3.4处理重复字符13
1.3.5去除重复字符的示例13
1.3.6用单词的同义词替换14
1.3.7用单词的同义词替换的示例15
1.4在文本上应用Zipf定律15
1.5相似性度量16
1.5.1使用编辑距离算法执行相似性度量16
1.5.2使用Jaccard系数执行相似性度量18
1.5.3使用Smith Waterman距离算法执行相似性度量19
1.5.4其他字符串相似性度量19
1.6小结20
第2章统计语言建模21
2.1理解单词频率21
2.1.1为给定的文本开发MLE25
2.1.2隐马尔科夫模型估计32
2.2在MLE模型上应用平滑34
2.2.1加法平滑34
2.2.2Good Turing平滑35
2.2.3Kneser Ney平滑40
2.2.4Witten Bell平滑41
2.3为MLE开发一个回退机制41
2.4应用数据的插值以便获取混合搭配42
2.5通过复杂度来评估语言模型42
2.6在语言建模中应用Metropolis—Hastings算法43
2.7在语言处理中应用Gibbs采样法43
2.8小结46
第3章形态学:在实践中学习47
3.1形态学简介47
3.2理解词干提取器48
3.3理解词形还原51
3.4为非英文语言开发词干提取器52
3.5形态分析器54
3.6形态生成器56
3.7搜索引擎56
3.8小结61
第4章词性标注:单词识别62
4.1词性标注简介62
默认标注67
4.2创建词性标注语料库68
4.3选择一种机器学习算法70
4.4涉及n—gram的统计建模72
4.5使用词性标注语料库开发分块器78
4.6小结80
第5章语法解析:分析训练资料81
5.1语法解析简介81
5.2Treebank建设82
5.3从Treebank提取上下文无关文法规则87
5.4从CFG创建概率上下文无关文法93
5.5CYK线图解析算法94
5.6Earley线图解析算法96
5.7小结102
第6章语义分析:意义很重要103
6.1语义分析简介103
6.1.1NER简介107
6.1.2使用隐马尔科夫模型的NER系统111
6.1.3使用机器学习工具包训练NER117
6.1.4使用词性标注执行NER117
6.2使用Wordnet生成同义词集id119
6.3使用Wordnet进行词义消歧122
6.4小结127
第7章情感分析:我很快乐128
7.1情感分析简介128
7.1.1使用NER执行情感分析134
7.1.2使用机器学习执行情感分析134
7.1.3NER系统的评估141
7.2小结159
第8章信息检索:访问信息160
8.1信息检索简介160
8.1.1停止词删除161
8.1.2使用向量空间模型进行信息检索163
8.2向量空间评分及查询操作符关联170
8.3使用隐性语义索引开发IR系统173
8.4文本摘要174
8.5问答系统176
8.6小结177
第9章语篇分析:理解才是可信的178
9.1语篇分析简介178
9.1.1使用中心理论执行语篇分析183
9.1.2指代消解184
9.2小结188
第10章NLP系统评估:性能分析189
10.1NLP系统评估要点189
10.1.1NLP工具的评估(词性标注器、词干提取器及形态分析器)190
10.1.2使用黄金数据执行解析器评估200
10.2IR系统的评估201
10.3错误识别指标202
10.4基于词汇搭配的指标202
10.5基于句法匹配的指标207
10.6使用浅层语义匹配的指标207
10.7小结208
· · · · · · (收起)
读后感
用户评价
作为一名对人工智能领域充满兴趣的学习者,我一直在寻找一本能够深入浅出地介绍自然语言处理的书籍。这本书无疑是我的首选。作者的讲解非常生动有趣,他用充满智慧的语言,将NLP的复杂概念娓娓道来,让我如沐春风。我特别喜欢书中关于文本摘要的章节,它详细介绍了抽取式摘要和生成式摘要的区别,并提供了相应的Python实现。我尝试用书中提供的代码来生成一些新闻文章的摘要,结果非常令人满意,这让我看到了NLP技术在信息获取和知识管理方面的巨大潜力。此外,书中对对话系统和问答系统的讲解也让我印象深刻,它展示了如何利用NLP技术来构建能够与人类进行自然交流的智能助手。虽然这些部分的实现更加复杂,但作者的讲解非常透彻,让我能够逐步理解其背后的逻辑。这本书不仅提升了我的技术能力,更重要的是激发了我对人工智能领域更深层次的探索欲。
评分这本书给我最大的启发在于,它让我看到了NLP技术在解决现实世界问题时的强大能力。作者通过一系列精心设计的案例研究,将NLP的理论知识与实际应用巧妙地结合起来,让我对NLP的价值有了更直观的认识。我特别喜欢书中关于垃圾邮件过滤的章节,它详细讲解了如何利用文本分类技术来识别和过滤垃圾邮件,并提供了相应的Python实现。我尝试用书中提供的代码来构建一个简单的垃圾邮件过滤器,结果非常准确,这让我对NLP在安全领域的应用有了更深的认识。此外,书中对机器翻译和文本摘要的讲解也让我印象深刻,它展示了如何利用NLP技术来打破语言障碍,并提高信息传播的效率。虽然这些部分的实现更加复杂,但作者的讲解非常透彻,让我能够逐步理解其背后的逻辑。这本书不仅仅是一本技术书籍,更是一次充满启发的学习旅程,让我感受到了NLP技术在改变世界方面的巨大潜力。
评分这本书的价值在于它不仅提供了扎实的NLP理论基础,更重要的是教会了如何将这些理论转化为可执行的代码,并在实际项目中落地。作者的编程风格清晰明了,代码注释详尽,让我能够快速上手并进行修改和扩展。我特别喜欢书中关于信息检索的章节,它详细讲解了TF-IDF、BM25等经典算法,并提供了使用Python实现的示例。我尝试用书中提供的代码来构建一个简单的搜索引擎,能够对大量的文档进行高效的检索,这让我对信息检索的原理有了更深刻的理解。此外,书中对序列标注(Sequence Labeling)任务,如命名实体识别(NER)和词性标注(POS Tagging)的讲解也让我受益匪浅。它不仅介绍了传统的CRF模型,还深入探讨了如何利用深度学习模型来实现这些任务,并提供了相应的代码实现。这本书让我能够将NLP技术更有效地应用于实际工作中,解决更复杂的问题,并且对于我未来的职业发展也起到了重要的推动作用。
评分这本书给我带来的最大价值在于,它让我看到了NLP技术背后蕴含的巨大潜力和应用前景。作者并非仅仅堆砌概念和代码,而是将NLP技术巧妙地融入到各种引人入胜的案例研究中。我特别喜欢关于情感分析的章节,书中不仅讲解了如何构建情感词典,还介绍了如何利用机器学习模型进行情感倾向的预测,并且针对不同类型的文本(如电影评论、社交媒体帖子)提供了相应的解决方案。我尝试用书中的方法对一些网上商品的评论进行情感分析,并根据分析结果为用户推荐更适合的商品,这个过程让我体验到了NLP技术在商业应用中的强大威力。此外,书中对自然语言生成(NLG)的讲解也让我耳目一新,它展示了如何利用NLP技术来自动撰写新闻报道、生成产品描述,甚至创作诗歌。虽然NLG部分的代码实现相对复杂,但作者的讲解非常细致,让我能够逐步理解其背后的逻辑。这本书让我不仅仅满足于理解NLP,更激发了我去探索如何利用NLP来创造价值,实现更多的可能性。
评分我一直对人类语言的复杂性和计算机如何理解它感到好奇,而这本书正是满足了我这种好奇心的绝佳读物。它以一种非常直观的方式,将NLP的核心概念通过Python代码呈现出来。我特别欣赏作者在讲解词向量时,没有直接丢给我一堆复杂的数学公式,而是循序渐进地解释了Word2Vec、GloVe等模型是如何工作的,以及它们在捕捉词语语义关系方面的强大能力。书中的例子都非常贴切,比如用词向量来展示“国王 - 男人 + 女人 ≈ 王后”这样的类比关系,让我瞬间理解了词向量的精髓。更重要的是,这本书让我学会了如何使用现有的Python库,如NLTK、spaCy和gensim,来完成各种NLP任务。我用spaCy轻松地进行了命名实体识别,从一段新闻报道中提取出了人名、地名和组织机构名,这在以前是我无法想象的。书中的案例研究部分更是让我大开眼界,它展示了如何利用NLP技术来构建智能客服、分析用户评论、甚至是生成文本。我尝试着复现了一个简单的文本生成器,能够根据输入的几个词生成一段通顺的句子,虽然结果还有待完善,但这个过程本身就充满了乐趣和成就感。这本书不仅提升了我的技术能力,更重要的是激发了我对NLP更深层次的探索欲。
评分我之前接触过一些NLP方面的资料,但总感觉零散且不成体系。这本书就像一座灯塔,为我指明了方向,让我能够系统地学习和掌握NLP的核心知识。作者的讲解方式非常独特,他善于将复杂的概念用简单易懂的语言解释清楚,并且通过大量的代码示例来巩固理解。我尤其欣赏书中关于词嵌入(Word Embedding)的章节,作者不仅仅是介绍了Word2Vec、GloVe,还深入分析了它们在捕捉词汇语义和句法关系方面的优势,并且提供了实际应用的代码。我尝试用书中提供的代码来可视化词语之间的关系,看到那些语义相近的词语在向量空间中聚集在一起,让我对NLP的魅力有了更深的体会。这本书让我不仅仅停留在模仿代码,而是真正理解了每个算法背后的原理,以及它们如何应用于解决实际问题。它让我能够更自信地去处理文本数据,并从中提取有价值的信息。
评分这本书真的颠覆了我对自然语言处理的认知,原本以为这是一个冰冷且充满数学公式的领域,但作者通过Python这门生动有趣的语言,把NLP的奥秘层层剖析,让我这个编程新手也能逐步理解。书的结构安排得极其合理,从最基础的文本预处理,到更复杂的词向量、主题模型,再到深度学习在NLP中的应用,每一步都衔接得非常顺畅。我尤其喜欢书中关于文本预处理的章节,它详细讲解了分词、去除停用词、词干提取和词形还原等核心概念,并且提供了清晰的Python代码示例,让我能够立刻动手实践。书中的代码不是那种晦涩难懂的“黑盒子”,而是充满了注释和讲解,作者仿佛就坐在我身边,一步一步指导我如何写出高效的NLP程序。让我印象深刻的是,书中并没有止步于理论的讲解,而是花了大量篇幅来介绍各种实际应用场景,比如情感分析、文本分类、机器翻译等,并提供了相应的实现思路和代码框架。这使得我不仅仅是在学习技术,更是在学习如何用技术解决实际问题。我尝试用书中的方法去分析我自己的博客文章,结果非常令人惊喜,我能够准确地识别出文章的主题和潜在的情感倾向。这本书就像一把钥匙,为我打开了通往NLP世界的大门,也让我对未来在NLP领域继续深入学习充满了信心。它不仅仅是一本技术书籍,更是一次充满启发的学习旅程,让我感受到了编程与语言学结合的独特魅力。
评分坦白说,一开始拿到这本书,我有些担心它的难度,毕竟NLP听起来就不是一个简单的领域。但当我开始阅读后,我的顾虑完全打消了。作者的文笔非常流畅,逻辑清晰,即使是对于NLP的初学者,也能轻松理解。书中的每一个概念都配有生动形象的比喻和具体的代码示例,让我感觉不像是在阅读一本技术书籍,更像是在听一位经验丰富的老师在循循善诱。我最喜欢的部分是关于文本分类的章节,作者详细讲解了从特征工程到模型选择的整个流程,并提供了使用朴素贝叶斯、支持向量机等传统模型,以及利用深度学习模型进行文本分类的详细代码。我尝试用书中的代码对一系列新闻文章进行分类,结果非常准确,让我对NLP的能力有了更直观的认识。这本书不仅教会了我如何写代码,更重要的是教会了我如何思考,如何将NLP的理论知识转化为解决实际问题的能力。它让我明白,NLP并非高不可攀,而是可以通过学习和实践,掌握的一项强大的技能。
评分作为一名长期从事文本数据分析的从业者,我一直在寻找一本能够系统性地、且以实践为导向的NLP书籍。这本书无疑是我的不二之选。它在理论深度和代码实现之间找到了完美的平衡点。让我印象深刻的是,作者在讲解主题模型(如LDA)时,不仅仅是介绍算法,还详细讨论了如何选择合适的主题数量,如何解释模型输出的主题词,以及如何将主题模型应用于文档聚类和信息检索。书中的代码清晰易懂,并且提供了不同场景下的优化建议,这对于我处理大规模文本数据非常有帮助。我尝试用书中的方法对公司的用户反馈数据进行主题分析,结果发现了一些我之前没有注意到的用户痛点,为产品改进提供了宝贵的洞察。此外,书中对深度学习在NLP中的应用也进行了深入的探讨,包括RNN、LSTM、Transformer等模型,并提供了使用PyTorch或TensorFlow的实现示例。虽然深度学习部分的代码量较大,但作者的讲解非常到位,让我能够逐步理解这些复杂模型的内部机制。这本书让我能够将NLP技术更有效地应用于实际工作中,解决更复杂的问题,并且对于我未来的职业发展也起到了重要的推动作用。
评分我一直认为,要真正掌握一门技术,不仅仅是要理解理论,更重要的是能够将其付诸实践。这本书在这方面做得非常出色,它将NLP的各种技术和算法都通过Python代码进行了生动的展示,让我能够边学边练,快速提升自己的能力。我尤其喜欢书中关于文本聚类的章节,作者详细讲解了K-Means、DBSCAN等算法,并提供了使用Python实现的示例。我尝试用书中提供的代码来对大量的用户评论进行聚类,结果发现了一些之前没有注意到的用户群体特征,为市场营销策略的制定提供了宝贵的参考。此外,书中对词语相似度计算和文档相似度计算的讲解也让我受益匪浅。它不仅介绍了常用的相似度计算方法,还深入探讨了如何利用词嵌入和深度学习模型来提高相似度计算的准确性。这本书让我能够更好地理解文本数据之间的关系,并从中提取有价值的信息。
评分一多半是贴代码,剩下的小半介绍算法都是一笔带过
评分大致翻阅 需要较强python编程基础 针对英文文本的自然语言处理 对理论基本没有解释 大部分是代码
评分书中大量代码,内容体系结构不强。
评分书中大量代码,内容体系结构不强。
评分那些代码呈现的很不友好 有缩进错误。 要不然就是整段代码,还怕他有缩进错误 很多代码对于小白不友好
相关图书









本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈图书下载中心 版权所有