
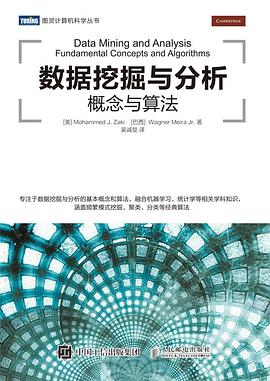
數據挖掘與分析 pdf epub mobi txt 電子書 下載 在線閱讀 2026
- 數據挖掘
- 數據分析
- 機器學習
- 計算機科學
- 計算科學
- CS
- 美國
- 學習
- 數據挖掘
- 數據分析
- 機器學習
- 統計學習
- 商業智能
- 數據科學
- Python
- R語言
- 數據可視化
- 模式識彆

具體描述
數據挖據與分析的入門書,針對初學者闡述所有關鍵概念,包括探索性數據分析、頻繁模式挖掘、聚類和分類。
兼顧前沿話題,例如核方法、高維數據分析、復雜圖和網絡等。
提供算法對應的開源實現方法。
每章均有豐富示例和練習,幫助讀者理解和鞏固相關主題。
配備豐富教輔資源,包括課程幻燈片、教學視頻、數據集等,可從以下網址獲取:http://www.dataminingbook.info/pmwiki.php/Main/BookResources。
作者簡介
作者簡介:
Mohammed J. Zaki
倫斯勒理工學院計算機科學係教授,ACM傑齣科學傢,IEEE會士,目前緻力於研究新數據挖掘技術。曾獲得榖歌教職研究奬等諸多奬項。
Wagner Meira Jr.
巴西米納斯聯邦大學計算機科學係教授,數據庫專傢。
譯者簡介:
吳誠堃
博士,2014年畢業於英國曼徹斯特大學,博士論文題為《應用大規模文本挖掘實現疾病分子機理重構》。現擔任國防科技大學計算機學院助理研究員,從事高性能計算應用研究。
目錄資訊
1.1 數據矩陣 1
1.2 屬性 2
1.3 數據的幾何和代數描述 3
1.3.1 距離和角度 5
1.3.2 均值與總方差 8
1.3.3 正交投影 9
1.3.4 綫性無關與維數 10
1.4 數據:概率觀點 12
1.4.1 二元隨機變量 17
1.4.2 多元隨機變量 20
1.4.3 隨機抽樣和統計量 21
1.5 數據挖掘 22
1.5.1 探索性數據分析 23
1.5.2 頻繁模式挖掘 24
1.5.3 聚類 24
1.5.4 分類 25
1.6 補充閱讀 26
1.7 習題 26
第一部分 數據分析基礎
第2章 數值屬性 28
2.1 一元變量分析 28
2.1.1 數據居中度度量 29
2.1.2 數據離散度度量 32
2.2 二元變量分析 35
2.2.1 位置和離散度的度量 36
2.2.2 相關性度量 37
2.3 多元變量分析 40
2.4 數據規範化 44
2.5 正態分布 46
2.5.1 一元正態分布 46
2.5.2 多元正態分布 47
2.6 補充閱讀 50
2.7 習題 51
第3章 類彆型屬性 53
3.1 一元分析 53
3.1.1 伯努利變量(Bernoulli variable) 53
3.1.2 多元伯努利變量 55
3.2 二元分析 61
3.3 多元分析 69
3.4 距離和角度 74
3.5 離散化 75
3.6 補充閱讀 77
3.7 習題 78
第4章 圖數據 79
4.1 圖的概念 79
4.2 拓撲屬性 83
4.3 中心度分析 86
4.3.1 基本中心度 86
4.3.2 Web中心度 88
4.4 圖的模型 96
4.4.1 Erd?s-Rényi隨機圖模型 98
4.4.2 Watts-Strogatz小世界圖模型 101
4.4.3 Barabási-Albert無標度模型 104
4.5 補充閱讀 111
4.6 習題 112
第5章 核方法 114
5.1 核矩陣 117
5.1.1 再生核映射 118
5.1.2 Mercer核映射 120
5.2 嚮量核 122
5.3 特徵空間中的基本核操作 126
5.4 復雜對象的核 132
5.4.1 字符串的譜核 132
5.4.2 圖節點的擴散核 133
5.5 補充閱讀 137
5.6 習題 137
第6章 高維數據 139
6.1 高維對象 139
6.2 高維體積 141
6.3 超立方體的內接超球麵 143
6.4 薄超球麵殼的體積 144
6.5 超空間的對角綫 145
6.6 多元正態的密度 146
6.7 附錄:球麵體積的推導 149
6.8 補充閱讀 153
6.9 習題 153
第7章 降維 156
7.1 背景知識 156
7.2 主成分分析 160
7.2.1 最優綫近似 160
7.2.2 最優二維近似 163
7.2.3 最優r維近似 167
7.2.4 主成分分析的幾何意義 170
7.3 核主成分分析 172
7.4 奇異值分解 178
7.4.1 奇異值分解的幾何意義 179
7.4.2 奇異值分解和主成分分析之間的聯係 180
7.5 補充閱讀 182
7.6 習題 182
第二部分 頻繁模式挖掘
第8章 項集挖掘 186
8.1 頻繁項集和關聯規則 186
8.2 頻繁項集挖掘算法 189
8.2.1 逐層的方法:Apriori算法 191
8.2.2 事務標識符集的交集方法:Eclat算法 193
8.2.3 頻繁模式樹方法:FPGrowth算法 197
8.3 生成關聯規則 201
8.4 補充閱讀 203
8.5 習題 203
第9章 項集概述 208
9.1 最大頻繁項集和閉頻繁項集 208
9.2 挖掘最大頻繁項集:GenMax算法 211
9.3 挖掘閉頻繁項集:Charm算法 213
9.4 非可導項集 215
9.5 補充閱讀 220
9.6 習題 221
第10章 序列挖掘 223
10.1 頻繁序列 223
10.2 挖掘頻繁序列 224
10.2.1 逐層挖掘:GSP 225
10.2.2 垂直序列挖掘:Spade 226
10.2.3 基於投影的序列挖掘:PrefixSpan 228
10.3 基於後綴樹的子串挖掘 230
10.3.1 後綴樹 230
10.3.2 Ukkonen綫性時間算法 233
10.4 補充閱讀 238
10.5 習題 239
第11章 圖模式挖掘 242
11.1 同形和支撐 242
11.2 候選生成 245
11.3 gSpan算法 249
11.3.1 擴展和支撐計算 250
11.3.2 權威性測試 255
11.4 補充閱讀 256
11.5 習題 257
第12章 模式與規則評估 260
12.1 規則和模式評估的度量 260
12.1.1 規則評估度量 260
12.1.2 模式評估度量 268
12.1.3 比較多條規則和模式 270
12.2 顯著性檢驗和置信區間 273
12.2.1 産生式規則的費希爾精確檢驗 273
12.2.2 顯著性的置換檢驗 277
12.2.3 置信區間內的自助抽樣 282
12.3 補充閱讀 284
12.4 習題 285
第三部分 聚類
第13章 基於代錶的聚類 288
13.1 K-means 算法 288
13.2 核K-means 292
13.3 期望最大聚類 295
13.3.1 一維中的EM 297
13.3.2 d維中的EM 300
13.3.3 極大似然估計 305
13.3.4 EM方法 309
13.4 補充閱讀 311
13.5 習題 312
第14章 層次式聚類 315
14.1 預備知識 315
14.2 聚閤型層次式聚類 317
14.2.1 簇間距離 317
14.2.2 更新距離矩陣 321
14.2.3 計算復雜度 322
14.3 補充閱讀 322
14.4 習題 323
第15章 基於密度的聚類 325
15.1 DBSCAN 算法 325
15.2 核密度估計 328
15.2.1 一元密度估計 328
15.2.2 多元密度估計 331
15.2.3 最近鄰密度估計 333
15.3 基於密度的聚類:DENCLUE 333
15.4 補充閱讀 338
15.5 習題 339
第16章 譜聚類和圖聚類 341
16.1 圖和矩陣 341
16.2 基於圖的割的聚類 347
16.2.1 聚類目標函數:比例割與歸—割 349
16.2.2 譜聚類算法 351
16.2.3 最大化目標:平均割與模塊度 354
16.3 馬爾可夫聚類 360
16.4 補充閱讀 366
16.5 習題 367
第17章 聚類的驗證 368
17.1 外部驗證度量 368
17.1.1 基於匹配的度量 369
17.1.2 基於熵的度量 372
17.1.3 成對度量 375
17.1.4 關聯度量 378
17.2 內部度量 381
17.3 相對度量 388
17.3.1 分簇穩定性 394
17.3.2 聚類趨嚮性 396
17.4 補充閱讀 400
17.5 習題 401
第四部分 分類
第18章 基於概率的分類 404
18.1 貝葉斯分類器 404
18.1.1 估計先驗概率 404
18.1.2 估計似然 405
18.2 樸素貝葉斯分類器 409
18.3 K最近鄰分類器 412
18.4 補充閱讀 414
18.5 習題 415
第19章 決策樹分類器 416
19.1 決策樹 417
19.2 決策樹算法 419
19.2.1 分割點評估度量 420
19.2.2 評估分割點 422
19.3 補充閱讀 429
19.4 習題 429
第20章 綫性判彆分析 431
20.1 最優綫性判彆 431
20.2 核判彆分析 437
20.3 補充閱讀 443
20.4 習題 443
第21章 支持嚮量機 445
21.1 支持嚮量和間隔 445
21.2 SVM:綫性可分的情況 450
21.3 軟間隔SVM:綫性不可分的情況 454
21.3.1 鉸鏈誤損 455
21.3.2 二次誤損 458
21.4 核SVM:非綫性情況 459
21.5 SVM訓練算法 462
21.5.1 對偶解法:隨機梯度上升 463
21.5.2 原始問題解:牛頓優化 467
21.6 補充閱讀 473
21.7 習題 473
第22章 分類的評估 475
22.1 分類性能度量 475
22.1.1 基於列聯錶的度量 476
22.1.2 二值分類:正類和負類 479
22.1.3 ROC分析 482
22.2 分類器評估 487
22.2.1 K摺交叉驗證 487
22.2.2 自助抽樣 488
22.2.3 置信區間 489
22.2.4 分類器比較:配對t檢驗 493
22.3 偏置-方差分解 495
22.4 補充閱讀 503
22.5 習題 504
· · · · · · (收起)
讀後感
这本书是我Data Mining课的教材,我精读了这本书。老师是这本书作者的学生之一。这本书涉及了一点有深度的领域,尤其是kernel method,几乎占据了书中一半的内容。作者是ECLAT算法的发明者。 首先我想说,这本书不适合入门。 原因在于,第一,语言很生硬。一本优秀教材一定要...
評分这本书是我Data Mining课的教材,我精读了这本书。老师是这本书作者的学生之一。这本书涉及了一点有深度的领域,尤其是kernel method,几乎占据了书中一半的内容。作者是ECLAT算法的发明者。 首先我想说,这本书不适合入门。 原因在于,第一,语言很生硬。一本优秀教材一定要...
評分这本书是我Data Mining课的教材,我精读了这本书。老师是这本书作者的学生之一。这本书涉及了一点有深度的领域,尤其是kernel method,几乎占据了书中一半的内容。作者是ECLAT算法的发明者。 首先我想说,这本书不适合入门。 原因在于,第一,语言很生硬。一本优秀教材一定要...
評分这本书是我Data Mining课的教材,我精读了这本书。老师是这本书作者的学生之一。这本书涉及了一点有深度的领域,尤其是kernel method,几乎占据了书中一半的内容。作者是ECLAT算法的发明者。 首先我想说,这本书不适合入门。 原因在于,第一,语言很生硬。一本优秀教材一定要...
評分这本书是我Data Mining课的教材,我精读了这本书。老师是这本书作者的学生之一。这本书涉及了一点有深度的领域,尤其是kernel method,几乎占据了书中一半的内容。作者是ECLAT算法的发明者。 首先我想说,这本书不适合入门。 原因在于,第一,语言很生硬。一本优秀教材一定要...
用戶評價
寫的很詳細,公式也很清晰,主要的一點是:看得懂、看完代碼易實現。
评分全書23章 從簡單基礎的基本概念和數學基礎入手 逐步到關聯規則 聚類等算法分析 還有具體應用案例 可購買一本留用
评分Hhhhhh
评分全書23章 從簡單基礎的基本概念和數學基礎入手 逐步到關聯規則 聚類等算法分析 還有具體應用案例 可購買一本留用
评分全書23章 從簡單基礎的基本概念和數學基礎入手 逐步到關聯規則 聚類等算法分析 還有具體應用案例 可購買一本留用
相關圖書



本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有