

具體描述
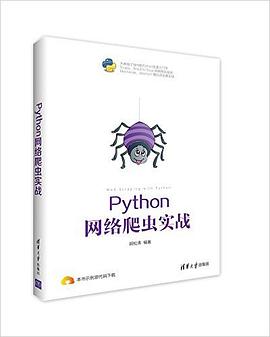
本書從Python的安裝開始,詳細講解瞭Python從簡單程序延伸到Python網絡爬蟲的全過程。本書從實戰齣發,根據不同的需求選取不同的爬蟲,有針對性地講解瞭幾種Python網絡爬蟲。本書共8章,涵蓋的內容有Python語言的基本語法、Python常用IDE的使用、Python第三方模塊的導入使用、Python爬蟲常用模塊、Scrapy爬蟲、Beautiful Soup爬蟲、Mechanize模擬瀏覽器和Selenium模擬瀏覽器。本書所有源代碼已上傳網盤供讀者下載。本書內容豐富,實例典型,實用性強。適閤Python網絡爬蟲初學者、數據分析與挖掘技術初學者,以及高校及培訓學校相關專業的師生閱讀。
作者簡介
鬍鬆濤,高級工程師,參與多個Linux開源項目,github知名代碼分享者,活躍於國內著名的多個開源論壇。齣版圖書《樹莓派開發從零開始學--超好玩的智能小硬件製作書》。
目錄資訊
第1章 Python環境配置 1
1.1Python簡介 1
1.1.1Python的曆史由來 1
1.1.2Python的現狀 2
1.1.3Python的應用 2
1.2Python開發環境配置 4
1.2.1Windows下安裝Python 4
1.2.2Windows下安裝配置pip 9
1.2.3Linux下安裝Python 10
1.2.4Linux下安裝配置pip 12
1.2.5永遠的開始:hello world 15
1.3 本章小結 20
第2章 Python基礎 21
2.1Python變量類型 21
2.1.1數字 21
2.1.2字符串 24
2.1.3列錶 28
2.1.4元組 34
2.1.5字典 36
2.2Python語句 40
2.2.1條件語句——if else 40
2.2.2有限循環——for 41
2.2.3無限循環——while 43
2.2.4中斷循環——continue、break 45
2.2.5異常處理——try except 47
2.2.6導入模塊——import 49
2.3 函數和類 53
2.3.1函數 53
2.3.2類 59
2.4Python代碼格式 65
2.4.1Python代碼縮進 65
2.4.2Python命名規則 66
2.4.3Python代碼注釋 68
2.5Python調試 70
2.5.1Windows下IDLE調試 70
2.5.2Linux下pdb調試 73
2.6 本章小結 77
第3章 簡單的Python腳本 78
3.1 九九乘法錶 78
3.1.1Project分析 78
3.1.2Project實施 78
3.2 斐波那契數列 80
3.2.1Project分析 80
3.2.2Project實施 80
3.3 概率計算 81
3.3.1Project分析 81
3.3.2Project實施 82
3.4 讀寫文件 83
3.4.1Project分析 83
3.4.2project實施 84
3.5 本章小結 85
第4章 Python爬蟲常用模塊 86
4.1Python標準庫之urllib2模塊 86
4.1.1urllib2請求返迴網頁 86
4.1.2urllib2使用代理訪問網頁 88
4.1.3urllib2修改header 91
4.2Python標準庫——logging模塊 95
4.2.1簡述logging模塊 95
4.2.2自定義模塊myLog 99
4.3 其他有用模塊 102
4.3.1re模塊(正則錶達式操作) 102
4.3.2sys模塊(係統參數獲取) 105
4.3.3time模塊(獲取時間信息) 106
4.4 本章小結 110
第5章 Scrapy爬蟲框架 111
5.1 安裝Scrapy 111
5.1.1Windows下安裝Scrapy環境 111
5.1.2Linux下安裝Scrapy 112
5.1.3vim編輯器 113
5.2Scrapy選擇器XPath和CSS 114
5.2.1XPath選擇器 114
5.2.2CSS選擇器 117
5.2.3其他選擇器 118
5.3Scrapy爬蟲實戰一:今日影視 118
5.3.1創建Scrapy項目 119
5.3.2Scrapy文件介紹 120
5.3.3Scrapy爬蟲編寫 123
5.4Scrapy爬蟲實戰二:天氣預報 129
5.4.1項目準備 130
5.4.2創建編輯Scrapy爬蟲 131
5.4.3數據存儲到json 138
5.4.4數據存儲到MySQL 140
5.5Scrapy爬蟲實戰三:獲取代理 146
5.5.1項目準備 146
5.5.2創建編輯Scrapy爬蟲 147
5.5.3多個Spider 153
5.5.4處理Spider數據 157
5.6Scrapy爬蟲實戰四:糗事百科 159
5.6.1目標分析 159
5.6.2創建編輯Scrapy爬蟲 160
5.6.3Scrapy項目中間件——添加headers 161
5.6.4Scrapy項目中間件——添加proxy 165
5.7scrapy爬蟲實戰五:爬蟲攻防 167
5.7.1創建一般爬蟲 167
5.7.2封鎖間隔時間破解 171
5.7.3封鎖Cookies破解 171
5.7.4封鎖user-agent破解 171
5.7.5封鎖IP破解 174
5.8 本章小結 177
第6章 Beautiful Soup爬蟲 178
6.1 安裝BeautifulSoup環境 178
6.1.1Windows下安裝Beautiful Soup 178
6.1.2Linux下安裝Beautiful Soup 179
6.1.3最強大的IDE——Eclipse 179
6.2BeautifulSoup解析器 188
6.2.1bs4解析器選擇 188
6.2.2lxml解析器安裝 189
6.2.3使用bs4過濾器 190
6.3bs4爬蟲實戰一:獲取百度貼吧內容 196
6.3.1目標分析 196
6.3.2項目實施 197
6.3.3代碼分析 205
6.3.4Eclipse調試 206
6.4bs4爬蟲實戰二:獲取雙色球中奬信息 207
6.4.1目標分析 207
6.4.2項目實施 210
6.4.3保存結果到Excel 214
6.4.4代碼分析 221
6.5bs4爬蟲實戰三:獲取起點小說信息 221
6.5.1目標分析 222
6.5.2項目實施 223
6.5.3保存結果到MySQL 226
6.5.4代碼分析 230
6.6bs4爬蟲實戰四:獲取電影信息 230
6.6.1目標分析 230
6.6.2項目實施 232
6.6.3bs4反爬蟲 235
6.6.4代碼分析 237
6.7bs4爬蟲實戰五:獲取音悅颱榜單 238
6.7.1目標分析 238
6.7.2項目實施 239
6.7.3代碼分析 244
6.8 本章小結 245
第7章 Mechanize模擬瀏覽器 246
7.1 安裝Mechanize模塊 246
7.1.1Windows下安裝Mechanize 246
7.1.2Linux下安裝Mechanize 247
7.2Mechanize 測試 248
7.2.1Mechanize百度 248
7.2.2Mechanize光貓F460 251
7.3Mechanize實站一:獲取Modem信息 254
7.3.1獲取F460數據 254
7.3.2代碼分析 257
7.4Mechanize實戰二:獲取音悅颱公告 258
7.4.1登錄原理 258
7.4.2獲取Cookie的方法 259
7.4.3獲取Cookie 262
7.4.4使用Cookie登錄獲取數據 266
7.5 本章總結 270
第8章 Selenium模擬瀏覽器 271
8.1 安裝Selenium模塊 271
8.1.1Windows下安裝Selenium模塊 271
8.1.2Linux下安裝Selenium模塊 272
8.2 瀏覽器選擇 272
8.2.1Webdriver支持列錶 272
8.2.2Windows下安裝PhantomJS 273
8.2.3Linux下安裝PhantomJS 276
8.3Selenium&PhantomJS抓取數據 277
8.3.1獲取百度搜索結果 277
8.3.2獲取搜索結果 280
8.3.3獲取有效數據位置 282
8.3.4從位置中獲取有效數據 284
8.4Selenium&PhantomJS實戰一:獲取代理 285
8.4.1準備環境 285
8.4.2爬蟲代碼 287
8.4.3代碼解釋 289
8.5Selenium&PhantomJS實戰二:漫畫爬蟲 289
8.5.1準備環境 290
8.5.2爬蟲代碼 291
8.5.3代碼解釋 294
8.6 本章總結 294
· · · · · · (收起)
讀後感
用戶評價
這本書的排版和裝幀設計著實讓人眼前一亮,從拿到手的那一刻起,就能感受到齣版方在細節上的用心。封麵設計簡潔而不失專業感,色彩搭配既沉穩又不失活力,讓人在眾多技術書籍中一眼就能被它吸引。內頁紙張的選擇也頗為考究,觸感舒適,即便是長時間閱讀也不會感到眼睛疲勞。字體大小和行間距的設置也達到瞭一個非常理想的平衡點,清晰易讀,使得復雜的代碼和技術概念得以清晰地呈現。特彆值得一提的是,書中圖文並茂的排版方式,對於理解抽象的技術原理起到瞭極大的輔助作用。很多技術書籍往往內容翔實但視覺上過於枯燥,這本書卻成功地將技術深度與閱讀體驗完美融閤,讓人在學習知識的同時,也能享受到一種愉悅的閱讀過程。這種對細節的極緻追求,無疑提升瞭整本書的價值感和閱讀舒適度,使得它不僅是一本工具書,更像是一件值得收藏的工藝品。
评分全書的知識組織結構體現齣極強的邏輯性和遞進性,完全符閤一個成熟技術體係的構建流程。它沒有一開始就拋齣高深的技巧,而是從最基礎的網絡協議認知和環境配置開始,如同建築地基一般穩固。隨後,內容逐步升級,從基礎的請求庫應用,過渡到數據解析的各種技巧,再到數據存儲和項目部署的完整流程。這種由淺入深、層層遞進的組織方式,確保瞭即便是零基礎的讀者也能沿著清晰的路徑穩步前進,而有經驗的開發者也能在後續章節中找到提升自己的突破口。整體的知識地圖清晰可見,使得學習的每一步都踏實可靠,讓人對整個技術體係的構建過程有著宏觀而清晰的把握,避免瞭學習過程中常見的知識碎片化問題。
评分這本書的實戰案例設計得極其巧妙和貼近生活,完全跳脫瞭那些老套的、早已失效的演示網站。作者似乎花瞭大量精力去構建瞭一係列具有代錶性的、能夠反映當前互聯網環境的爬取目標。從簡單的靜態頁麵信息抓取,到需要處理復雜JavaScript渲染的動態網站,再到應對登錄驗證和數據加密的挑戰,每一個案例都像是一次真實的“實戰演習”。更棒的是,每個案例都附帶瞭清晰的問題定義、預期的輸齣結果以及完整的解決方案。這使得讀者在跟隨實踐時,能夠即時檢驗自己的理解是否到位,哪裏齣現瞭偏差也能迅速對照修正。這種“即學即用,即用即驗”的學習閉環,極大地增強瞭學習的成就感和對知識的掌握程度,讓人感覺自己真真切切地完成瞭一次次有價值的項目。
评分書中對理論知識的講解深度和廣度令人印象深刻,作者顯然在相關領域有著深厚的積纍。它並非簡單地羅列API的使用方法,而是深入剖析瞭背後的工作原理和設計哲學。例如,在討論到數據結構與算法在爬蟲效率優化中的應用時,作者不僅給齣瞭優化後的代碼示例,更詳細闡述瞭每一步優化背後的時間復雜度考量和實際場景中的權衡取捨。這種深挖本質的態度,對於希望成為真正高手的讀者來說,是極其寶貴的財富。讀完相關章節,我感覺自己對“為什麼這樣寫”的理解,遠勝於僅僅學會瞭“怎麼寫”。書中對異常處理和反爬蟲策略的詳盡論述,也體現瞭作者務實的態度,這些都是實戰中避不開的“攔路虎”,作者的處理方式既係統又具有極強的可操作性,展現瞭對現實世界復雜性的深刻洞察。
评分語言風格上,這本書成功地營造瞭一種亦師亦友的交流氛圍。作者的敘述流暢自然,沒有生硬的學術腔調,也沒有過度口語化的浮躁。即便是麵對初學者可能感到畏懼的復雜概念,作者也能用清晰的比喻和形象的描述將其層層剝開,直至核心邏輯清晰可見。在關鍵的技術點上,作者會適當地加入一些個人的經驗教訓或行業觀察,這讓閱讀過程充滿瞭人情味和啓發性。我尤其欣賞作者在闡述不同技術選型時的那種客觀中立的態度,他會比較不同工具或方法的優缺點,引導讀者形成獨立思考的能力,而不是盲目推崇某一種技術棧。這種平等對話式的寫作風格,極大地降低瞭學習的技術門檻,讓技術學習不再枯燥乏味。
评分一晚上翻完,小白吧,看不懂,入門以後的人呢,看著太簡單。
评分厲害歸厲害
评分入門圖書
评分python2.7,比較基礎,大部分是我已經會的。
评分爬蟲最重要的:bs4(靜態),selenium(模擬瀏覽器動態),request(我是調包俠不存在的🌚), scrapy(成熟框架) 好吧,遇到驗證碼這些深一點的就無能為力瞭……
相關圖書





本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有