
具体描述
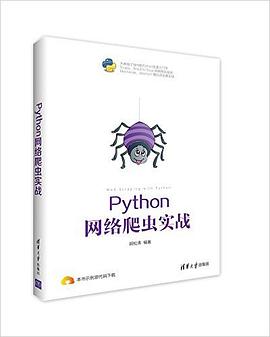
本书从Python的安装开始,详细讲解了Python从简单程序延伸到Python网络爬虫的全过程。本书从实战出发,根据不同的需求选取不同的爬虫,有针对性地讲解了几种Python网络爬虫。本书共8章,涵盖的内容有Python语言的基本语法、Python常用IDE的使用、Python第三方模块的导入使用、Python爬虫常用模块、Scrapy爬虫、Beautiful Soup爬虫、Mechanize模拟浏览器和Selenium模拟浏览器。本书所有源代码已上传网盘供读者下载。本书内容丰富,实例典型,实用性强。适合Python网络爬虫初学者、数据分析与挖掘技术初学者,以及高校及培训学校相关专业的师生阅读。
作者简介
胡松涛,高级工程师,参与多个Linux开源项目,github知名代码分享者,活跃于国内著名的多个开源论坛。出版图书《树莓派开发从零开始学--超好玩的智能小硬件制作书》。
目录信息
第1章 Python环境配置 1
1.1Python简介 1
1.1.1Python的历史由来 1
1.1.2Python的现状 2
1.1.3Python的应用 2
1.2Python开发环境配置 4
1.2.1Windows下安装Python 4
1.2.2Windows下安装配置pip 9
1.2.3Linux下安装Python 10
1.2.4Linux下安装配置pip 12
1.2.5永远的开始:hello world 15
1.3 本章小结 20
第2章 Python基础 21
2.1Python变量类型 21
2.1.1数字 21
2.1.2字符串 24
2.1.3列表 28
2.1.4元组 34
2.1.5字典 36
2.2Python语句 40
2.2.1条件语句——if else 40
2.2.2有限循环——for 41
2.2.3无限循环——while 43
2.2.4中断循环——continue、break 45
2.2.5异常处理——try except 47
2.2.6导入模块——import 49
2.3 函数和类 53
2.3.1函数 53
2.3.2类 59
2.4Python代码格式 65
2.4.1Python代码缩进 65
2.4.2Python命名规则 66
2.4.3Python代码注释 68
2.5Python调试 70
2.5.1Windows下IDLE调试 70
2.5.2Linux下pdb调试 73
2.6 本章小结 77
第3章 简单的Python脚本 78
3.1 九九乘法表 78
3.1.1Project分析 78
3.1.2Project实施 78
3.2 斐波那契数列 80
3.2.1Project分析 80
3.2.2Project实施 80
3.3 概率计算 81
3.3.1Project分析 81
3.3.2Project实施 82
3.4 读写文件 83
3.4.1Project分析 83
3.4.2project实施 84
3.5 本章小结 85
第4章 Python爬虫常用模块 86
4.1Python标准库之urllib2模块 86
4.1.1urllib2请求返回网页 86
4.1.2urllib2使用代理访问网页 88
4.1.3urllib2修改header 91
4.2Python标准库——logging模块 95
4.2.1简述logging模块 95
4.2.2自定义模块myLog 99
4.3 其他有用模块 102
4.3.1re模块(正则表达式操作) 102
4.3.2sys模块(系统参数获取) 105
4.3.3time模块(获取时间信息) 106
4.4 本章小结 110
第5章 Scrapy爬虫框架 111
5.1 安装Scrapy 111
5.1.1Windows下安装Scrapy环境 111
5.1.2Linux下安装Scrapy 112
5.1.3vim编辑器 113
5.2Scrapy选择器XPath和CSS 114
5.2.1XPath选择器 114
5.2.2CSS选择器 117
5.2.3其他选择器 118
5.3Scrapy爬虫实战一:今日影视 118
5.3.1创建Scrapy项目 119
5.3.2Scrapy文件介绍 120
5.3.3Scrapy爬虫编写 123
5.4Scrapy爬虫实战二:天气预报 129
5.4.1项目准备 130
5.4.2创建编辑Scrapy爬虫 131
5.4.3数据存储到json 138
5.4.4数据存储到MySQL 140
5.5Scrapy爬虫实战三:获取代理 146
5.5.1项目准备 146
5.5.2创建编辑Scrapy爬虫 147
5.5.3多个Spider 153
5.5.4处理Spider数据 157
5.6Scrapy爬虫实战四:糗事百科 159
5.6.1目标分析 159
5.6.2创建编辑Scrapy爬虫 160
5.6.3Scrapy项目中间件——添加headers 161
5.6.4Scrapy项目中间件——添加proxy 165
5.7scrapy爬虫实战五:爬虫攻防 167
5.7.1创建一般爬虫 167
5.7.2封锁间隔时间破解 171
5.7.3封锁Cookies破解 171
5.7.4封锁user-agent破解 171
5.7.5封锁IP破解 174
5.8 本章小结 177
第6章 Beautiful Soup爬虫 178
6.1 安装BeautifulSoup环境 178
6.1.1Windows下安装Beautiful Soup 178
6.1.2Linux下安装Beautiful Soup 179
6.1.3最强大的IDE——Eclipse 179
6.2BeautifulSoup解析器 188
6.2.1bs4解析器选择 188
6.2.2lxml解析器安装 189
6.2.3使用bs4过滤器 190
6.3bs4爬虫实战一:获取百度贴吧内容 196
6.3.1目标分析 196
6.3.2项目实施 197
6.3.3代码分析 205
6.3.4Eclipse调试 206
6.4bs4爬虫实战二:获取双色球中奖信息 207
6.4.1目标分析 207
6.4.2项目实施 210
6.4.3保存结果到Excel 214
6.4.4代码分析 221
6.5bs4爬虫实战三:获取起点小说信息 221
6.5.1目标分析 222
6.5.2项目实施 223
6.5.3保存结果到MySQL 226
6.5.4代码分析 230
6.6bs4爬虫实战四:获取电影信息 230
6.6.1目标分析 230
6.6.2项目实施 232
6.6.3bs4反爬虫 235
6.6.4代码分析 237
6.7bs4爬虫实战五:获取音悦台榜单 238
6.7.1目标分析 238
6.7.2项目实施 239
6.7.3代码分析 244
6.8 本章小结 245
第7章 Mechanize模拟浏览器 246
7.1 安装Mechanize模块 246
7.1.1Windows下安装Mechanize 246
7.1.2Linux下安装Mechanize 247
7.2Mechanize 测试 248
7.2.1Mechanize百度 248
7.2.2Mechanize光猫F460 251
7.3Mechanize实站一:获取Modem信息 254
7.3.1获取F460数据 254
7.3.2代码分析 257
7.4Mechanize实战二:获取音悦台公告 258
7.4.1登录原理 258
7.4.2获取Cookie的方法 259
7.4.3获取Cookie 262
7.4.4使用Cookie登录获取数据 266
7.5 本章总结 270
第8章 Selenium模拟浏览器 271
8.1 安装Selenium模块 271
8.1.1Windows下安装Selenium模块 271
8.1.2Linux下安装Selenium模块 272
8.2 浏览器选择 272
8.2.1Webdriver支持列表 272
8.2.2Windows下安装PhantomJS 273
8.2.3Linux下安装PhantomJS 276
8.3Selenium&PhantomJS抓取数据 277
8.3.1获取百度搜索结果 277
8.3.2获取搜索结果 280
8.3.3获取有效数据位置 282
8.3.4从位置中获取有效数据 284
8.4Selenium&PhantomJS实战一:获取代理 285
8.4.1准备环境 285
8.4.2爬虫代码 287
8.4.3代码解释 289
8.5Selenium&PhantomJS实战二:漫画爬虫 289
8.5.1准备环境 290
8.5.2爬虫代码 291
8.5.3代码解释 294
8.6 本章总结 294
· · · · · · (收起)
读后感
用户评价
全书的知识组织结构体现出极强的逻辑性和递进性,完全符合一个成熟技术体系的构建流程。它没有一开始就抛出高深的技巧,而是从最基础的网络协议认知和环境配置开始,如同建筑地基一般稳固。随后,内容逐步升级,从基础的请求库应用,过渡到数据解析的各种技巧,再到数据存储和项目部署的完整流程。这种由浅入深、层层递进的组织方式,确保了即便是零基础的读者也能沿着清晰的路径稳步前进,而有经验的开发者也能在后续章节中找到提升自己的突破口。整体的知识地图清晰可见,使得学习的每一步都踏实可靠,让人对整个技术体系的构建过程有着宏观而清晰的把握,避免了学习过程中常见的知识碎片化问题。
书中对理论知识的讲解深度和广度令人印象深刻,作者显然在相关领域有着深厚的积累。它并非简单地罗列API的使用方法,而是深入剖析了背后的工作原理和设计哲学。例如,在讨论到数据结构与算法在爬虫效率优化中的应用时,作者不仅给出了优化后的代码示例,更详细阐述了每一步优化背后的时间复杂度考量和实际场景中的权衡取舍。这种深挖本质的态度,对于希望成为真正高手的读者来说,是极其宝贵的财富。读完相关章节,我感觉自己对“为什么这样写”的理解,远胜于仅仅学会了“怎么写”。书中对异常处理和反爬虫策略的详尽论述,也体现了作者务实的态度,这些都是实战中避不开的“拦路虎”,作者的处理方式既系统又具有极强的可操作性,展现了对现实世界复杂性的深刻洞察。
语言风格上,这本书成功地营造了一种亦师亦友的交流氛围。作者的叙述流畅自然,没有生硬的学术腔调,也没有过度口语化的浮躁。即便是面对初学者可能感到畏惧的复杂概念,作者也能用清晰的比喻和形象的描述将其层层剥开,直至核心逻辑清晰可见。在关键的技术点上,作者会适当地加入一些个人的经验教训或行业观察,这让阅读过程充满了人情味和启发性。我尤其欣赏作者在阐述不同技术选型时的那种客观中立的态度,他会比较不同工具或方法的优缺点,引导读者形成独立思考的能力,而不是盲目推崇某一种技术栈。这种平等对话式的写作风格,极大地降低了学习的技术门槛,让技术学习不再枯燥乏味。
这本书的实战案例设计得极其巧妙和贴近生活,完全跳脱了那些老套的、早已失效的演示网站。作者似乎花了大量精力去构建了一系列具有代表性的、能够反映当前互联网环境的爬取目标。从简单的静态页面信息抓取,到需要处理复杂JavaScript渲染的动态网站,再到应对登录验证和数据加密的挑战,每一个案例都像是一次真实的“实战演习”。更棒的是,每个案例都附带了清晰的问题定义、预期的输出结果以及完整的解决方案。这使得读者在跟随实践时,能够即时检验自己的理解是否到位,哪里出现了偏差也能迅速对照修正。这种“即学即用,即用即验”的学习闭环,极大地增强了学习的成就感和对知识的掌握程度,让人感觉自己真真切切地完成了一次次有价值的项目。
这本书的排版和装帧设计着实让人眼前一亮,从拿到手的那一刻起,就能感受到出版方在细节上的用心。封面设计简洁而不失专业感,色彩搭配既沉稳又不失活力,让人在众多技术书籍中一眼就能被它吸引。内页纸张的选择也颇为考究,触感舒适,即便是长时间阅读也不会感到眼睛疲劳。字体大小和行间距的设置也达到了一个非常理想的平衡点,清晰易读,使得复杂的代码和技术概念得以清晰地呈现。特别值得一提的是,书中图文并茂的排版方式,对于理解抽象的技术原理起到了极大的辅助作用。很多技术书籍往往内容翔实但视觉上过于枯燥,这本书却成功地将技术深度与阅读体验完美融合,让人在学习知识的同时,也能享受到一种愉悦的阅读过程。这种对细节的极致追求,无疑提升了整本书的价值感和阅读舒适度,使得它不仅是一本工具书,更像是一件值得收藏的工艺品。
厉害归厉害
字典那一节,“字典的键可以是数字、字符串、列表、元组、几乎什么都可以” 然而dict中的key只能是hashable,列表是不可以的,不推荐阅读。
没懂作者这个水平是怎么想出实战的书的?浪费地球资源
入门图书
大概看了一下