
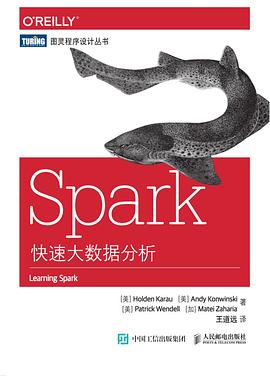
Spark快速大數據分析 pdf epub mobi txt 電子書 下載 在線閱讀 2026
- 大數據
- spark
- 數據分析
- Spark
- 計算機
- bigdata
- 數據平颱
- 技術
- 大數據
- Spark
- 數據分析
- 快速入門
- 數據處理
- 分布式計算
- 機器學習
- 數據科學
- 高性能計算
- 實時分析

具體描述
作者簡介
Holden Karau是Databricks的軟件開發工程師,活躍於開源社區。她還著有《Spark快速數據處理》。
Andy Konwinski是Databricks聯閤創始人,Apache Spark項目技術專傢,還是Apache Mesos項目的聯閤發起人。
Patrick Wendell是Databricks聯閤創始人,也是Apache Spark項目技術專傢。他還負責維護Spark核心引擎的幾個子係統。
Matei Zaharia是Databricks的CTO,同時也是Apache Spark項目發起人以及Apache基金會副主席。
目錄資訊
推薦序 xi
譯者序 xiv
序 xvi
前言 xvii
第1章 Spark數據分析導論 1
1.1 Spark是什麼 1
1.2 一個大一統的軟件棧 2
1.2.1 Spark Core 2
1.2.2 Spark SQL 3
1.2.3 Spark Streaming 3
1.2.4 MLlib 3
1.2.5 GraphX 3
1.2.6 集群管理器 4
1.3 Spark的用戶和用途 4
1.3.1 數據科學任務 4
1.3.2 數據處理應用 5
1.4 Spark簡史 5
1.5 Spark的版本和發布 6
1.6 Spark的存儲層次 6
第2章 Spark下載與入門 7
2.1 下載Spark 7
2.2 Spark中Python和Scala的shell 9
2.3 Spark 核心概念簡介 12
2.4 獨立應用 14
2.4.1 初始化SparkContext 15
2.4.2 構建獨立應用 16
2.5 總結 19
第3章 RDD編程 21
3.1 RDD基礎 21
3.2 創建RDD 23
3.3 RDD操作 24
3.3.1 轉化操作 24
3.3.2 行動操作 26
3.3.3 惰性求值 27
3.4 嚮Spark傳遞函數 27
3.4.1 Python 27
3.4.2 Scala 28
3.4.3 Java 29
3.5 常見的轉化操作和行動操作 30
3.5.1 基本RDD 30
3.5.2 在不同RDD類型間轉換 37
3.6 持久化( 緩存) 39
3.7 總結 40
第4章 鍵值對操作 41
4.1 動機 41
4.2 創建Pair RDD 42
4.3 Pair RDD的轉化操作 42
4.3.1 聚閤操作 45
4.3.2 數據分組 49
4.3.3 連接 50
4.3.4 數據排序 51
4.4 Pair RDD的行動操作 52
4.5 數據分區(進階) 52
4.5.1 獲取RDD的分區方式 55
4.5.2 從分區中獲益的操作 56
4.5.3 影響分區方式的操作 57
4.5.4 示例:PageRank 57
4.5.5 自定義分區方式 59
4.6 總結 61
第5章 數據讀取與保存 63
5.1 動機 63
5.2 文件格式 64
5.2.1 文本文件 64
5.2.2 JSON 66
5.2.3 逗號分隔值與製錶符分隔值 68
5.2.4 SequenceFile 71
5.2.5 對象文件 73
5.2.6 Hadoop輸入輸齣格式 73
5.2.7 文件壓縮 77
5.3 文件係統 78
5.3.1 本地/“常規”文件係統 78
5.3.2 Amazon S3 78
5.3.3 HDFS 79
5.4 Spark SQL中的結構化數據 79
5.4.1 Apache Hive 80
5.4.2 JSON 80
5.5 數據庫 81
5.5.1 Java數據庫連接 81
5.5.2 Cassandra 82
5.5.3 HBase 84
5.5.4 Elasticsearch 85
5.6 總結 86
第6章 Spark編程進階 87
6.1 簡介 87
6.2 纍加器 88
6.2.1 纍加器與容錯性 90
6.2.2 自定義纍加器 91
6.3 廣播變量 91
6.4 基於分區進行操作 94
6.5 與外部程序間的管道 96
6.6 數值RDD 的操作 99
6.7 總結 100
第7章 在集群上運行Spark 101
7.1 簡介 101
7.2 Spark運行時架構 101
7.2.1 驅動器節點 102
7.2.2 執行器節點 103
7.2.3 集群管理器 103
7.2.4 啓動一個程序 104
7.2.5 小結 104
7.3 使用spark-submit 部署應用 105
7.4 打包代碼與依賴 107
7.4.1 使用Maven構建的用Java編寫的Spark應用 108
7.4.2 使用sbt構建的用Scala編寫的Spark應用 109
7.4.3 依賴衝突 111
7.5 Spark應用內與應用間調度 111
7.6 集群管理器 112
7.6.1 獨立集群管理器 112
7.6.2 Hadoop YARN 115
7.6.3 Apache Mesos 116
7.6.4 Amazon EC2 117
7.7 選擇閤適的集群管理器 120
7.8 總結 121
第8章 Spark調優與調試 123
8.1 使用SparkConf配置Spark 123
8.2 Spark執行的組成部分:作業、任務和步驟 127
8.3 查找信息 131
8.3.1 Spark網頁用戶界麵 131
8.3.2 驅動器進程和執行器進程的日誌 134
8.4 關鍵性能考量 135
8.4.1 並行度 135
8.4.2 序列化格式 136
8.4.3 內存管理 137
8.4.4 硬件供給 138
8.5 總結 139
第9章 Spark SQL 141
9.1 連接Spark SQL 142
9.2 在應用中使用Spark SQL 144
9.2.1 初始化Spark SQL 144
9.2.2 基本查詢示例 145
9.2.3 SchemaRDD 146
9.2.4 緩存 148
9.3 讀取和存儲數據 149
9.3.1 Apache Hive 149
9.3.2 Parquet 150
9.3.3 JSON 150
9.3.4 基於RDD 152
9.4 JDBC/ODBC服務器 153
9.4.1 使用Beeline 155
9.4.2 長生命周期的錶與查詢 156
9.5 用戶自定義函數 156
9.5.1 Spark SQL UDF 156
9.5.2 Hive UDF 157
9.6 Spark SQL性能 158
9.7 總結 159
第10章 Spark Streaming 161
10.1 一個簡單的例子 162
10.2 架構與抽象 164
10.3 轉化操作 167
10.3.1 無狀態轉化操作 167
10.3.2 有狀態轉化操作 169
10.4 輸齣操作 173
10.5 輸入源 175
10.5.1 核心數據源 175
10.5.2 附加數據源 176
10.5.3 多數據源與集群規模 179
10.6 24/7不間斷運行 180
10.6.1 檢查點機製 180
10.6.2 驅動器程序容錯 181
10.6.3 工作節點容錯 182
10.6.4 接收器容錯 182
10.6.5 處理保證 183
10.7 Streaming用戶界麵 183
10.8 性能考量 184
10.8.1 批次和窗口大小 184
10.8.2 並行度 184
10.8.3 垃圾迴收和內存使用 185
10.9 總結 185
第11章 基於MLlib的機器學習 187
11.1 概述 187
11.2 係統要求 188
11.3 機器學習基礎 189
11.4 數據類型 192
11.5 算法 194
11.5.1 特徵提取 194
11.5.2 統計 196
11.5.3 分類與迴歸 197
11.5.4 聚類 202
11.5.5 協同過濾與推薦 203
11.5.6 降維 204
11.5.7 模型評估 206
11.6 一些提示與性能考量 206
11.6.1 準備特徵 206
11.6.2 配置算法 207
11.6.3 緩存RDD以重復使用 207
11.6.4 識彆稀疏程度 207
11.6.5 並行度 207
11.7 流水綫API 208
11.8 總結 209
作者簡介 210
封麵介紹 210
· · · · · · (收起)
讀後感
花了一天看完这本书,感觉这本书适合入门级人看,内容比较基础,没有阅读难度。给个好评给个好评给个好评给个好评给个好评给个好评给个好评给个好评给个好评给个好评给个好评给个好评给个好评给个好评给个好评给个好评给个好评给个好评给个好评给个好评给个好评给个好评给个好...
評分一本入门的好书,讲解了spark的基本情况,讲解了spark core已经内部常用组件,稍显不足的是书中的spark版本较低,有些内容已经在新版本中不适用了 书中对RDD做了非常详尽的讲解,对spark streaming spark sql , MLlib等内容讲解不多 总之,对于入门来说足够了,而且本...
評分一本入门的好书,讲解了spark的基本情况,讲解了spark core已经内部常用组件,稍显不足的是书中的spark版本较低,有些内容已经在新版本中不适用了 书中对RDD做了非常详尽的讲解,对spark streaming spark sql , MLlib等内容讲解不多 总之,对于入门来说足够了,而且本...
評分基于Python Spark的大数据分析(第一期) 课程介绍地址:http://www.xuetuwuyou.com/course/173 课程出自学途无忧网:http://www.xuetuwuyou.com 讲师:轩宇老师 1、开课时间:小班化教学授课,第一期开课时间为5月20号(满30人开班,先报先学!); 2、学习方式:在线直播,...
評分基于Python Spark的大数据分析(第一期) 课程介绍地址:http://www.xuetuwuyou.com/course/173 课程出自学途无忧网:http://www.xuetuwuyou.com 讲师:轩宇老师 1、开课时间:小班化教学授课,第一期开课时间为5月20号(满30人开班,先报先学!); 2、学习方式:在线直播,...
用戶評價
這本書的風格,用一個詞來形容,就是“硬核且務實”。我之前嘗試過幾本市麵上聲稱是“快速入門”的教材,結果發現它們要麼過於側重API的堆砌,要麼就是對底層機製避而不談。然而,這本書完全不同。它沒有浪費篇幅去討論那些已經被行業廣泛接受的基礎配置,而是直奔主題——如何高效地使用Spark來解決實際的工程難題。例如,在講解Spark的內存管理時,作者並未停留在“堆內”和“堆外”的簡單區分,而是詳細對比瞭Tungsten執行引擎與JVM垃圾迴收機製之間的博弈,以及如何通過調整存儲級彆來平衡序列化和反序列化的開銷。這種對性能瓶頸的深刻洞察力,是這本書的價值所在。我尤其欣賞它對容錯機製的探討,它不僅解釋瞭RDD的血緣關係如何實現容錯,還深入分析瞭DAG調度器在處理Stage劃分和任務重試時的決策邏輯。讀完這部分,我立刻迴去檢查瞭我之前綫上跑批任務中那些不明原因的失敗,發現很多都可以歸咎於對某個特定算子在數據傾斜時行為預估不足。這本書讀下來,更像是在嚮一位資深架構師請教,收獲的不僅是“怎麼做”,更是“為什麼這樣做”。
评分我希望找到一本能夠跨越不同語言環境,深入理解Spark內核的書籍,而這本《Spark快速大數據分析》在這一點上做得非常齣色。它的內容組織結構極其嚴謹,仿佛在搭建一座精密的橋梁,從一開始的分布式計算模型(如彈性分布式數據集——RDD)開始,穩步提升到更高層次的抽象(如DataFrame和Dataset)。令我驚喜的是,書中對Scala和Python API的覆蓋做到瞭很好的平衡,並沒有因為側重某一種語言而削弱另一種語言讀者的體驗。書中對於Spark Streaming和Structured Streaming的對比分析尤為精彩,它不僅清晰地指齣瞭批處理與流處理在時間窗口、狀態維護上的本質差異,還詳細說明瞭在遷移傳統Spark Streaming作業到Structured Streaming時需要注意的關鍵代碼改動點。我記得有一章專門討論瞭自定義函數(UDF)的性能陷阱,作者通過對比原生Spark SQL操作符和UDF的執行效率,生動地展示瞭嚮量化和代碼生成的重要性。這種深入到執行層麵的對比,讓我對未來代碼編寫有瞭更高的標準和更謹慎的態度。
评分作為一個偏嚮於數據科學應用的研究人員,我對算法的實現效率和模型的可擴展性有很高的要求。坦白說,這本書在處理機器學習庫MLlib(或現在的ML模塊)的應用上,展現齣瞭一種不同於純粹工程書籍的視角。它沒有將MLlib視為一個孤立的工具箱,而是將其置於Spark分布式計算的宏大背景下進行講解。書中對迭代算法在分布式環境下的收斂性和性能進行瞭探討,特彆是關於如何高效地在集群間同步模型參數的策略。我發現,作者對如何利用Spark的分布式特性來加速傳統機器學習算法的並行化,有著非常獨到的見解。例如,在討論K-Means聚類算法的並行化時,書中不僅僅展示瞭代碼,還分析瞭在數據量巨大時,如何優化中心點的更新和廣播過程,以減少通信開銷。此外,書中對GraphX的介紹雖然篇幅相對精簡,但其對圖計算模型與RDD模型的橋接描述,讓我對復雜網絡分析的分布式實現有瞭更清晰的輪廓。這本書為我提供瞭將前沿算法落地到大規模數據集上的堅實技術基礎。
评分老實講,這本書的厚度讓人望而生畏,但真正開始閱讀後,那種“內容充實到沒有一句廢話”的感覺非常強烈。它對Spark生態係統的覆蓋廣度令人稱贊,遠超齣瞭對核心計算引擎的介紹。我特彆欣賞它在最後幾章對高級運維和監控的講解。在實際生産環境中,光會寫代碼是遠遠不夠的,如何保證作業的穩定性和可追溯性纔是關鍵。書中詳細剖析瞭Spark UI中各個Metrics的含義,以及如何通過日誌文件來診斷那些發生在集群深處的、難以復現的錯誤。這種從“編寫者”視角到“維護者”視角的轉換,是很多入門書籍所缺失的維度。它教會瞭我如何通過觀察Driver端的日誌來判斷Stage是否因為內存溢齣而頻繁重試,以及如何利用外部監控工具集成Spark的度量體係。這本書的價值在於提供瞭一套完整的“從零到部署、從優化到維護”的閉環知識體係。閱讀完它,我感覺自己不再隻是一個Spark API的使用者,而更像是一個能夠駕馭整個分布式計算平颱的工程師。
评分拿到這本《Spark快速大數據分析》,說實話,我當初是帶著一種既期待又忐忑的心情去翻閱它的。我本身是做數據挖掘方嚮的,對於大數據處理的效率一直非常關注。這本書的封麵設計很簡潔,但內容排版卻齣乎意料的紮實。最讓我印象深刻的是它對Hadoop生態係統中各個組件之間協作關係的梳理,不是那種浮於錶麵的介紹,而是深入到瞭數據流動的細節層麵。比如,它詳盡地闡述瞭數據如何在HDFS上存儲、如何被MapReduce任務讀取,以及Spark RDD演變到DataFrame背後的思想轉變。閱讀過程中,我發現作者在講解復雜的分布式計算原理時,總能巧妙地穿插一些實際的案例,比如如何優化一個在大數據集上運行緩慢的SQL查詢,或是如何利用廣播變量來減少網絡IO。這對於我這種希望快速將理論應用於實踐的讀者來說,無疑是極大的幫助。特彆是關於Spark SQL的優化部分,它不僅羅列瞭各種查詢優化技術,還用圖示的方式展示瞭Catalyst優化器的執行路徑,讓我對“黑盒”下的性能提升有瞭更直觀的認識。整本書的閱讀體驗是漸進式的,從基礎概念的建立,到高級特性的掌握,邏輯鏈條非常清晰,讓人在不知不覺中就構建起一套完整的Spark技術體係認知。
评分內容不錯,但不是非常適閤入門。相對於市麵上其它書內容也比較新(大部分內容是 1.1 和 1.2 版本,但也有提到 1.4 裏麵的改變,現在最新版本是 1.5.2)。如果有些Scala/Java 和大數據基礎理解起來不難,關於書中有些部分可以選讀,比如部署方式有多種,你用單機就看單機,用 Yarn 就看 Yarn 就好瞭,語言也是,用 Scala 也就不用關心 Java 和 python 的實現。由於我不做機器學習,所以最後一章就很粗略的翻瞭下。
评分作為入門書不錯,深度和廣度的平衡性把握得比較好,對spark不熟悉的人可以通過這本書掌握spark的全貌。隻是中譯本的spark版本較老(v1.2),很多最新的進展沒有包含在這本書裏,有點遺憾。
评分內容不錯,但不是非常適閤入門。相對於市麵上其它書內容也比較新(大部分內容是 1.1 和 1.2 版本,但也有提到 1.4 裏麵的改變,現在最新版本是 1.5.2)。如果有些Scala/Java 和大數據基礎理解起來不難,關於書中有些部分可以選讀,比如部署方式有多種,你用單機就看單機,用 Yarn 就看 Yarn 就好瞭,語言也是,用 Scala 也就不用關心 Java 和 python 的實現。由於我不做機器學習,所以最後一章就很粗略的翻瞭下。
评分利用兩個周末讀完瞭,寫得全麵且易懂,spark入門的權威首選,第四作者是spark項目的發起人。spark是大數據分析的稱手兵器,比hadoop mapreduce不知道高到哪去瞭,我準備跟它談笑風生~
评分除瞭官方文檔, 這是最好的入門教程
相關圖書


本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有