
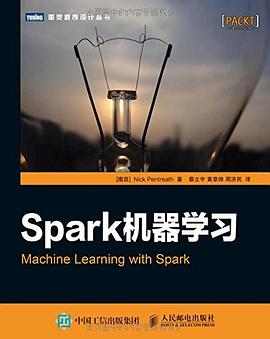
Spark机器学习 pdf epub mobi txt 电子书 下载 2026
- 机器学习
- Spark
- 大数据
- 计算机
- 数据分析
- 数据挖掘
- mllib
- python
- Spark
- 机器学习
- 大数据
- 人工智能
- 数据科学
- 机器学习算法
- 分布式计算
- 编程
- Scala
- Python

具体描述
本书每章都设计了案例研究,以机器学习算法为主线,结合实例探讨了Spark 的实际应用。书中没有让人抓狂的数据公式,而是从准备和正确认识数据开始讲起,全面涵盖了推荐系统、回归、聚类、降维等经典的机器学习算法及其实际应用。
作者简介
Nick Pentreath
是Graphflow公司联合创始人。Graphflow是一家大数据和机器学习公司,专注于以用户为中心的推荐系统和客户服务智能化技术。Nick拥有金融市场、机器学习和软件开发背景,曾任职于高盛集团,之后去在线广告营销创业公司Cognitive Match Limited(伦敦)担任研究科学家,后又去非洲最大的社交网络Mxit领导数据科学与分析团队。Nick是Apache Spark项目管理委员会成员之一。
目录信息
1.1 Spark的本地安装与配置 2
1.2 Spark集群 3
1.3 Spark编程模型 4
1.3.1 SparkContext类与SparkConf 类 4
1.3.2 Spark shell 5
1.3.3 弹性分布式数据集 6
1.3.4 广播变量和累加器 10
1.4 Spark Scala编程入门 11
1.5 Spark Java编程入门 14
1.6 Spark Python编程入门 17
1.7 在Amazon EC2上运行Spark 18
1.8 小结 23
第2章 设计机器学习系统 24
2.1 MovieStream介绍 24
2.2 机器学习系统商业用例 25
2.2.1 个性化 26
2.2.2 目标营销和客户细分 26
2.2.3 预测建模与分析 26
2.3 机器学习模型的种类 27
2.4 数据驱动的机器学习系统的组成 27
2.4.1 数据获取与存储 28
2.4.2 数据清理与转换 28
2.4.3 模型训练与测试回路 29
2.4.4 模型部署与整合 30
2.4.5 模型监控与反馈 30
2.4.6 批处理或实时方案的选择 31
2.5 机器学习系统架构 31
2.6 小结 33
第3章 Spark上数据的获取、处理与准备 34
3.1 获取公开数据集 35
3.2 探索与可视化数据 37
3.2.1 探索用户数据 38
3.2.2 探索电影数据 41
3.2.3 探索评级数据 43
3.3 处理与转换数据 46
3.4 从数据中提取有用特征 48
3.4.1 数值特征 48
3.4.2 类别特征 49
3.4.3 派生特征 50
3.4.4 文本特征 51
3.4.5 正则化特征 55
3.4.6 用软件包提取特征 56
3.5 小结 57
第4章 构建基于Spark的推荐引擎 58
4.1 推荐模型的分类 59
4.1.1 基于内容的过滤 59
4.1.2 协同过滤 59
4.1.3 矩阵分解 60
4.2 提取有效特征 64
4.3 训练推荐模型 67
4.3.1 使用MovieLens 100k数据集训练模型 67
4.3.2 使用隐式反馈数据训练模型 68
4.4 使用推荐模型 69
4.4.1 用户推荐 69
4.4.2 物品推荐 72
4.5 推荐模型效果的评估 75
4.5.1 均方差 75
4.5.2 K值平均准确率 77
4.5.3 使用MLlib内置的评估函数 81
4.6 小结 82
第5章 Spark构建分类模型 83
5.1 分类模型的种类 85
5.1.1 线性模型 85
5.1.2 朴素贝叶斯模型 89
5.1.3 决策树 90
5.2 从数据中抽取合适的特征 91
5.3 训练分类模型 93
5.4 使用分类模型 95
5.5 评估分类模型的性能 96
5.5.1 预测的正确率和错误率 96
5.5.2 准确率和召回率 97
5.5.3 ROC曲线和AUC 99
5.6 改进模型性能以及参数调优 101
5.6.1 特征标准化 101
5.6.2 其他特征 104
5.6.3 使用正确的数据格式 106
5.6.4 模型参数调优 107
5.7 小结 115
第6章 Spark构建回归模型 116
6.1 回归模型的种类 116
6.1.1 最小二乘回归 117
6.1.2 决策树回归 117
6.2 从数据中抽取合适的特征 118
6.3 回归模型的训练和应用 123
6.4 评估回归模型的性能 125
6.4.1 均方误差和均方根误差 125
6.4.2 平均绝对误差 126
6.4.3 均方根对数误差 126
6.4.4 R-平方系数 126
6.4.5 计算不同度量下的性能 126
6.5 改进模型性能和参数调优 127
6.5.1 变换目标变量 128
6.5.2 模型参数调优 132
6.6 小结 140
第7章 Spark构建聚类模型 141
7.1 聚类模型的类型 142
7.1.1 K-均值聚类 142
7.1.2 混合模型 146
7.1.3 层次聚类 146
7.2 从数据中提取正确的特征 146
7.3 训练聚类模型 150
7.4 使用聚类模型进行预测 151
7.5 评估聚类模型的性能 155
7.5.1 内部评价指标 155
7.5.2 外部评价指标 156
7.5.3 在MovieLens数据集计算性能 156
7.6 聚类模型参数调优 156
7.7 小结 158
第8章 Spark应用于数据降维 159
8.1 降维方法的种类 160
8.1.1 主成分分析 160
8.1.2 奇异值分解 160
8.1.3 和矩阵分解的关系 161
8.1.4 聚类作为降维的方法 161
8.2 从数据中抽取合适的特征 162
8.3 训练降维模型 169
8.4 使用降维模型 172
8.4.1 在LFW数据集上使用PCA投影数据 172
8.4.2 PCA和SVD模型的关系 173
8.5 评价降维模型 174
8.6 小结 176
第9章 Spark高级文本处理技术 177
9.1 处理文本数据有什么特别之处 177
9.2 从数据中抽取合适的特征 177
9.2.1 短语加权表示 178
9.2.2 特征哈希 179
9.2.3 从20新闻组数据集中提取TF-IDF特征 180
9.3 使用TF-IDF模型 192
9.3.1 20 Newsgroups数据集的文本相似度和TF-IDF特征 192
9.3.2 基于20 Newsgroups数据集使用TF-IDF训练文本分类器 194
9.4 评估文本处理技术的作用 196
9.5 Word2Vec 模型 197
9.6 小结 200
第10章 Spark Streaming在实时机器学习上的应用 201
10.1 在线学习 201
10.2 流处理 202
10.2.1 Spark Streaming介绍 202
10.2.2 使用Spark Streaming缓存和容错 205
10.3 创建Spark Streaming应用 206
10.3.1 消息生成端 207
10.3.2 创建简单的流处理程序 209
10.3.3 流式分析 211
10.3.4 有状态的流计算 213
10.4 使用Spark Streaming进行在线学习 215
10.4.1 流回归 215
10.4.2 一个简单的流回归程序 216
10.4.3 流K-均值 220
10.5 在线模型评估 221
10.6 小结 224
· · · · · · (收起)
读后感
深入浅出Spark机器学习实战(用户行为分析) 课程观看地址:http://www.xuetuwuyou.com/course/144 课程出自学途无忧网:http://www.xuetuwuyou.com 一、课程目标 熟练掌握SparkSQL的各种操作,深入了解Spark内部实现原理 深入了解SparkML机器学习各种算法模型的构建和运行...
评分深入浅出Spark机器学习实战(用户行为分析) 课程观看地址:http://www.xuetuwuyou.com/course/144 课程出自学途无忧网:http://www.xuetuwuyou.com 一、课程目标 熟练掌握SparkSQL的各种操作,深入了解Spark内部实现原理 深入了解SparkML机器学习各种算法模型的构建和运行...
评分我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看过了 我看...
评分深入浅出Spark机器学习实战(用户行为分析) 课程观看地址:http://www.xuetuwuyou.com/course/144 课程出自学途无忧网:http://www.xuetuwuyou.com 一、课程目标 熟练掌握SparkSQL的各种操作,深入了解Spark内部实现原理 深入了解SparkML机器学习各种算法模型的构建和运行...
评分深入浅出Spark机器学习实战(用户行为分析) 课程观看地址:http://www.xuetuwuyou.com/course/144 课程出自学途无忧网:http://www.xuetuwuyou.com 一、课程目标 熟练掌握SparkSQL的各种操作,深入了解Spark内部实现原理 深入了解SparkML机器学习各种算法模型的构建和运行...
用户评价
坦白说,我最初接触这类技术书籍时,常常会被那些晦涩难懂的术语和密密麻麻的数学公式吓退,很多书读起来就像在啃一本加密文件。然而,这本书的叙述风格却像是一位经验极其丰富且极富耐心的导师,坐在你身边,用最日常、最接地气的方式为你剖析深奥的原理。作者似乎深谙“教是最好的学”这一道理,他总能找到最恰当的比喻来解释那些抽象的机器学习模型。比如,他解释正则化项时,不是直接堆砌L1、L2范数的定义,而是用“给一个过于自信的预测者戴上紧箍咒”来形象描述其作用,让人会心一笑之余,立马领会了其核心思想。行文节奏把握得极其到位,不会因为某些基础概念的重复讲解而显得拖沓,也不会在关键的理论突破点上草草收场。每一次公式的推导,作者都会附带一句“我们为什么要这么做”,这种对“为什么”的持续追问,远比单纯的“怎么做”更有价值,它培养的是读者的批判性思维,而不是机械化的操作能力。读完几章后,我感觉自己不再是被动接受知识的容器,而是一个主动探索世界奥秘的同行者。
评分这本书的排版和装帧设计简直让人眼前一亮,那种沉甸甸的质感,拿在手里就感觉分量十足,绝不是那种轻飘飘的快餐读物可以比拟的。封面设计上采用了一种略带磨砂质感的深蓝色调,配上烫金的字体,透露出一种低调的奢华和专业感。我尤其欣赏的是内页的用纸,触感细腻,墨迹清晰,即便是长时间阅读也不会觉得眼睛疲劳。更值得称赞的是,作者在内容组织上的匠心独运,章节之间的逻辑衔接处理得如同精密的齿轮咬合,严丝合缝,让人在翻阅的过程中,能清晰地感受到知识体系的层层递进。比如,对于某个复杂算法的引入,作者没有直接抛出公式,而是先通过一个生动的现实场景进行铺垫,这种“先感性认知,后理性分析”的引导方式,极大地降低了初学者的入门门槛。而且,书中大量的图表和示意图,绘制得极其精美且信息密度高,很多抽象的概念通过这些可视化工具,瞬间变得清晰明了。我发现,即便是需要反复研读的章节,其图文排布也经过了周密的考量,关键信息点被巧妙地用不同字重或颜色块突出显示,使得重点突出,脉络分明。这本书的制作水平,完全体现了对读者的尊重,让人愿意花时间去品味和收藏。
评分我必须强调这本书在实战案例选择上的独到眼光。很多教程的案例往往局限于MNIST手写数字识别或者Iris鸢尾花分类,这些经典的“Hello World”虽然入门友好,但对于希望提升实战能力的读者来说,深度和广度都略显不足。这本书则不然,它大胆地引入了一些更贴近现代工业应用场景的复杂数据集和问题,例如,如何处理带有时间序列特征的金融波动预测,或者如何构建一个能够处理非结构化文本数据的推荐系统框架。更难得的是,作者在展示代码实现时,不仅仅是贴出能运行的脚本,而是深入到代码的每一层设计考量。他会详细解释为什么选择Python的某个特定库而不是另一个,为什么在这种数据规模下要优先考虑内存优化,甚至会讨论不同并行化策略之间的性能权衡。这种深层次的“黑箱拆解”,让读者真正理解了代码背后的工程哲学。我感觉自己不是在学习一个工具的使用手册,而是在观察一位资深工程师如何从零开始,规划、构建并优化一个完整的机器学习项目,收获的不仅是技术栈,更是解决实际问题的思维路径。
评分对于一个长期在技术圈子里摸爬滚打的读者来说,衡量一本技术书籍的价值,最终要看它能否带来“知识的迁移性”。这本书在这方面做得极其出色,它没有将重点局限在某一特定框架的API调用上,而是着力于传授那些具有普适性的“元技能”。例如,关于特征工程的章节,作者探讨的并非某个数据集的最佳预处理流程,而是深入分析了数据缺失值的填补策略背后的概率假设,以及高维稀疏数据如何影响模型收敛速度的底层机制。这些核心概念一旦掌握,就可以轻松迁移到任何新的领域或框架中去应用和创新。书中反复强调的那些关于模型选择、偏差方差权衡、以及如何设计有效评估指标的讨论,都属于机器学习方法论的基石。读完之后,我感觉自己看问题的视角被提升了一个层次,不再仅仅关注于“跑通代码”,而是开始思考“这个模型背后的假设是否成立”以及“如何设计一个更鲁棒的实验来验证我的猜想”。这种思维层面的跃迁,是任何速成教程都无法给予的宝贵财富。
评分这本书的理论深度达到了一个非常令人尊敬的高度,但其最可贵之处在于,它成功地搭建了一座坚实的桥梁,连接了纯粹的数学理论与高效的工程实践。很多学术著作过于偏重证明和推导,读起来枯燥乏味,而一些实战指南又过于“工具化”,缺乏对底层原理的敬畏。这本书巧妙地平衡了两者。例如,在介绍支持向量机(SVM)的对偶问题时,作者并未回避KKT条件和拉格朗日乘子法,但他会用非常直观的几何解释来辅助理解这些复杂的数学工具是如何自然而然地导出最优解的边界条件的。这种处理方式让读者在理解数学严谨性的同时,不会迷失在公式的海洋里。此外,书中对算法的局限性讨论也十分坦诚和深刻。作者没有将任何模型神化,而是清晰地指出了何时应该使用A算法,何时转向B算法,以及在特定约束条件下,C算法的潜在风险是什么。这种实事求是的态度,培养了读者在面对真实世界数据不确定性时,应有的审慎和判断力。
评分#机器学习
评分必须给五星,正适合我这种刚对机器学习了解一点理论却不知道如何下手实践的人,讲了特征抽取,推荐系统,分类聚类回归,文本处理等很多实践技巧。。。
评分可操性不错
评分确实没什么卵用
评分跟别的实践性(python系列)机器学习书差不多,基本上能告诉我MLLIB能干什么。 理论知识比较浅,需要结合其它书来深入学习。 将希望能在实际工作中有所帮助。
相关图书



本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈图书下载中心 版权所有