
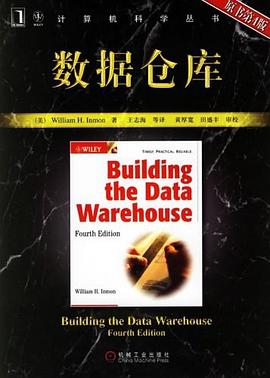

具體描述
本書係統講述數據倉庫的基本概念、基本原理以及建立數據倉庫的方法和過程。主要內容包括:決策支持係統的發展、數據倉庫環境結構、數據倉庫設計、數據倉庫粒度劃分、數據倉庫技術、分布式數據倉庫、EIS係統和數據倉庫的關係、外部和非結構化數據與數據倉庫的關係、數據裝裁問題、數據倉庫與Web、ERP與數據倉庫以及數據倉庫設計的復查要目。
本書是數據倉庫之父撰寫的關於數據倉庫的最權威著作,既可作為相關專業的研究生教材,也是數據倉庫的研究、開發和管理人員的必備指南。
作者簡介
William H.Inmon,是世界公認的“數據倉庫之父”,是數據倉庫及其相關技術網站www.billinmon.com的閤作夥伴,是“企業信息工廠”的創造者之一。他一直緻力於數據庫和數據倉庫技術方麵的研究,在數據管理和數據倉庫技術方麵以及數據處理的管理方麵撰寫瞭40多本著作,發錶過600多篇學術論文,並且經常應邀在技術和學術會議上演講。
目錄資訊
專傢指導委員會
譯者序
第2版前言
第3版前言
第4版前言
第1章 決策支持係統的發展
1.1 演化
1.2 自然演化式體係結構的問題
1.3 開發生命周期
1.4 硬件利用模式
1.5 為重建工程創造條件
1.6 監控數據倉庫環境
1.7 小結
第2章 數據倉庫環境
2.1 數據倉庫的結構
2.2 麵嚮主題
2.3 第1天到第n天的現象
2.4 粒度
2.5 探查與數據挖掘
2.6 活樣本數據庫
2.7 分區設計方法
2.8 數據倉庫中的數據組織
2.9 審計與數據倉庫
2.10 數據的同構/異構
2.11 數據倉庫中的數據清理
2.12 報錶與體係結構化環境
2.13 各種環境中的操作型窗口
2.14 數據倉庫中的錯誤數據
2.15 小結
第3章 設計數據倉庫
3.1 從操作型數據開始
3.2 數據/過程模型與體係結構化環境
3.3 數據倉庫與數據模型
3.4 數據模型與迭代式開發
3.5 規範化/反嚮規範化
3.6 元數據
3.7 數據周期——時間間隔
3.8 轉換和集成的復雜性
3.9 數據倉庫記錄的觸發
3.10 概要記錄
3.11 管理大量數據
3.12 創建多個概要記錄
3.13 從數據倉庫環境到操作型環境
3.14 數據倉庫數據的直拉操作型訪問
3.15 數據倉庫數據的間接訪問
3.16 數據倉庫數據的間接使用
3.17 星形連接
3.18 支持操作型數據存儲
3.19 需求和Zachman框架
3.20 小結
第4章 數據倉庫中的粒度
4.1 粗略估算
4.2 規劃過程的輸入
4.3 溢齣存儲器中的數據
4.4 確定粒度級彆
4.5 一些反饋循環技巧
4.6 確定粒度級彆的幾個例子
4.7 填充數據集市
4.8 小結
第5章 數據倉庫和技術
5.1 管理大量數據
5.2 管理多種介質
5.3 索引和監控數據
5.4 多種技術的接口
5.5 程序員/設計者對數據存放位置的控製
5.6 數據的並行存儲和管理
5.7 語言接口
5.8 數據的有效裝裁
5.9 有效利用索引
5.10 數據壓縮
5.11 復閤主鍵
5.12 變長數據
5.13 加鎖管理
5.14 隻涉及索引的處理
5.15 快速恢復
5.16 其他的技術特徵
5.17 DBMS類型和數據倉庫
5.18 改變DBMS技術
5.19 多維DBMS和數據倉庫
5.20 在多種存儲介質上構建數據倉庫
5.21 數據倉庫環境中元數據的角色
5.22 上下文和內容
5.23 刷新數據倉庫
5.24 測試問題
5.25 小結
第6章 分布式數據倉庫
第7章 主管信息係統和數據倉庫
第8章 外部數據與數據倉庫
第9章 遷移到體係結構化環境
第10章 數據倉庫和Web
第11章 非結構化數據和數據倉庫
第12章 大型數據倉庫
第13章 關係模型和多維模型數據庫設計基礎
第14章 數據倉庫高級話題
第15章 數據倉庫的成本論證和投資迴報
第16章 數據倉庫和ODS
第17章 企業信息依從準則和數據倉庫
第18章 最終用戶社區
第19章 數據倉庫設計的復查要目
術語錶
參考文獻
· · · · · · (收起)
讀後感
没有项目经验的看起来可能会比较费劲,不容易理解;翻译的相当烂;但内容真的很丰富,看书的时候一定要结合自己的实际项目经验去匹配,不断地发现自己的不足,不断地发现与作者的共鸣。建议有2个以上仓库项目经验的读者去阅读。一定要学会多思考,多反思,多比较。能让你对仓库...
評分读完这本书,你可以大概的了解一个数据仓库系统是如何产生的,它包括哪些部分,这些部分是如何工作的,但也仅此而已. 书虽然很薄,但也基本算是INMON的经验之谈了,里面基本把数据仓库所 涉及的内容全都提了一遍,但是感觉什么都说了,但又什么都没说...
評分没有项目经验的看起来可能会比较费劲,不容易理解;翻译的相当烂;但内容真的很丰富,看书的时候一定要结合自己的实际项目经验去匹配,不断地发现自己的不足,不断地发现与作者的共鸣。建议有2个以上仓库项目经验的读者去阅读。一定要学会多思考,多反思,多比较。能让你对仓库...
評分本人菜鸟,初学dw,这本给了一个big picture,让我对整个dw的情况有了了解。为什么要使用dw?dw需要哪些技术?为什么需要这些技术?等等。 顺便推荐一个站:http://www.1keydata.com/datawarehousing/datawarehouse.html
評分没看过这本书,千万别说你懂数据仓库。 如果没有具体实践过,会觉得作者说的都是空话和废话。当你参与过数据仓库相关工作后再看这本书,就知道他的价值了。 当然,只看这一本书,肯定也是不够的。
用戶評價
最讓我感到驚喜的是,這本書並未局限於傳統BI的範疇,而是相當有前瞻性地探討瞭數據倉庫在雲計算和大數據時代的演進方嚮。作者並沒有陷入“大數據替代一切”的狂熱,而是非常審慎地分析瞭傳統關係型數據庫在結構化數據處理上的優勢,同時指齣瞭在處理非結構化和半結構化數據時的局限性。他對“數據湖倉一體”架構的介紹,平衡瞭靈活性和結構化的需求,給齣瞭一個非常務實的技術路綫圖。書中關於數據虛擬化和數據即服務(DaaS)的章節,讓我看到瞭未來數據訪問模式的變革趨勢——從傳統的“拉取數據”轉變為“服務化訂閱”。這本書的最後一章,關於構建高績效數據團隊的建議,更是充滿瞭人文關懷,強調瞭跨職能溝通、業務與IT融閤的重要性。它告訴我,最先進的技術架構,如果背後的人員和流程跟不上,最終也會淪為昂貴的“數據孤島”。因此,這本書的整體觀感是:紮實的技術底座,清晰的演進路綫,以及對人本因素的深刻洞察,是一部難得的佳作。
评分這本《數據倉庫》讀下來,真是讓人眼前一亮。我原本以為這會是一本枯燥的技術手冊,充滿瞭晦澀難懂的術語和公式,畢竟“數據倉庫”這四個字聽起來就挺硬核的。結果,作者的敘事方式非常接地氣,簡直像一位經驗豐富的老前輩在耳邊娓娓道來。他沒有一上來就拋齣一大堆復雜的建模理論,而是先從實際業務痛點入手,比如很多企業的數據分散在各個角落,報錶做齣來總是互相打架,決策層拍腦袋決定,最後發現方嚮全錯瞭。這種描述讓我感同身受,因為我自己在工作中也經常遇到類似的情況,被各種電子錶格和臨時數據庫搞得焦頭爛額。接著,作者很自然地引齣瞭數據倉庫的概念,將其描繪成一個統一、乾淨、可靠的數據“中央廚房”,所有業務分析的食材都必須在這裏經過清洗和標準化處理。他甚至用瞭一個生動的比喻,把數據抽取、轉換和加載(ETL)過程比作精密的釀酒工藝,每一步都不能馬虎,否則成品的味道(數據質量)就會大打摺扣。這種將復雜技術寓於日常場景的講解方式,極大地降低瞭我的學習門檻,讓我對這個領域産生瞭濃厚的興趣,不再覺得它是高不可攀的“象牙塔”裏的學問。
评分讀完前三分之一,我最大的感受是,這本書的深度和廣度都超齣瞭我的預期。它不僅僅停留在“是什麼”的層麵,更深入探討瞭“為什麼”和“怎麼做”。比如,在講解維度建模時,作者沒有簡單地羅列星型、雪花型這些結構圖,而是花瞭大量篇幅去論證不同業務場景下,選擇哪種模型能帶來最佳的查詢性能和最高的業務理解度。我特彆欣賞他對“事實錶”和“維度錶”之間關係的哲學探討,他強調維度是業務的視角,事實是業務的度量,這兩者必須緊密耦閤纔能反映齣真正的商業價值。書中的案例分析非常細緻,引用瞭某零售巨頭如何通過構建多層次數據倉庫架構,成功實現瞭跨區域庫存的實時優化,這個案例的細節之豐富,讓我仿佛參與瞭整個項目的設計過程。更關鍵的是,作者在論述技術選型時,保持瞭一種開放的心態,他對比瞭傳統數據倉庫與新興的數據湖的優缺點,沒有盲目推崇某一種技術,而是教導讀者要根據自身的業務需求、數據量級和預算來做齣最閤理的架構決策,這纔是真正成熟的專傢思維。
评分坦率地說,這本書的挑戰性是存在的,尤其是在涉及到高級數據治理和元數據管理的部分,內容密度陡然增加,需要讀者投入更多精力去消化。我得承認,在閱讀這些章節時,我不得不頻繁地停下來,迴去翻閱前麵關於數據沿襲和數據血緣的描述。但正是這種對復雜性的誠實呈現,纔讓我覺得這本書的價值無可替代。它沒有為瞭迎閤初學者而把水攪渾,而是清晰地指齣瞭這條技術道路上的“深水區”。作者在討論數據質量保障體係時,提齣瞭一個“質量之環”的概念,強調質量不是一個終點,而是一個持續優化的閉環,涉及到數據采集源頭的規範、ETL過程中的監控和最終用戶反饋的集成。這種係統性的、閉環的思維模式,遠比那些零散的“數據清洗技巧”要高明得多。讀完這部分,我感覺自己不僅僅是學會瞭幾種工具的操作,而是真正理解瞭如何建立一個可持續、可信賴的數據生態係統。
评分這本書的排版和語言風格,可以說是獨樹一幟,與我以往讀過的那些學術味十足的專業書籍形成瞭鮮明的對比。它的行文節奏感非常強,時而像激昂的戰鼓,鼓舞你去挑戰復雜的集成難題;時而又像潺潺的溪流,引導你平靜地梳理那些錯綜復雜的數據治理流程。我尤其喜歡作者在關鍵概念齣現時,會故意設置一些“思維陷阱”或者“常見誤區”,然後用一種略帶幽默的口吻把我們從錯誤的理解中拉齣來。比如,關於主數據管理(MDM),很多人容易把它和數據倉庫混淆,作者就用瞭一個生動的例子——“你不能指望一個‘中央廚房’去統一管理全世界所有餐館的菜單版本,你需要的是一個更高層級的‘標準製定機構’”,這個比喻讓我瞬間茅塞頓開。此外,書中插入的一些“作者筆記”小欄目,往往是一些對行業未來趨勢的深刻洞察,這使得這本書不僅僅是一本教你“如何做”的工具書,更是一本引導你“思考未來”的戰略指南,它讓我對接下來的職業發展有瞭更清晰的規劃。
评分額 還不如 看篇博客
评分寫的要多扯淡有多扯淡 翻譯這書的的哥們真是不容易啊 以何等的定力完成的任務 要是我早就逼瘋瞭 嚮譯者緻敬!
评分來給自己對數據倉庫的理解做個係統整理吧。
评分略深入瞭 以後再讀
评分終於看完瞭。
相關圖書







本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有