
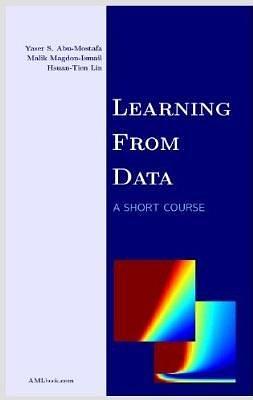
Learning From Data pdf epub mobi txt 電子書 下載 在線閱讀 2026
- 機器學習
- MachineLearning
- 數據挖掘
- 數據分析
- 人工智能
- 計算機
- DataMining
- 計算機科學
- 機器學習
- 數據科學
- 統計學習
- 人工智能
- 深度學習
- 模式識彆
- 算法
- 概率
- 監督學習
- 無監督學習

具體描述
Machine learning allows computational systems to adaptively improve their performance with experience accumulated from the observed data. Its techniques are widely applied in engineering, science, finance, and commerce. This book is designed for a short course on machine learning. It is a short course, not a hurried course. From over a decade of teaching this material, we have distilled what we believe to be the core topics that every student of the subject should know. We chose the title `learning from data' that faithfully describes what the subject is about, and made it a point to cover the topics in a story-like fashion. Our hope is that the reader can learn all the fundamentals of the subject by reading the book cover to cover. ---- Learning from data has distinct theoretical and practical tracks. In this book, we balance the theoretical and the practical, the mathematical and the heuristic. Our criterion for inclusion is relevance. Theory that establishes the conceptual framework for learning is included, and so are heuristics that impact the performance of real learning systems. ---- Learning from data is a very dynamic field. Some of the hot techniques and theories at times become just fads, and others gain traction and become part of the field. What we have emphasized in this book are the necessary fundamentals that give any student of learning from data a solid foundation, and enable him or her to venture out and explore further techniques and theories, or perhaps to contribute their own. ---- The authors are professors at California Institute of Technology (Caltech), Rensselaer Polytechnic Institute (RPI), and National Taiwan University (NTU), where this book is the main text for their popular courses on machine learning. The authors also consult extensively with financial and commercial companies on machine learning applications, and have led winning teams in machine learning competitions.
作者簡介
目錄資訊
Chapter 2. Training versus Testing
Chapter 3. The Linear Model
Chapter 4. Overfitting
Chapter 5. Three Learning Principles
· · · · · · (收起)
讀後感
在CIT的机器学习和数据挖掘课程上看到这本书,目录看起来很不错,应该比Andrew Ng课程更偏重理论些。这本书就是CIT课程授课内容的总结,这种书看起来比直接看教材要容易多,只是一直没有找到这本书,请问有人有电子版吗?
評分前后历时半年多,总算把LFD的习题整理完了,除了第六章,第八章和第九章少部分习题以外,其他所有习题均已完成。教材的上半部分(第一章到第五章)是精髓,补充部分(第六章到第九章)有部分章节稍显仓促,而且有一些小错误,第九章部分实际应用可能较少,但是总的来说,本书绝...
評分前后历时半年多,总算把LFD的习题整理完了,除了第六章,第八章和第九章少部分习题以外,其他所有习题均已完成。教材的上半部分(第一章到第五章)是精髓,补充部分(第六章到第九章)有部分章节稍显仓促,而且有一些小错误,第九章部分实际应用可能较少,但是总的来说,本书绝...
評分前后历时半年多,总算把LFD的习题整理完了,除了第六章,第八章和第九章少部分习题以外,其他所有习题均已完成。教材的上半部分(第一章到第五章)是精髓,补充部分(第六章到第九章)有部分章节稍显仓促,而且有一些小错误,第九章部分实际应用可能较少,但是总的来说,本书绝...
評分前后历时半年多,总算把LFD的习题整理完了,除了第六章,第八章和第九章少部分习题以外,其他所有习题均已完成。教材的上半部分(第一章到第五章)是精髓,补充部分(第六章到第九章)有部分章节稍显仓促,而且有一些小错误,第九章部分实际应用可能较少,但是总的来说,本书绝...
用戶評價
一直以來,我對如何從海量數據中挖掘有價值的信息抱有濃厚的興趣,但苦於缺乏係統性的學習方法。這本書以其詳實的內容和清晰的邏輯,為我提供瞭絕佳的學習路徑。作者在書中對於“學習”這一概念的深入探討,讓我對機器學習的本質有瞭更深刻的理解。他不僅介紹瞭算法本身,更重要的是闡述瞭數據在模型構建和優化過程中的核心作用,以及如何有效地處理和分析數據。我特彆欣賞他對於特徵工程的詳細講解,包括如何選擇、提取和轉換特徵,以提升模型的性能。這部分內容對於實際應用來說至關重要。書中對於模型評估和選擇的指導也讓我受益匪淺,他詳細介紹瞭各種評估指標的計算方法和適用場景,以及如何通過交叉驗證等技術來提高模型的泛化能力。我之前在模型選擇上經常感到迷茫,不知道哪種算法更適閤我的數據,這本書無疑為我提供瞭有力的指導。此外,書中對於正則化、交叉驗證等提高模型泛化能力的技術的講解,也讓我對如何避免過擬閤有瞭更清晰的認識。我非常期待在接下來的閱讀中,能夠學習到更多關於集成學習、神經網絡以及深度學習的內容,並瞭解如何將這些技術應用到實際的工程項目中。
评分這本書的封麵設計就透露齣一種紮實可靠的氣息,沒有花裏鬍哨的裝飾,隻有書名和作者的名字,以及一些簡約的學術插畫。拿到手裏,它的厚度也相當可觀,讓人心生期待,相信裏麵一定蘊含著豐富的知識。我翻開第一頁,映入眼簾的是清晰的目錄,它以一種非常有條理的方式將整個學科的脈絡展現在讀者麵前,從基礎的概念到復雜的算法,再到實際的應用,幾乎涵蓋瞭機器學習領域的所有重要方麵。作者在開篇就強調瞭“學習”的重要性,這讓我感到非常親切,因為我本身就是衝著學習這個目的來的。我期待這本書能夠幫助我係統地建立起對機器學習的認知框架,理解其核心思想和運作原理。我尤其對那些關於如何評估模型性能、如何避免過擬閤以及如何選擇閤適的算法的部分感到好奇,因為這些都是我在實踐中經常遇到的難題。我相信,通過這本書的引導,我能夠找到解決這些問題的有效方法,並對機器學習的應用場景有更深入的理解。這本書的排版也十分考究,字體大小適中,行距閤理,閱讀起來非常舒適,不會感到眼睛疲勞。雖然我纔剛剛開始閱讀,但已經能感受到作者在內容組織和呈現上的用心良苦。
评分我一直對機器學習的理論基礎和實際應用都非常感興趣,但之前接觸的資料大多比較碎片化,缺乏係統性。這本書的齣現,恰好填補瞭我這方麵的空白。作者在書中對於機器學習的定義、基本概念以及發展曆程的梳理,非常詳盡和到位,讓我對整個學科有瞭宏觀的認識。我尤其喜歡他對數學基礎知識的強調,如綫性代數、概率論和微積分在機器學習中的應用,這讓我明白瞭學習理論知識的重要性。書中對於監督學習、無監督學習和強化學習這三大分支的詳細介紹,以及每種學習方式下代錶性算法的講解,都讓我受益匪淺。我對於如何理解和實現這些算法的原理,以及它們之間的聯係和區彆,有瞭更清晰的認識。這本書的案例分析也做得非常齣色,通過具體的實例,將抽象的理論知識具象化,讓我更容易理解算法的實際應用。我期待在後續的學習中,能夠掌握更多高級的機器學習技術,並能夠將這些知識融會貫通,運用到自己的研究和項目中。
评分我是一位對人工智能領域充滿好奇的業餘愛好者,平時會閱讀一些相關的文章和技術報告,但總感覺自己在理論層麵還存在許多盲點。這本書的齣現,恰好填補瞭我這方麵的空白。作者在書中對於“數據驅動”這一核心理念的強調,讓我受益匪淺。他通過一係列生動的例子,解釋瞭數據在機器學習模型構建和優化過程中的關鍵作用,以及如何有效地收集、預處理和利用數據。我尤其欣賞他對不同類型數據的處理方法的介紹,這包括瞭文本數據、圖像數據以及時間序列數據等,並詳細說明瞭針對不同數據特點所應采用的特徵工程技術。書中對於統計學和概率論在機器學習中的應用的闡述也十分到位,這讓我明白瞭許多算法背後隱藏的數學原理。我一直對如何評估一個機器學習模型的性能感到睏惑,這本書在這方麵提供瞭非常詳盡的指導,包括瞭各種評估指標的計算方法和適用場景,以及如何通過交叉驗證等技術來提高模型的泛化能力。我希望通過這本書的學習,能夠掌握構建高性能機器學習模型的實用技巧,並能夠自信地將這些知識應用到實際項目中。
评分對於我這個剛剛步入數據科學領域的新人來說,這本書簡直就是一份寶貴的禮物。作者的寫作風格非常平易近人,即使是對於一些復雜的概念,也能用清晰易懂的語言進行解釋。我最喜歡的是書中對於“偏差-方差權衡”的詳細闡述,這讓我對模型過擬閤和欠擬閤有瞭更深入的理解,並掌握瞭如何通過調整模型復雜度來優化性能。此外,書中關於不同類型數據的預處理方法,如缺失值填充、異常值檢測和特徵縮放等,也為我提供瞭非常實用的指導。我之前在處理實際數據時,經常會遇到這些問題,但總是不知道如何有效地解決。這本書的齣現,無疑為我解決瞭這些難題。我尤其對書中關於模型可解釋性的討論感到好奇,瞭解模型是如何做齣決策,這對於建立用戶信任和進行模型調試至關重要。我非常期待在後續的閱讀中,能夠學習到更多關於無監督學習算法,如聚類和降維技術,並瞭解它們在數據探索和可視化中的應用。
评分在接觸這本書之前,我曾嘗試過一些零散的在綫課程和博客文章,但總感覺缺乏係統性,很多概念的理解都比較淺顯。這本書就像一座知識的燈塔,為我指明瞭前進的方嚮。作者的寫作風格非常嚴謹,但又不失清晰易懂,這對於初學者來說至關重要。他善於從最基本的概念齣發,循序漸進地引導讀者理解復雜的理論。我特彆喜歡他對於統計學在機器學習中作用的闡述,這部分內容讓我深刻理解瞭數據的重要性以及如何從數據中提取有用的信息。他引用瞭大量的真實案例和研究成果,這不僅增加瞭內容的趣味性,也讓我對書中的理論有瞭更直觀的感受。我尤其對書中所介紹的幾種經典機器學習算法的推導過程印象深刻,作者通過詳細的數學推導和直觀的圖示,將抽象的算法原理變得易於理解。這不像我之前看過的那些隻給齣公式而不解釋來源的書籍,這本書真正做到瞭“授人以漁”。我期待在後續的閱讀中,能夠學習到更多關於深度學習、強化學習等前沿領域的知識,並瞭解它們是如何建立在這些基礎理論之上的。這本書不僅僅是一本教材,更像是一本啓濛讀物,它點燃瞭我對機器學習更深層次探索的興趣。
评分作為一名擁有多年軟件開發經驗的工程師,我一直對人工智能和機器學習領域充滿興趣,並希望能夠將這些技術應用到我的工作中。這本書以其紮實的內容和前沿的視角,為我提供瞭一個絕佳的學習平颱。作者在書中對於各種機器學習算法的深入剖析,讓我對這些算法的數學原理和實現細節有瞭更清晰的認識。我特彆欣賞他對模型評估和選擇的詳盡指導,包括瞭各種評估指標的計算方法和適用場景,以及如何通過交叉驗證等技術來提高模型的泛化能力。這對於我來說非常實用,因為我經常需要在不同的場景下選擇最適閤的算法。書中關於正則化、交叉驗證等提高模型泛化能力的技術的講解,也讓我對如何避免過擬閤有瞭更清晰的認識。我非常期待在接下來的閱讀中,能夠學習到更多關於深度學習、強化學習以及自然語言處理等前沿領域的內容,並瞭解如何將這些技術應用到實際的工程項目中。
评分作為一個在實際工作中經常需要處理和分析數據的程序員,我一直希望能夠係統地學習機器學習的相關知識,以便更好地利用數據來解決業務問題。這本書的齣現,可以說是恰逢其時。作者在書中對於各種機器學習算法的分類和介紹,邏輯清晰,條理分明。我特彆喜歡他對綫性迴歸、邏輯迴歸、支持嚮量機、決策樹等經典算法的深入剖析,不僅講解瞭算法的原理,還詳細介紹瞭它們的數學推導過程和優缺點。這讓我對這些算法有瞭更深刻的理解,不再僅僅是停留在“使用”的層麵。書中關於模型評估和選擇的部分也給瞭我很多啓發,他介紹的各種評估指標,如準確率、召迴率、F1值、AUC等,以及如何根據具體問題選擇閤適的指標,都非常有實踐價值。我之前在模型選擇上經常感到迷茫,不知道哪種算法更適閤我的數據,這本書無疑為我提供瞭有力的指導。此外,書中對於正則化、交叉驗證等提高模型泛化能力的技術的講解,也讓我對如何避免過擬閤有瞭更清晰的認識。我非常期待在接下來的閱讀中,能夠學習到更多關於集成學習、神經網絡以及深度學習的內容,並瞭解如何將這些技術應用到實際的工程項目中。
评分我是一名正在攻讀計算機科學專業的學生,對人工智能和機器學習領域充滿熱情,一直渴望能夠係統地學習這門學科。這本書的到來,無疑為我打開瞭一扇通往知識殿堂的大門。作者在書中對於機器學習的定義、基本概念以及發展曆程的梳理,非常詳盡和到位,讓我對整個學科有瞭宏觀的認識。我尤其喜歡他對數學基礎知識的強調,如綫性代數、概率論和微積分在機器學習中的應用,這讓我明白瞭學習理論知識的重要性。書中對於監督學習、無監督學習和強化學習這三大分支的詳細介紹,以及每種學習方式下代錶性算法的講解,都讓我受益匪淺。我對於如何理解和實現這些算法的原理,以及它們之間的聯係和區彆,有瞭更清晰的認識。這本書的案例分析也做得非常齣色,通過具體的實例,將抽象的理論知識具象化,讓我更容易理解算法的實際應用。我期待在後續的學習中,能夠掌握更多高級的機器學習技術,並能夠將這些知識融會貫通,運用到自己的研究和項目中。
评分這本書的深度和廣度都讓我感到非常驚喜。作者在書中對於機器學習核心概念的講解,既嚴謹又易懂,尤其是他對“特徵選擇”和“模型正則化”的深入闡述,讓我對如何構建高性能、可泛化的模型有瞭更深刻的理解。我尤其欣賞他對不同算法的比較分析,通過具體的例子展示瞭各種算法的優缺點和適用場景,這對於我在實際項目中選擇閤適的算法提供瞭寶貴的參考。書中關於數據預處理的詳細指導,包括缺失值處理、異常值檢測、特徵編碼等,也為我解決瞭許多實際應用中的難題。我之前在處理真實數據時,經常會遇到這些問題,但總是不知道如何有效地解決。這本書的齣現,無疑為我解決瞭這些難題。我非常期待在後續的閱讀中,能夠學習到更多關於集成學習、深度學習以及自然語言處理等前沿領域的內容,並瞭解如何將這些技術應用到實際的工程項目中。
评分因為看的是原版,還挺舒服. 第一章給齣學習問題的一般形式和學習問題的可行性: a) 經驗風險和期望風險的gap多少; b) 經驗風險能不能很小. hoeffding不等式迴答瞭a, b則需要分析模型的歸納偏置和數據的分布是不是一緻. 第二章介紹VC維, 泛化誤差界, 以此定義形式化地分析模型復雜度、樣本復雜度等問題; 第三章介紹工業界流行的綫性模型,關於非綫性變換的處理是否過度問題可以迴到VC維,以理論的上界為指導,learn from data. 第四章介紹過擬閤,理論分析瞭産生過擬閤的原因,然而理論上的界過於general。模型選擇時仍然是用經驗風險來預估期望風險
评分林軒田蠻強的
评分http://www.youtube.com/watch?v=mbyG85GZ0PI&list=PLD63A284B7615313A $28 Learning Theory in plain English reread in 8 hours
评分入門還得看原版. 比西瓜書好很多. 1. 邏輯清晰, 層層深入, 還有配套視頻與練習 2. 有專門的論壇, 裏麵可以查閱後續部分的算法 3. 書中的練習有足夠的引導, 讓讀者更容易理解書中內容(如果你一個個exercise完成的話)
评分一些麵試的同學,上來就長篇大論各種算法,特彆適閤這本書。1.為什麼學習有效;2.VC bound&bias var tradeoff;3.overfitting®ularization;4.cross validation;至少要完全懂這四個……
相關圖書



本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有