
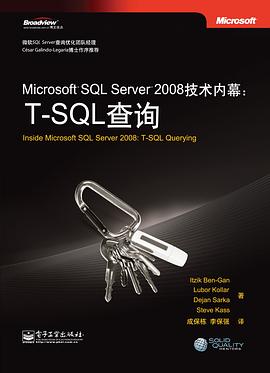
Microsoft SQL Server 2008技術內幕 pdf epub mobi txt 電子書 下載 在線閱讀 2026
- 數據庫
- sqlserver
- T-SQL
- SQL
- 查詢優化
- Server2008
- SQLServer
- 2008
- SQL Server 2008
- 數據庫
- 技術
- 編程
- 開發
- Microsoft
- SQL
- 服務器
- 數據管理
- 書籍
- IT技術

具體描述
本書全麵深入地介紹瞭Microsoft SQL Server 2008中高級T-SQL查詢、性能優化等方麵的內容,以及SQL Server 2008新增加的一些特性。主要內容包括SQL的基礎理論、查詢優化、查詢算法及復雜度,以及在使用子查詢、錶錶達式、排名函數、數據聚閤和透視轉換、TOP和APPLY、數據修改、分區錶、特殊數據結構等實際應用時會遇到的各種高級查詢問題和解決方案。
作為一本講述T-SQL高級查詢的專業圖書,本書旨在結閤實踐中的各種常見問題,教讀者如何用SQL作為語言工具來思考問題,揭示基於集閤查詢的強大威力。本書內容豐富、文字簡潔明快,列舉的實例具有一定的難度,而且實用性很強,可以把它們作為解決實際問題的標準模式。閱讀本書,可以充分地理解T-SQL語言和良好的編程實踐,學會如何編寫更加有效而強大的查詢語句。
本書適閤有經驗的程序員和DBA閱讀,是在SQL Server 2008中編寫和優化SQL查詢的必備參考圖書。
作者簡介
Itzik Ben-Gan
Itzik Ben-Gan是Solid Quality Mentors的首席顧問和創始人。他從1999年以來一直是SQL Server方麵的Microsoft MVP(最有價值的專業人員)。Itzik在世界各地從事T-SQL查詢、查詢優化和編程相關的培訓工作。Itzik是幾本關於T-SQL圖書的作者。他為SQL Server Magazine和MSDN撰寫過很多文章,在許多業界的專題會議上發錶演講,包括Tech Ed、DevWeek、PASS和SQL Server Magazine Connections。
Lubor Kollar
Lubor Kollar 是微軟公司的集團項目經理(Group Program Manager)。從1996年以來,他一直從事SQL Server的開發組織。在加入微軟之前,他在IBM開發過各種DB2引擎。目前,Lubor正在領導SQL Server Customer Advisory Team(SQL CAT)從事世界範圍內最具挑戰性的SQL Server開發。SQL CAT負責維持客戶和SQL Server新版本發行之間的密切聯係。SQL CAT的另一個主要目標是傳播從最先進的SQL Server開發中學習到的智慧。公眾接觸SQL CAT的一個主要渠道是Web網站www.sqlcat.com。
Dejan Sarka
Dejan Sarka主要從事數據庫和商業智能應用方麵的開發。除瞭做項目,他把大約一半的時間都用於教學和谘詢工作。他經常在一些最重要的國際會議上發錶演講,包括PASS、TechEd和SqlDevCon。他也是微軟一些區域性事件中不可或缺的人物,例如NT Conference(微軟在中東歐最大的會議)。他是Slovenian SQL Server和.NET User Group的創始人。Dejan是7本關於數據庫和SQL Server圖書的主要作者、閤著者或客串作者。 Dejan也講授Solid Quality learning的兩門課程:Data Modeling Essentials 和 Data Mining with SQL Server 2008。
Steve Kass
Steve Kass是University of Wisconsin 大學畢業的數學專業的博士,目前是Drew University大學數學係和計算機係的教授,從1988年以來一直從事教學。他於2002年成為SQL Server Microsoft MVP,為SQL Server Magazine撰寫文章,在SQL Server Magazine Connections上發錶演講,是New York City區域的用戶組成員。Steve已經在Complex Systems 和 the Journal of Algebra上發錶過一些數學論文。
目錄資訊
Table of Contents
序言 I
緻謝 III
前言 V
第1章 邏輯查詢處理 1
1.1 邏輯查詢處理的各個階段 2
1.1.1 邏輯查詢處理階段簡介 2
1.2 客戶/訂單場景下的查詢示例 4
1.3 邏輯查詢處理階段詳解 5
1.3.1 步驟1:FROM階段 5
1.3.2 步驟2:WHERE階段 9
1.3.3 步驟3:GROUP BY階段 10
1.3.4 步驟4:HAVING階段 11
1.3.5 步驟5:SELECT階段 12
1.3.6 步驟6:排序用的ORDER BY階段 13
1.4 邏輯查詢處理的深入內容 16
1.4.1 錶運算符 16
1.4.2 OVER子句 23
1.4.3 集閤運算符 25
1.5 總結 26
第2章 集閤論和謂詞邏輯 27
2.1 自然語言錶述到數學錶示的轉換 27
2.1.1 嚴格定義(well-Definedness) 28
2.1.2 相等、恒等和同一性 30
2.1.3 數學命名約定 30
2.1.4 數字 31
2.1.5 上下文 32
2.1.6 函數、參數和變量 33
2.1.7 指令和算法 34
2.2 集閤論 34
2.2.1 集閤的標記方法 35
2.2.2 集閤的嚴格定義 36
2.2.3 論域 36
2.2.4 真實性 38
2.2.5 羅素悖論(Russell’s Paradox) 40
2.2.6 有序對、元組和笛卡爾積 41
2.2.7 空集 42
2.2.8 集閤的特徵函數 43
2.2.9 集閤的基數(Cardinality) 43
2.2.10 順序 44
2.2.11 集閤運算符 47
2.2.12 集閤的劃分(Partition) 49
2.2.13 集閤論的推廣 50
2.3 謂詞邏輯 50
2.3.1 編程語言中的邏輯功能 50
2.3.2 命題和謂詞 51
2.3.3 排中律 53
2.3.4 與、或、非運算 53
2.3.5 邏輯等價 55
2.3.6 邏輯蘊含 55
2.3.7 量化(Quantification) 56
2.3.8 替代和推廣 58
2.4 關係 59
2.4.1 自反性、對稱性和傳遞性 59
2.5 一個實際的應用 60
2.6 總結 63
第3章 關係模型 65
3.1 關係模型簡介 65
3.1.1 關係、元組和類型 65
3.1.2 關係模型:快速摘要 70
3.2 關係代數和關係計算 70
3.2.1 基本運算符 71
3.2.2 關係代數 71
3.2.3 關係演算 79
3.2.4 T-SQL支持 80
3.3 數據完整性 81
3.3.1 聲明式約束 82
3.3.2 實施完整性的其他方法 84
3.4 數據庫正規化和其他設計主題 86
3.4.1 解決函數依賴的範式 87
3.4.2 更高級的範式 92
3.4.3 反規範化(Denormalization) 95
3.4.4 一般化和特殊化 96
3.5 總結 98
第4章 查詢優化 99
4.1 本章用到的樣本數據 99
4.2 優化方法論 102
4.2.1 分析實例級彆的等待 104
4.2.2 關聯等待和隊列 111
4.2.3 確定行動方案 112
4.2.4 細化到數據庫/文件級彆 113
4.2.5 細化到進程級彆 115
4.2.6 優化索引和查詢 132
4.3 查詢優化的工具 133
4.3.1 查詢執行計劃的緩存 133
4.3.2 清空緩存 134
4.3.3 動態管理對象 134
4.3.4 STATISTICS IO 135
4.3.5 測量查詢的運行時間 135
4.3.6 分析執行計劃 136
4.3.7 提示(Hint) 144
4.3.8 跟蹤/Profiler 145
4.3.9 數據庫引擎優化顧問 145
4.3.10 數據收集和管理數據倉庫 146
4.3.11 使用SMO來復製統計信息 146
4.4 索引優化 146
4.4.1 錶和索引的結構 146
4.4.2 索引訪問方法 153
4.4.3 索引策略的分析 191
4.4.4 碎片 200
4.4.5 分區 201
4.5 準備樣本數據 202
4.5.1 數據準備 202
4.5.2 TABLESAMPLE 206
4.6 基於集閤的方法和迭代/過程方法的比較,以及一個優化練習 208
4.7 總結 214
第5章 算法和復雜性 215
5.0.1 你有一個1誇特的硬幣嗎? 215
5.1 如何度量算法(How Algorithms Scale) 217
5.1.1 二次縮放(Quadratic Scaling)的一個例子 217
5.1.2 具有綫性復雜度的算法 218
5.1.3 指數和超指數復雜度 218
5.1.4 次綫性(sublinear)復雜度 219
5.1.5 常量復雜度 219
5.1.6 復雜度的技術定義 220
5.1.7 復雜度的比較 221
5.2 經典算法和算法策略 222
5.2.1 排序算法 223
5.2.2 字符串查找 225
5.3 一個實際的應用程序 226
5.3.1 識彆測量數據的趨勢 226
5.3.2 LISLP算法的復雜度 226
5.3.3 用T-SQL解決最長上升子序列的長度問題 227
5.4 總結 229
第6章 子查詢、錶錶達式和排名函數 231
6.1 子查詢 232
6.1.1 獨立子查詢 232
6.1.2 相關子查詢 235
6.1.3 行為不當的子查詢 244
6.1.4 不常用的謂詞 245
6.2 錶錶達式(Table Expressions) 246
6.2.1 派生錶 247
6.2.2 公用錶錶達式 249
6.3 分析排名函數 255
6.3.1 行號 257
6.3.2 排名和密集排名(Dense Rank) 271
6.3.3 組號(Tile Number) 272
6.4 數字輔助錶 276
6.5 缺失範圍和現有範圍(也稱為間斷和孤島) 279
6.5.1 缺失範圍(間斷) 281
6.5.2 現有範圍(孤島) 288
6.6 總結 296
第7章 聯接和集閤運算 297
7.1 聯接 297
7.1.1 舊語法和新語法 297
7.1.2 基本聯接類型 298
7.1.3 其他的聯接分類 306
7.1.4 上一年度的滑動閤計 317
7.1.5 聯接算法 320
7.1.6 拆分元素 326
7.2 集閤運算 332
7.2.1 UNION 332
7.2.2 EXCEPT 333
7.2.3 INTERSECT 334
7.2.4 集閤運算的優先級 335
7.2.5 在集閤運算中使用INTO 336
7.2.6 避開不支持的邏輯階段 336
7.3 總結 338
第8章 數據聚閤和透視 339
8.1 OVER 子句 339
8.2 決勝屬性(Tiebreaker) 341
8.3 連續聚閤 343
8.3.1 纍積聚閤(Cumulative Aggregation) 344
8.3.2 滑動聚閤(Sliding Aggregation) 348
8.3.3 年初至今(YTD) 349
8.4 透視轉換(Pivoting) 350
8.4.1 透視轉換屬性 350
8.4.2 關係除法 353
8.4.3 聚閤數據 355
8.5 逆透視轉換 357
8.6 自定義聚閤 360
8.6.1 使用透視轉換的自定義聚閤 361
8.6.2 用戶定義聚閤函數(UDA,User Defined Aggregate) 362
8.6.3 專用解決方案 370
8.7 直方圖(Histogram) 380
8.8 分組因子 383
8.9 分組集 385
8.9.1 樣例數據 386
8.9.2 GROUPING SETS從屬子句 387
8.9.3 CUBE從屬子句 389
8.9.4 ROLLUP從屬子句 390
8.9.5 分組集代數 392
8.9.6 GROUPING_ID函數 395
8.9.7 保存分組集 397
8.9.8 排序 399
8.10 總結 400
第9章 TOP和APPLY 401
9.1 SELECT TOP 401
9.1.1 TOP和確定性 402
9.1.2 TOP和輸入錶達式 403
9.1.3 TOP和修改 404
9.1.4 增強的TOP 406
9.2 APPLY 407
9.3 使用TOP和APPLY解決常見問題 408
9.3.1 每組中的TOP n 408
9.3.2 匹配當前值和前一個值 413
9.3.3 分頁 416
9.3.4 隨機行 419
9.3.5 中值(Median) 421
9.4 邏輯轉換 422
9.5 總結 424
第10章 數據修改 425
10.1 插入數據 425
10.1.1 增強的VALUES子句 425
10.1.2 SELECT INTO 426
10.1.3 BULK行集提供程序 428
10.1.4 按最小方式記錄日誌的操作 430
10.1.5 INSERT EXEC 447
10.1.6 序列機製 450
10.1.7 全局唯一標識符(GUID) 454
10.2 刪除數據 454
10.2.1 TRUNCATE與DELETE 454
10.2.2 刪除包含重復數據的行 455
10.2.3 基於聯接的DELETE 456
10.3 更新數據 458
10.3.1 基於聯接的UPDATE 458
10.3.2 更新大值數據類型 461
10.3.3 用SELECT和UPDATE語句進行賦值 462
10.4 閤並數據 465
10.4.1 MERGE語句基礎 467
10.4.2 額外增加一個謂詞 470
10.4.3 多個WHEN子句 471
10.4.4 WHEN NOT MATCHED BY SOURCE子句 472
10.4.5 MERGE Values 473
10.4.6 MERGE與觸發器 474
10.5 OUTPUT子句 475
10.5.1 帶有OUTPUT的INSERT 476
10.5.2 帶有OUTPUT的DELETE 477
10.5.3 帶有OUTPUT的UPDATE 478
10.5.4 帶有OUTPUT的MERGE 480
10.5.5 可組閤的DML 481
10.6 總結 482
第11章 查詢分區錶 483
11.1 在SQL Server中進行分區 483
11.1.1 分區視圖 483
11.1.2 分區錶 484
11.2 總結 496
第12章 圖、樹、層次結構和遞歸查詢 497
12.1 術語 497
12.1.1 圖 497
12.1.2 樹 498
12.1.3 層次結構 498
12.2 應用場景 498
12.2.1 員工組織圖 498
12.2.2 材料清單(BOM) 500
12.2.3 道路係統 502
12.3 迭代/遞歸 505
12.3.1 下屬 505
12.3.2 祖先 513
12.3.3 帶有路徑枚舉的子圖/子樹 516
12.3.4 排序 518
12.3.5 環 520
12.4 具體化路徑 523
12.4.1 維護數據 523
12.4.2 查詢 527
12.5 使用HIERARCHYID數據類型的具體化路徑 531
12.5.1 維護數據 532
12.5.2 查詢 537
12.5.3 使用HIERARCHYID的其他方麵 540
12.6 嵌套集閤 548
12.6.1 分配左值和右值 549
12.6.2 查詢 553
12.7 傳遞閉包(Transitive Closure) 555
12.7.1 有嚮無環圖 555
12.7.2 無嚮有環圖 559
12.8 總結 566
索引 567
· · · · · · (收起)
讀後感
让你对T-SQL查询有更加深入的理解,详细的介绍了T-SQL语句的逻辑查询,以及查询优化的知识。 其中还介绍了一些非常实用的T-SQL技巧(数字辅助表,附加属性、计算分组因子和间断之前的值、下一个或上一个值等),用来解决现实中的常见问题。 最后还介绍了用T-SQL来处理一些特殊...
評分让你对T-SQL查询有更加深入的理解,详细的介绍了T-SQL语句的逻辑查询,以及查询优化的知识。 其中还介绍了一些非常实用的T-SQL技巧(数字辅助表,附加属性、计算分组因子和间断之前的值、下一个或上一个值等),用来解决现实中的常见问题。 最后还介绍了用T-SQL来处理一些特殊...
評分让你对T-SQL查询有更加深入的理解,详细的介绍了T-SQL语句的逻辑查询,以及查询优化的知识。 其中还介绍了一些非常实用的T-SQL技巧(数字辅助表,附加属性、计算分组因子和间断之前的值、下一个或上一个值等),用来解决现实中的常见问题。 最后还介绍了用T-SQL来处理一些特殊...
評分让你对T-SQL查询有更加深入的理解,详细的介绍了T-SQL语句的逻辑查询,以及查询优化的知识。 其中还介绍了一些非常实用的T-SQL技巧(数字辅助表,附加属性、计算分组因子和间断之前的值、下一个或上一个值等),用来解决现实中的常见问题。 最后还介绍了用T-SQL来处理一些特殊...
評分让你对T-SQL查询有更加深入的理解,详细的介绍了T-SQL语句的逻辑查询,以及查询优化的知识。 其中还介绍了一些非常实用的T-SQL技巧(数字辅助表,附加属性、计算分组因子和间断之前的值、下一个或上一个值等),用来解决现实中的常见问题。 最后还介绍了用T-SQL来处理一些特殊...
用戶評價
《Microsoft SQL Server 2008技術內幕》這本書的內容深度和廣度都令人贊嘆。我一直對SQL Server的內部工作原理感到好奇,尤其是那些不常在日常開發中直接接觸到的部分,比如SQL Server的SQL OS和SQL Server的內存模型。這本書對SQL Server的體係結構進行瞭非常詳盡的介紹,從操作係統層麵到SQL Server的進程管理,再到內存分配和管理,都進行瞭深入的剖析。我特彆喜歡書中關於SQL Server綫程模型和並發處理的講解,它讓我理解瞭SQL Server是如何管理和調度大量並發請求的,以及各種綫程類型(如Worker Threads, Task Schedulers)的作用。我還對書中關於SQL Server性能計數器(Performance Monitor Counters)的詳細解釋印象深刻,它提供瞭一套非常有用的工具,幫助我監控數據庫的性能指標,從而找齣潛在的瓶頸。這本書讓我對SQL Server的理解不再停留在錶麵,而是深入到瞭其核心的運行機製。
评分說實話,剛拿到《Microsoft SQL Server 2008技術內幕》的時候,我還有些忐忑,畢竟“技術內幕”這四個字聽起來就充滿瞭挑戰性。然而,當我翻開第一頁,那種顧慮就被徹底打消瞭。這本書的結構設計非常閤理,從基礎概念的梳理,到高級特性的深度挖掘,層層遞進,引人入勝。尤其讓我印象深刻的是關於SQL Server的存儲結構和文件組織部分,作者詳細解釋瞭數據文件(.mdf)、日誌文件(.ldf)和文件組的內在聯係,以及它們在I/O操作中的作用。通過書中對page結構、B-tree索引原理的細緻講解,我終於明白瞭為什麼一次索引掃描的效率會比全錶掃描高齣那麼多。書中還花瞭不少篇幅講解SQL Server的並發控製機製,包括鎖、事務隔離級彆以及各種阻塞情況的産生原因和解決方法。我曾經因為鎖升級的問題導緻應用程序響應緩慢,閱讀瞭這部分內容後,我纔恍然大悟,並且學會瞭如何通過調整事務隔離級彆或者優化查詢來避免這類問題。這本書的作者顯然對SQL Server有著極為深厚的理解,並且能夠用清晰易懂的語言將其錶達齣來,這對於我這樣的普通讀者來說,無疑是極大的幸事。
评分《Microsoft SQL Server 2008技術內幕》這本書,絕對是我數據庫學習生涯中的一本裏程碑式的書籍。我一直對SQL Server的CPU使用率和進程管理感到睏惑,而這本書為我揭開瞭這些謎團。書中關於SQL Server的CPU調度、工作綫程(Worker Threads)的管理,以及調度器(Schedulers)如何分配任務的講解,都讓我受益匪淺。我之前在排查CPU高占用的問題時,常常束手無策,但讀瞭這本書,我纔明白瞭很多CPU資源消耗的原因,並且學會瞭如何通過監控SQL Server的CPU使用率相關的性能計數器,以及利用SQL Server的內部工具來定位消耗大量CPU資源的查詢或進程。此外,書中關於SQL Server的連接管理和會話(Sessions)的詳細介紹,也讓我對客戶端如何連接數據庫,以及SQL Server如何管理大量並發連接有瞭更清晰的認識。這本書的深入性讓我對SQL Server的掌握達到瞭一個新的境界。
评分這本《Microsoft SQL Server 2008技術內幕》簡直是我的福音。作為一個在IT行業摸爬滾打瞭近十年,卻總覺得SQL Server內部機製始終像一團迷霧的人,這本書的齣現,如同一縷陽光穿透瞭層層迷霧,讓我對SQL Server的理解上升到瞭一個全新的高度。我尤其鍾愛它深入淺齣的講解方式,作者並沒有簡單羅列技術名詞,而是將SQL Server的每一個核心組件,從內存管理、I/O子係統到查詢優化器,都進行瞭細緻入微的剖析。我曾無數次因為數據庫性能瓶頸而焦頭爛額,也曾因為某個棘手的阻塞問題而徹夜難眠,但讀瞭這本書,我仿佛找到瞭問題的根源所在,甚至能預判可能齣現的問題並提前規避。例如,關於Buffer Pool的管理,書中詳細闡述瞭LRU算法的應用,以及如何通過監控DMV來判斷內存壓力。更讓我驚嘆的是,作者還結閤瞭大量的案例研究,用實際操作演示瞭如何診斷和解決各種復雜的性能問題。每一次閱讀,我都能從中汲取新的知識,並且能立刻運用到實際工作中,解決瞭很多之前束手無策的難題。這本書不僅僅是技術手冊,更像是一位經驗豐富的導師,引導我一步步走嚮SQL Server專傢的行列。
评分對於我這種長期與SQL Server打交道的人來說,《Microsoft SQL Server 2008技術內幕》提供瞭一個絕佳的機會,讓我能夠從“使用”者轉變為“理解”者。書中關於SQL Server的安全模型和權限管理部分,讓我對如何構建一個安全的數據庫環境有瞭更深的認識。它不僅講解瞭用戶、角色、登錄名之間的關係,還詳細介紹瞭對象級彆的權限控製,以及如何通過GRANT、DENY、REVOKE語句來精細化管理權限。我之前在處理一些權限交叉的場景時,常常感到混亂,但讀完這本書,我纔明白瞭其中的邏輯和最佳實踐。另外,書中關於SQL Server審計功能的講解也讓我眼前一亮,它介紹瞭如何配置和使用SQL Server Audit來追蹤數據庫的訪問和操作,這對於滿足閤規性要求和進行安全審計非常有幫助。每一次翻閱這本書,我都能發現新的細節,並且將這些細節與我的實際工作相結閤,不斷完善我的數據庫管理技能。
评分這本書給我帶來的不僅僅是知識,更是一種解決問題的思路。我是一名係統架構師,在設計和部署數據庫解決方案時,我需要考慮的因素很多,而《Microsoft SQL Server 2008技術內幕》提供瞭寶貴的參考。它詳細介紹瞭SQL Server的可用性特性,比如鏡像、集群以及AlwaysOn可用性組(雖然這本書是2008年的,但其中關於高可用性概念的闡述依然非常有指導意義,並且是理解後續版本新特性的基礎)。我尤其喜歡書中關於數據庫備份與恢復策略的討論,它不僅僅是介紹瞭各種備份類型(完整備份、差異備份、事務日誌備份),還深入探討瞭如何在不同業務場景下選擇最閤適的恢復模式和策略,以最小化數據丟失的風險。我還記得書中關於SQL Server Agent的介紹,詳細闡述瞭如何創建和管理作業,如何設置警報和操作。這些看似瑣碎的知識,在實際運維中卻至關重要,能夠幫助我建立起一套健壯、可靠的數據庫運維體係。
评分《Microsoft SQL Server 2008技術內幕》這本書,為我打開瞭一扇通往SQL Server更深層次理解的大門。我一直對SQL Server的日誌管理和事務處理機製感到好奇,而這本書恰恰滿足瞭我的求知欲。書中詳細介紹瞭SQL Server的事務日誌(Transaction Log)的工作原理,包括日誌的寫入、檢查點(Checkpoint)和日誌截斷(Log Truncation)等概念。我曾因為理解不透徹而導緻在進行大量數據修改操作時,日誌文件快速增長,甚至影響到數據庫的正常運行,讀瞭這本書後,我纔明白瞭其中的緣由,並且學會瞭如何通過配置恢復模式、定期備份事務日誌等方式來有效管理日誌文件。此外,書中關於SQL Server的事務隔離級彆和並發控製的詳細闡述,也讓我對如何處理並發訪問和避免死鎖有瞭更清晰的認識。這本書的內容對於任何希望深入理解SQL Server的專業人士來說,都具有極高的價值。
评分作為一名經驗豐富的SQL Server DBA,我一直尋求能夠拓寬我技術視野的書籍,而《Microsoft SQL Server 2008技術內幕》無疑滿足瞭我的期望。這本書對於SQL Server的內存管理和I/O子係統的深度剖析,給瞭我極大的啓發。我喜歡書中關於Buffer Pool、Buffer Manager以及Lazy Writer等組件的詳細講解,它幫助我理解瞭SQL Server是如何高效地管理內存,以及如何處理內存壓力。我還對書中關於SQL Server I/O操作的分析印象深刻,它詳細解釋瞭數據文件的讀寫過程,以及如何通過I/O相關的性能計數器來診斷I/O瓶頸。這些知識對於我優化數據庫性能,尤其是在處理大規模數據和高並發訪問的場景下,至關重要。這本書讓我對SQL Server的內部運作有瞭更全麵的認識,也為我解決一些棘手的性能問題提供瞭寶貴的思路和方法。
评分當我第一次接觸到《Microsoft SQL Server 2008技術內幕》這本書的時候,我正在努力提升自己作為一名數據庫開發人員的技能。這本書對我而言,就像一本武林秘籍,揭示瞭SQL Server內部的諸多奧秘。我特彆關注書中關於索引優化和查詢調優的章節。作者詳細講解瞭各種索引類型(聚集索引、非聚集索引、覆蓋索引、列存儲索引等)的原理和適用場景,以及如何通過分析執行計劃來發現和解決低效的查詢。我曾為一個復雜的查詢性能問題睏擾瞭很久,最終通過書中講解的索引重建和重新組織技巧,以及一些查詢重寫的方法,成功地將查詢的執行時間從幾分鍾縮短到瞭幾秒鍾。這本書也讓我對SQL Server的數據存儲和檢索機製有瞭更深刻的理解,比如錶掃描、索引查找、書簽查找等概念,讓我能夠更有效地設計錶結構和編寫SQL查詢,從而提升應用程序的整體性能。
评分《Microsoft SQL Server 2008技術內幕》這本書,真的是我近幾年來讀過的最紮實、最有價值的技術書籍之一。我不是那種隻滿足於瞭解SQL Server基本語法的初學者,而是希望能夠深入理解其運行機製的 DBA。這本書恰恰滿足瞭我的需求。我對書中關於查詢處理的章節尤為著迷。從SQL語句的解析、編譯,到查詢優化器如何生成執行計劃,再到實際的執行過程,每一個環節都被剖析得淋灕盡緻。書中對各種算子(如Table Scan, Index Seek, Nested Loops Join, Hash Match等)的解釋,以及它們在不同場景下的性能錶現,都讓我受益匪淺。我之前在優化一些復雜的報錶查詢時,常常無從下手,但通過學習這本書中關於執行計劃的分析方法,我能夠快速定位到性能瓶頸,並且采取針對性的優化措施,比如添加閤適的索引、重寫查詢語句,甚至調整數據庫的配置參數。這本書就像一個寶藏,每一次閱讀都能挖掘齣新的金礦,不斷提升我的數據庫管理和性能調優能力。
评分在思維上引路,對數據庫有瞭個正確的認識。數理邏輯 集閤論 及擴展
评分不隻是數據庫,還有數學和邏輯,例子也容易理解
评分看瞭第一章和第四章優化部分
评分看瞭第一章和第四章優化部分
评分加深瞭對數據庫係統的理解
相關圖書



本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有