
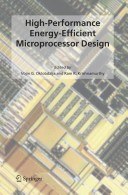
High Performance Energy Efficient Microprocessor Design pdf epub mobi txt 电子书 下载 2026
- Microprocessor Design
- Energy Efficiency
- High Performance
- VLSI
- Computer Architecture
- Low Power Design
- Digital Circuits
- Embedded Systems
- Hardware Design
- Processor Design

具体描述
Written by the world's most prominent microprocessor design leaders from industry and academia, this book provides complete coverage of all aspects of complex microprocessor design: technology, power management, clocking, high-performance architecture, design methodologies, memory and I/O design, computer aided design, testing and design for testability. The chapters provide state-of-the-art knowledge while including sufficient tutorial material to bring non-experts up to speed. A useful companion to design engineers working in related areas.
作者简介
目录信息
读后感
用户评价
如果用一个词来概括这本书给我的感受,那一定是“前瞻性”。它没有过多纠缠于当前主流架构的细枝末节,反而将大量的笔墨放在了尚未完全成熟,但已展现出巨大潜力的领域。例如,书中对类脑计算(Neuromorphic Computing)中脉冲神经网络(SNNs)对脉冲域处理器的能效优势的分析,以及对存内计算(In-Memory Computing)架构的潜在安全与可靠性挑战的审慎探讨,都显示出作者站在了行业最前沿。它似乎在向读者发出一个邀请:不要只满足于优化现有的CMOS逻辑门,而要开始思考计算的物理本质,以及如何在不同的物理范式下实现根本性的能效飞跃。对于我个人而言,这本书提供了一个强大的理论框架,让我能够以更批判性的眼光去评估那些被市场过度炒作的新概念,并找到真正具备颠覆性潜力的研究方向。它不仅是一本关于微处理器设计的书,更是一本关于未来计算范式转型的思想指南。
评分我是在一个极其偶然的机会下接触到这本“高能效微处理器设计”的,当时我正在为我们一个新的边缘AI加速器项目寻找突破口,传统的DSP和GPU方案在功耗墙前都显得力不从心。我本以为这书会充斥着大量的公式推导和繁复的硬件描述语言代码片段,事实证明我的担忧完全是多余的。它最吸引我的地方在于其叙事方式,它没有将技术点孤立地呈现,而是将其嵌入到一个宏大的“系统平衡艺术”的框架下。作者似乎在用讲故事的方式,带领读者参观了一个虚拟的处理器设计实验室,从最初的需求定义阶段开始,就不断地追问“为什么是这个设计,而不是另一个?”这种以问题为导向的讲解方式,极大地降低了理解复杂概念的认知负荷。例如,书中对片上网络(NoC)拓扑结构与数据流模式匹配的章节,没有陷入纯粹的图论证明,而是通过生动的模拟案例,直观展示了错误的路由选择如何导致看似高效的单元资源被低效地阻塞。这种强调“设计意图”而非仅仅“设计实现”的方法论,对于那些渴望从实现者晋升为架构师的专业人士,具有无与伦比的指导价值。
评分说实话,当我翻开这本书时,我的第一反应是“又一本关于低功耗的教材?”。我是一个更偏向于软件和算法优化的人,对底层的寄存器和时序收敛问题通常敬而远之。但这本书成功地跨越了这种壁垒。它真正做到的,是建立了一座坚固的桥梁,连接了上层的软件需求与底层的硅片实现。书中对“动态电压与频率调节(DVFS)”策略的剖析,远比我过去接触到的教科书来得细致和实用。它不仅讨论了如何进行频率缩放,更重要的是,它深入探讨了如何根据编译器优化的代码结构和运行时的数据依赖性,来预测未来的功耗需求,从而实现“先发制人”的电源管理,而不是被动的“亡羊补牢”。这对于我们开发高性能嵌入式系统的团队来说,是一个全新的视角。我们过去总是寄希望于更先进的工艺节点来解决问题,但这本书明确指出,如果不进行系统架构上的重新思考,仅仅依靠工艺进步带来的能效红利正在迅速衰减。这迫使我们团队开始重新审视编译器优化和硬件流水线的耦合方式。
评分这本书的篇幅着实不小,内容密度也相当高,但阅读体验却出奇地流畅。我尤其欣赏作者在关键概念处所做的类比和历史回溯。比如,当探讨内存墙问题与Cache设计时,作者没有满足于介绍L1/L2/L3的常规定义,而是追溯了早期的主存访问模式如何催生了这些层级,以及现代计算模型(如GPU的全局内存访问模式)如何对这些传统层级提出了新的挑战。这种对历史演进的深刻理解,让读者能够更清晰地认识到当前设计中的“历史包袱”和“未来机遇”。它不像某些技术书籍那样,仅仅罗列最新的技术名词,而是深入挖掘每一个设计选择背后的驱动力。对于一个想要深入理解微处理器设计全景图的人来说,这种纵深感是至关重要的。它不仅仅教你“如何做”,更重要的是教你“为什么会变成这样”,以及“未来可能走向何方”。
评分这本书的书名乍一看就让人眼前一亮,充满了对前沿科技的敬畏与期待。作为一名长期关注半导体技术发展的读者,我原以为这是一本专注于优化能耗比的硬核技术手册,可能会深入探讨晶体管级别的功耗削减技巧,或是某个特定指令集架构下的低功耗设计范例。然而,在阅读了书中前几章关于系统级架构权衡的讨论后,我意识到作者的视野远超出了单纯的“绿色计算”范畴。它更像是一部引导设计师跳出传统思维定势的宣言,强调了在当今数据洪流与能源约束并存的背景下,性能与效率不再是简单的线性对立面,而是一个需要通过创新架构来耦合的复杂系统工程。书中对于不同工作负载特征(比如突发性计算与持续性流处理)如何影响缓存层次结构和内存带宽分配的分析,精妙地揭示了隐藏在看似标准设计流程下的效率陷阱。特别是它对“异构计算单元协同调度”的论述,简直是一次对传统冯·诺依曼瓶颈的温和但坚决的挑战,让人不得不重新审视我们正在使用的设计基元。这本书并非简单的工具书,而是一次深刻的哲学思辨,关于如何在有限的物理资源中榨取出无限的计算潜力,这对于任何希望在下一代处理器设计中占据领导地位的工程师来说,都是一份不可或缺的导读。
评分 评分 评分 评分 评分相关图书









本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈图书下载中心 版权所有