
具体描述
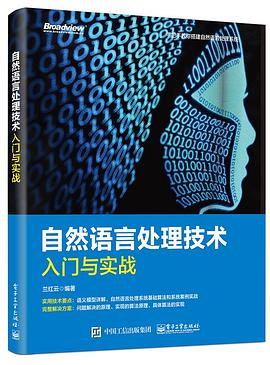
《自然语言处理技术入门与实战》主要从语义模型详解、自然语言处理系统基础算法和系统案例实战三个方面,介绍了自然语言处理中相关的一些技术。对于每一个算法又分别从应用原理、数学原理、代码实现,以及对当前方法的思考四个方面进行讲解。
《自然语言处理技术入门与实战》面向的读者为有志于从事自然语言处理相关工作的在校学生、企事业单位工作人员等人群。本书的结构是由浅入深地进行相关内容的介绍,以满足不同层次读者的学习需求。
作者简介
兰红云,湖北襄阳人。曾任职于猎豹移动,现为阿里影业数据挖掘专家,拥有多年的算法和数据挖掘的工作经验,申请过多项算法专利。研究方向包括自然语言处理和机器学习。
目录信息
第1章关键词抽取模型 3
1.1 TF-IDF算法实现关键词抽取 4
1.2 TextRank算法实现关键词抽取 11
1.3 基于语义的统计语言模型实现关键词抽取 16
第2章短语抽取模型 22
2.1 基于互信息和左右信息熵实现短语抽取 23
2.2 TextRank算法实现短语抽取 28
2.3 LDA算法实现短语抽取 31
第3章自动摘要抽取模型 38
3.1 决策树算法实现自动摘要 39
3.2 基于逻辑回归算法实现自动摘要 44
3.3 贝叶斯算法实现自动摘要 50
第4章深度学习——计算任意词距离模型 55
4.1 FP-Growth算法实现词距离计算 56
4.2 N-Gram算法实现词距离计算 61
4.3 BP算法实现词距离计算 65
第5章拼音汉字混合识别模型 70
5.1 贝叶斯模型实现拼音汉字混合识别 71
5.2 HMM模型实现拼音汉字混合识别 75
5.3 RNN神经网络模型实现拼音汉字混合识别 80
第6章文本自动生成模型 87
6.1 基于关键词的文本自动生成模型 88
6.2 RNN模型实现文本自动生成 93
第2篇自然语言处理系统基础算法
第7章Dijkstra算法 101
7.1 算法应用原理介绍 102
7.2 算法数学原理介绍 102
7.3 算法源码说明 106
7.4 算法应用扩展 107
第8章AC-DoubleArrayTrie算法 108
8.1 算法应用原理介绍 109
8.2 算法数学原理介绍 111
8.3 算法应用扩展 116
第9章最大熵算法 117
9.1 算法应用原理介绍 118
9.2 算法数学原理介绍 119
9.3 算法源码说明 124
9.4 算法应用扩展 125
第10章CRF算法 126
10.1 算法应用原理介绍 127
10.2 算法数学原理介绍 130
10.3 算法源码说明 135
10.4 算法应用扩展 136
第11章马尔可夫逻辑网算法 137
11.1 算法应用原理介绍 138
11.2 算法数学原理介绍 142
11.3 算法源码说明 144
11.4 算法应用扩展 145
第12章DIPRE算法 147
12.1 算法应用原理介绍 148
12.2 算法数学原理介绍 151
12.3 算法源码说明 152
12.4 算法应用扩展 153
第13章LSTM算法 155
13.1 算法应用原理介绍 156
13.2 算法数学原理介绍 158
13.3 算法源码说明 163
13.4 算法应用扩展 165
第14章TransE算法 166
14.1 算法应用原理介绍 167
14.2 算法数学原理介绍 170
14.3 算法源码说明 172
14.4 算法应用扩展 174
第3篇系统案例实战
第15章搭建舆情分析与挖掘的系统 177
15.1 系统功能设计简述 178
15.2 系统模块实现详解 181
15.3 系统实现源码说明 186
· · · · · · (收起)
读后感
用户评价
关于配套资源的缺失,是我认为这本书最大的硬伤之一。一本合格的“实战”书籍,理应提供清晰的GitHub仓库链接,包含所有代码、数据集和预训练模型。然而,我尝试了书中提供的所有链接,发现其中很多已经失效,或者指向的是一个空空如也的Repository。即便找到了一些零星的代码片段,它们也往往是片段式的,缺乏一个完整的、可复现的项目结构。对于任何想通过动手实践来巩固学习效果的读者而言,这无疑是致命的打击。没有一个稳定、可运行的环境作为支撑,书本上的理论知识就只能停留在纸面上,无法真正转化为生产力。我不得不花费大量时间去社区论坛上寻找替代资源,这完全偏离了购买一本教材应该享受到的便利和集成化服务。
这本书在理论阐述部分的逻辑连贯性上存在明显的跳跃性,读起来感觉像是在不同作者的笔记上随意剪贴而成。某些章节对特定概念的解释冗长且晦涩,使用了大量生僻的专业术语,却没有提供足够的上下文背景或直观的比喻来辅助理解。比如,在解释概率图模型时,作者仿佛预设了读者已经拥有深厚的数学基础,直接抛出复杂的转移矩阵和观测概率,对于初学者来说,根本不知道这些数学符号究竟在描述NLP中的哪个具体问题。而另一些看似重要的章节,比如文本表示方法的演进,却又一带而过,关键的数学推导过程直接省略,只给出了最终结论,让人无法深入探究其背后的原理。这种忽而深奥、忽而敷衍的态度,使得整本书的知识体系像是一座由松散沙砾堆砌起来的城堡,结构摇摇欲坠,难以建立起稳固的认知框架。
这本书的排版设计简直是一场视觉的灾难。我得承认,从封面设计到内页布局,都透露着一股浓浓的“赶工期”气息。字体选择上,正文部分使用了那种略显粗糙的衬线体,阅读起来眼睛非常吃力,尤其是在长时间阅读后,干涩感立马就上来了。更要命的是,图表的质量实在不敢恭维。那些用来说明复杂算法流程的示意图,线条模糊不清,标注的小字几乎需要借助放大镜才能辨认,这对于需要理解核心概念的学习者来说,无疑是雪上加霜。很多公式的排版也显得很不规范,上下标的位置经常错位,让人怀疑作者是否真的仔细校对过。这种对阅读体验的漠视,极大地削弱了学习的积极性,我光是适应这种阅读环境就耗费了不少精力,严重影响了对知识的吸收效率。我期待的是一本能让人心甘情愿沉浸其中的专业书籍,而不是这种让人想尽快合上的“劝退读物”。
我原本寄予厚望,希望这本书能提供一些关于现代深度学习模型在自然语言处理领域应用的实战案例,毕竟书名里带有“实战”二字。然而,我所看到的案例大多停留在几年前的基准模型上,比如经典的RNN和LSTM结构,对于Transformer架构的介绍也仅限于概念的罗列,缺乏具体的代码实现细节和调优经验分享。更令人失望的是,很多代码示例在当前的流行框架(比如最新版本的PyTorch或TensorFlow)下根本无法直接运行,需要读者自己去修复大量的兼容性问题和依赖库版本冲突。这种“过时的实战”让人感觉作者对行业前沿的动态把握不够敏锐,或者说,根本没有更新过内容。如果只是想了解基础理论,市面上有太多更清晰、更系统化的教材可供选择,这本书在“实战”这一关键卖点上,可以说完全没有兑现承诺,留给读者的更多是调试代码的挫败感而非掌握新技能的喜悦。
从作者的写作风格来看,似乎更偏向于学术论文的综述,而非面向工程实践的入门指导。语气上缺乏与读者的亲近感,总有一种高高在上的“布道者”姿态。很多章节的表述都非常客观、中立,缺少了那种能激发学习热情的引导性叙述。例如,在讨论词向量的局限性时,作者只是平铺直叙地列举了它的缺点,却没有像一位经验丰富的工程师那样,分享一些在实际项目中如何巧妙绕开这些限制的具体“窍门”或“经验法则”。好的入门书应该像一位耐心的导师,不仅告诉你“是什么”,更重要的是告诉你“为什么”以及“如何做才能避免踩坑”。这本书在这方面明显不足,它更像是一本冷冰冰的参考手册,虽然信息量不小,但温度不够,难以让人产生持续探索的动力和亲近感。
没有源代码,注释有问题,没有勘误
务实,但是有点太简单了
额,至少你告诉我用的什么语言吧。。
额,至少你告诉我用的什么语言吧。。
虽然很粗略,但比较务实。