
具体描述
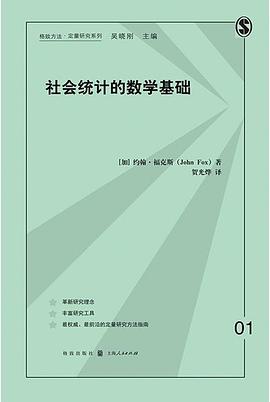
《社会统计的数学基础》是一本集中讨论社会科学研究中的数理基础知识的小册子,其内容涵盖了许多数学和统计学中容易被人忽视却又至关重要的话题,如矩阵、线性代数、积分、概率理论及统计分布等。全书首先介绍了有关矩阵、线性代数和几何向量的基本概念,然后简单回复了一些基础数学,简述了微积分入门知识,接着对应用统计学中广泛运用的概率及统计推理进行了概述,最后阐述了线性小二乘法回归这一统计方法的发展过程。
本书不仅可以协助研究生及社会统计工作者进行研究,而且是对定量方法研究的重要补充。
作者简介
约翰·福克斯(John Fox),加拿大安大略省汉密尔顿市麦克马斯特大学社会学系教授,曾是多伦多市约克大学社会学系、数学系及统计学系的教授。其现阶段的工作包括统计方法研究及加拿大社会研究。曾在众多刊物上发表过文章,诸如《社会学方法》、《计算绘图统计》、《美国统计协会会刊》等。
目录信息
第1章 矩阵、线性代数和几何向量
第1节 矩阵
第2节 基础几何向量
第3节 向量空间与子空间
第4节 矩阵的秩及线性联立方程组的解法
第5节 特征值与特征向量
第6节 二次型及正定矩阵
第7节 推荐阅读
第2章 微积分入门
第1节 回顾
第2节 极限
第3节 函数求导
第4节 最优化
第5节 多变量和矩阵的微分学
第6节 泰勒展式
第7节 积分学的基本思想
第8节 推荐阅读
第3章 概率估计
第1节 初等概率理论
第2节 离散概率分布
第3节 连续分布
第4节 渐进分布理论:初步介绍
第5节 统计估计量的属性
第6节 最大似然估计
第7节 贝叶斯推断
第8节 推荐阅读
第4章 实际应用:线性最小二乘法回归
第1节 最小二乘法拟合
第2节 一个线性回归的统计模型
第3节 作为估计量的最小二乘法系数
第4节 回归模型的统计推断
第5节 回归模型的最大似然法估计
第6节 随机矩阵应用
注释
参考文献
译名对照表
· · · · · · (收起)
读后感
用户评价
这本书的出现,对于我理解社会科学研究中“不确定性”的量化和管理具有重要意义。我尤其关注书中关于“贝叶斯统计”的论述。与传统的频率学派统计方法不同,贝叶斯统计将概率视为一种信念的度量,并通过不断更新先验信息来获得后验信息。我希望书中能够详细介绍贝叶斯推断的基本原理,包括“贝叶斯定理”的应用,以及如何计算先验分布、似然函数和后验分布。我期待书中能够解释,在社会学研究中,什么时候采用贝叶斯方法会比频率学派方法更具优势,例如在样本量较小或者研究问题中存在较强先验知识的情况下。我希望书中能够通过具体的社会学案例,例如估计某个社会群体对某项政策的支持度,来展示如何运用贝叶斯方法进行参数估计和模型构建。我尤其期待书中能够讨论“马尔可夫链蒙特卡洛(MCMC)”等计算方法,它们是实现复杂贝叶斯模型推断的关键。掌握贝叶斯统计的数学基础,将为我提供一种新的视角来理解和处理社会现象中的不确定性。
我一直对“统计模型”在社会学研究中的应用感到着迷,尤其是那些能够解释复杂社会现象的模型。这本书的出现,让我看到了深入了解这些模型背后数学原理的希望。我非常期待书中能够详细介绍“线性回归模型”的构建和解释。在社会学研究中,我们经常试图探究一个变量(因变量)如何被另一个或多个变量(自变量)所影响,例如,探究教育程度是否会影响个体的收入水平,或者社会支持度是否会影响个体的幸福感。线性回归模型恰恰能够提供一个框架来量化这些关系。我希望书中不仅会讲解如何估计回归系数,更会深入阐述这些系数的统计学意义,以及如何进行假设检验来判断这些关系是否具有统计学上的显著性。此外,我也对“多元回归”的讨论抱有浓厚的兴趣。在现实社会中,一个现象往往受到多种因素的综合影响,因此,能够同时考虑多个自变量的多元回归模型显得尤为重要。我希望书中能够解释如何选择合适的自变量,以及如何处理变量之间的共线性问题,这些都是在实际研究中经常遇到的挑战。我对书中关于模型诊断和评估的章节也充满了期待,如何判断一个模型是否拟合得当,以及如何选择最优模型,这些知识对于做出可靠的社会推断至关重要。
在接触社会学研究的过程中,我发现“相关性”和“因果性”是两个非常容易混淆的概念,也是研究中最具挑战性的地方。我希望这本书能够为我提供清晰的数学视角来理解这两者之间的区别。我特别期待书中能够详细解释“相关系数”的计算和解读。例如,皮尔森相关系数如何衡量两个连续变量之间的线性关系强度和方向,以及如何判断这种相关性是否具有统计学意义。我希望书中能够强调,相关性并不意味着因果关系,并阐述其背后的数学原因。我更期待的是,书中能够介绍一些能够帮助我们初步探索因果关系的统计学方法。虽然完全确立因果关系非常困难,但我相信书中会介绍一些数学工具,例如“回归分析中的控制变量”或者“匹配方法”,来帮助我们尽量排除混淆因素的影响,从而更接近因果的解释。我希望书中能够通过具体的社会学案例,例如探究家庭经济状况对青少年学业成绩的影响,来演示如何运用数学方法来分析和解释变量之间的关系,并谨慎地讨论潜在的因果推断。
我一直认为,理解社会统计的数学基础,不仅是为了掌握数据分析的技术,更是为了培养一种严谨的科学思维方式。我希望这本书能够在这方面给我带来启发。我期待书中能够强调,数学公式不仅仅是抽象的符号,它们背后代表着对社会现象的深刻洞察和逻辑推理。我希望书中能够通过对统计学发展历史的简要回顾,以及对不同统计学方法的哲学基础的探讨,来帮助我理解统计学思想的演进。我期待书中能够鼓励我批判性地思考统计结果,不仅仅停留在“是什么”,更能追问“为什么”以及“可能存在哪些局限性”。我希望书中能够通过对统计学伦理问题的讨论,例如如何避免数据误读和滥用,来引导我树立正确的科学研究态度。这本书不仅仅是一本教材,我更希望它能成为我探索社会科学世界的一位良师益友,它能够帮助我以一种更深刻、更具批判性的方式来理解和分析我们所处的社会。
我一直对“时间序列分析”在社会学研究中的应用感到好奇,特别是在分析社会趋势、事件的演变过程等方面。我希望这本书能够为我揭示时间序列数据背后的数学规律。我期待书中能够讲解“平稳性”的概念,以及为什么时间序列数据需要满足平稳性假设。我希望书中能够介绍一些常用的时间序列模型,例如“ARIMA模型”(自回归积分滑动平均模型),并解释其数学构成和参数的含义。例如,如何通过自相关函数(ACF)和偏自相关函数(PACF)来识别合适的ARIMA模型,以及如何使用模型来预测未来的趋势。我希望书中能够结合社会学案例,例如分析犯罪率随时间的变化,或者社会舆论的演变过程,来演示时间序列分析的应用。我特别期待书中能够讨论如何处理时间序列数据中的“季节性”和“周期性”模式,以及如何区分短期波动和长期趋势。了解时间序列分析的数学基础,将有助于我更深入地理解社会现象的动态演变规律。
翻开这本书,我首先被它严谨的逻辑结构所吸引。从目录上看,它似乎是从最基础的数学概念开始,逐步构建起社会统计学的知识体系。我尤其关注书中关于“离散型随机变量”和“连续型随机变量”的讲解,因为这直接关系到我们如何描述和分析不同类型的社会现象。例如,在研究人口的受教育年限时,我们可能需要用到连续型变量的分布,而研究家庭的子女数量时,离散型变量似乎更为合适。我希望书中能够详细解释这些变量类型的选择对于后续统计分析的影响,以及它们各自遵循的概率分布特性。我对于“期望值”和“方差”这两个概念的阐释也充满了期待,它们能够帮助我们量化数据的集中趋势和离散程度,从而更好地理解数据的内在含义。在社会学研究中,我们常常需要对某个群体的平均年龄、收入水平等进行描述,期望值无疑是关键。而方差则能告诉我们这些数值的变异程度,例如,平均收入高固 entanto,如果方差也很大,那说明收入分布非常不均,这对于社会政策的制定具有重要的指导意义。我期待书中能够通过生动的例子,将这些抽象的数学概念与具体的社会问题联系起来,让我深刻体会到数学在理解社会现象中所扮演的角色。
这本书的封面设计倒是挺吸引人的,淡雅的蓝色配上简洁的白色字体,给人一种理性而又专业的感受。我一直对社会学领域中的量化研究充满好奇,但又苦于自己数学基础的薄弱,常常在阅读相关文献时望而却步。这本书的出现,无疑为我打开了一扇新的大门。我期待它能够系统地梳理社会统计学背后所依赖的数学原理,从最基本的概念讲起,逐步深入到更复杂的模型。我特别希望它能解释清楚,为什么我们需要概率论来处理抽样误差,为什么回归分析能够帮助我们理解变量之间的关系,以及如何通过假设检验来做出可靠的推断。这本书的名字本身就充满了吸引力,它不仅仅是一本“如何做”的指南,更是一本“为什么”的探究。我希望作者能够用通俗易懂的语言,结合实际的社会学研究案例,将抽象的数学概念具象化,让我这个非数学专业出身的读者也能理解并掌握其中的精髓。我对于书中关于统计推断的论述尤为期待,如何从有限的样本数据中推断出更广泛的人群规律,这背后蕴含的智慧和方法论是我一直想要深入了解的。这本书就像一个桥梁,连接了我的社会学兴趣和我的数学能力短板,我迫不及待地想看看它能否顺利地跨越这个鸿沟。
我对这本书中可能包含的关于“多层模型”或“层次线性模型”(HLM)的讨论充满了期待。在社会学研究中,我们经常面对数据具有层级结构的情况,例如,学生嵌套在班级中,班级嵌套在学校中。传统的统计方法往往难以有效地处理这种数据结构,而多层模型则提供了一个强大的解决方案。我希望书中能够详细解释多层模型的数学框架,包括如何构建个体层面的方程和群体层面的方程,以及如何同时估计不同层面的效应。我期待书中能够阐述,为什么在处理层级数据时,简单地忽略其层级结构会导致估计偏差和无效的统计推断。我希望书中能够通过具体的社会学研究范例,例如探究学生的学业成绩如何受到个体特征(如学习习惯)和班级特征(如教师质量)的共同影响,来展示多层模型的应用。我尤其希望书中能够解释如何解释和报告多层模型的结果,包括如何解读不同层面的回归系数,以及如何进行模型比较和选择。掌握多层模型,将极大地提升我分析复杂社会现象的能力。
这本书的书名让我联想到社会科学研究中最核心的挑战之一:如何在不确定性中寻找规律。我尤其关注书中关于“概率分布”的讲解,特别是“正态分布”在社会统计学中的重要性。许多社会现象的测量结果,例如身高、智商得分等,常常呈现出近似正态分布的特征。我希望书中能够详细解释正态分布的数学性质,以及为什么它如此普遍。更重要的是,我期待书中能够阐述,当我们处理的样本数据并非严格服从正态分布时,我们应该如何进行统计推断。这涉及到“中心极限定理”的讨论,我希望书中能够清晰地解释这一核心概念,以及它如何支持我们使用基于正态分布的统计方法来分析各种社会数据。此外,我对书中关于“抽样分布”的论述也充满期待。在社会研究中,我们通常只能从一个庞大的总体中抽取一个样本进行研究,而样本统计量(如样本均值)会随着抽样的不同而有所变化。理解抽样分布的性质,能够帮助我们量化这种变异性,从而对总体的参数做出更准确的估计。我希望书中能够通过具体的例子,展示抽样分布如何帮助我们计算置信区间,以及如何进行假设检验,从而增强我们研究结论的可靠性。
我对书中关于“假设检验”的章节尤为期待。社会学研究的最终目标往往是为了回答一些关于社会现象的疑问,而假设检验正是提供了一种系统性的方法来检验我们对这些疑问的猜测。我希望书中能够详细介绍“零假设”和“备择假设”的设定原则,以及如何根据研究问题来构建它们。例如,当我们想探究一项新的社会政策是否会显著提高居民的幸福感时,零假设可能是政策没有影响,而备择假设则是政策提高了幸福感。我期待书中能够深入讲解“p值”的含义,以及如何根据p值来做出决策——拒绝还是不拒绝零假设。这背后涉及到的统计学原理,例如“第一类错误”和“第二类错误”,是我一直想要弄清楚的。我希望书中能够解释这两种错误之间的权衡关系,以及如何通过调整显著性水平来控制这些错误发生的概率。此外,我也对“t检验”、“卡方检验”等具体的统计检验方法感兴趣。我希望书中不仅会讲解这些检验的适用条件和计算步骤,更会阐述它们在社会学研究中的具体应用场景。例如,t检验可以用来比较两个群体的均值是否存在显著差异,而卡方检验则可以用来分析分类变量之间的关联性。
除少量疑似翻译的小错误外,数学基础部分内容适当。相比于微积分和矩阵理论,统计方面的知识要多一些。好书推荐。
除少量疑似翻译的小错误外,数学基础部分内容适当。相比于微积分和矩阵理论,统计方面的知识要多一些。好书推荐。
除少量疑似翻译的小错误外,数学基础部分内容适当。相比于微积分和矩阵理论,统计方面的知识要多一些。好书推荐。
除少量疑似翻译的小错误外,数学基础部分内容适当。相比于微积分和矩阵理论,统计方面的知识要多一些。好书推荐。
除少量疑似翻译的小错误外,数学基础部分内容适当。相比于微积分和矩阵理论,统计方面的知识要多一些。好书推荐。