

具体描述
作者简介
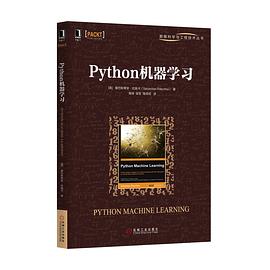
Sebastian Raschka是密歇根州立大学的博士生,他在计算生物学领域提出了几种新的计算方法,还被科技博客Analytics Vidhya评为GitHub上具影响力的数据科学家。他有一整年都使用Python进行编程的经验,同时还多次参加数据科学应用与机器学习领域的研讨会。正是因为Sebastian 在数据科学、机器学习以及Python等领域拥有丰富的演讲和写作经验,他才有动力完成此书的撰写,目的是帮助那些不具备机器学习背景的人设计出由数据驱动的解决方案。
他还积极参与到开源项目中,由他开发完成的计算方法已经被成功应用到了机器学习竞赛(如Kaggle等)中。在业余时间,他沉醉于构建体育运动的预测模型,要么待在电脑前,要么在运动。
目录信息
推荐序
作者简介
审校者简介
前言
第1章 赋予计算机学习数据的能力1
1.1构建智能机器将数据转化为知识1
1.2 机器学习的三种不同方法1
1.2.1 通过监督学习对未来事件进行预测2
1.2.2 通过强化学习解决交互式问题4
1.2.3 通过无监督学习发现数据本身潜在的结构4
1.2.4 基本术语及符号介绍5
1.3 构建机器学习系统的蓝图6
1.3.1 数据预处理6
1.3.2 选择预测模型类型并进行训练7
1.3.3 模型验证与使用未知数据进行预测8
1.4 Python在机器学习中的应用8
本章小结9
第2章 机器学习分类算法10
2.1 人造神经元—早期机器学习概览10
2.2 使用Python实现感知器学习算法13
2.3 自适应线性神经元及其学习的收敛性19
2.3.1 通过梯度下降最小化代价函数20
2.3.2 使用Python实现自适应线性神经元21
2.3.3 大规模机器学习与随机梯度下降25
本章小结29
第3章 使用scikit-learn实现机器学习分类算法30
3.1 分类算法的选择30
3.2 初涉scikit-learn的使用30
使用scikit-learn训练感知器31
3.3 逻辑斯谛回归中的类别概率34
3.3.1 初识逻辑斯谛回归与条件概率34
3.3.2 通过逻辑斯谛回归模型的代价函数获得权重36
3.3.3 使用scikit-learn训练逻辑斯谛回归模型37
3.3.4 通过正则化解决过拟合问题39
3.4 使用支持向量机最大化分类间隔41
3.4.1 对分类间隔最大化的直观认识41
3.4.2 使用松弛变量解决非线性可分问题42
3.4.3 使用scikit-learn实现SVM44
3.5 使用核SVM解决非线性问题44
3.6 决策树48
3.6.1 最大化信息增益—获知尽可能准确的结果49
3.6.2 构建决策树52
3.6.3 通过随机森林将弱分类器集成为强分类器53
3.7 惰性学习算法—k-近邻算法54
本章小结57
第4章 数据预处理—构建好的训练数据集58
4.1 缺失数据的处理58
4.1.1 将存在缺失值的特征或样本删除59
4.1.2 缺失数据填充60
4.1.3 理解scikit-learn预估器的API60
4.2 处理类别数据61
4.2.1 有序特征的映射61
4.2.2 类标的编码62
4.2.3 标称特征上的独热编码63
4.3 将数据集划分为训练数据集和测试数据集64
4.4 将特征的值缩放到相同的区间65
4.5 选择有意义的特征66
4.5.1 使用L1正则化满足数据稀疏化67
4.5.2 序列特征选择算法70
4.6 通过随机森林判定特征的重要性74
本章小结76
第5章 通过降维压缩数据77
5.1 无监督数据降维技术—主成分分析77
5.1.1 总体方差与贡献方差78
5.1.2 特征转换80
5.1.3 使用scikit-learn进行主成分分析82
5.2 通过线性判别分析压缩无监督数据84
5.2.1 计算散布矩阵85
5.2.2 在新特征子空间上选取线性判别算法87
5.2.3 将样本映射到新的特征空间89
5.2.4 使用scikit-learn进行LDA分析90
5.3 使用核主成分分析进行非线性映射91
5.3.1 核函数与核技巧91
5.3.2 使用Python实现核主成分分析94
5.3.3 映射新的数据点99
5.3.4 scikit-learn中的核主成分分析102
本章小结103
第6章 模型评估与参数调优实战104
6.1 基于流水线的工作流104
6.1.1 加载威斯康星乳腺癌数据集104
6.1.2 在流水线中集成数据转换及评估操作105
6.2 使用k折交叉验证评估模型性能106
6.2.1 holdout方法106
6.2.2 k折交叉验证107
6.3 通过学习及验证曲线来调试算法110
6.3.1 使用学习曲线判定偏差和方差问题110
6.3.2 通过验证曲线来判定过拟合与欠拟合112
6.4 使用网格搜索调优机器学习模型113
6.4.1 使用网络搜索调优超参114
6.4.2 通过嵌套交叉验证选择算法115
6.5 了解不同的性能评价指标116
6.5.1 读取混淆矩阵116
6.5.2 优化分类模型的准确率和召回率117
6.5.3 绘制ROC曲线118
6.5.4 多类别分类的评价标准121
本章小结121
第7章 集成学习—组合不同的模型122
7.1 集成学习122
7.2 实现一个简单的多数投票分类器125
7.3 评估与调优集成分类器131
7.4 bagging —通过bootstrap样本构建集成分类器135
7.5 通过自适应boosting提高弱学习机的性能138
本章小结143
第8章 使用机器学习进行情感分析144
8.1 获取IMDb电影评论数据集144
8.2 词袋模型简介146
8.2.1 将单词转换为特征向量146
8.2.2 通过词频-逆文档频率计算单词关联度147
8.2.3 清洗文本数据148
8.2.4 标记文档149
8.3 训练用于文档分类的逻辑斯谛回归模型151
8.4 使用大数据—在线算法与外存学习152
本章小结155
第9章 在Web应用中嵌入机器学习模型156
9.1 序列化通过scikit-learn拟合的模型156
9.2 使用SQLite数据库存储数据158
9.3 使用Flask开发Web应用160
9.3.1 第一个Flask Web应用160
9.3.2 表单验证及渲染161
9.4 将电影分类器嵌入Web应用164
9.5 在公共服务器上部署Web应用169
本章小结172
第10章 使用回归分析预测连续型目标变量173
10.1 简单线性回归模型初探173
10.2 波士顿房屋数据集174
10.3 基于最小二乘法构建线性回归模型178
10.3.1 通过梯度下降计算回归参数178
10.3.2 使用scikit-learn估计回归模型的系数181
10.4 使用RANSAC拟合高鲁棒性回归模型182
10.5 线性回归模型性能的评估184
10.6 回归中的正则化方法185
10.7 线性回归模型的曲线化-多项式回归186
10.7.1 房屋数据集中的非线性关系建模188
10.7.2 使用随机森林处理非线性关系190
本章小结193
第11章 聚类分析——处理无类标数据194
11.1 使用k-means算法对相似对象进行分组194
11.1.1 k-means++196
11.1.2 硬聚类与软聚类198
11.1.3 使用肘方法确定簇的最佳数量199
11.1.4 通过轮廓图定量分析聚类质量200
11.2 层次聚类203
11.2.1 基于距离矩阵进行层次聚类204
11.2.2 树状图与热度图的关联207
11.2.3 通过scikit-learn进行凝聚聚类208
11.3 使用DBSCAN划分高密度区域209
本章小结212
第12章 使用人工神经网络识别图像213
12.1 使用人工神经网络对复杂函数建模213
12.1.1 单层神经网络回顾214
12.1.2 多层神经网络架构简介215
12.1.3 通过正向传播构造神经网络216
12.2 手写数字的识别218
12.2.1 获取MNIST数据集218
12.2.2 实现一个多层感知器222
12.3 人工神经网络的训练228
12.3.1 计算逻辑斯谛代价函数228
12.3.2 通过反向传播训练神经网络230
12.4 建立对反向传播的直观认识231
12.5 通过梯度检验调试神经网络232
12.6 神经网络的收敛性236
12.7 其他神经网络架构237
12.7.1 卷积神经网络237
12.7.2 循环神经网络238
12.8 关于神经网络的实现239
本章小结240
第13章 使用Theano并行训练神经网络241
13.1 使用Theano构建、编译并运行表达式241
13.1.1 什么是Theano242
13.1.2 初探Theano243
13.1.3 配置Theano244
13.1.4 使用数组结构245
13.1.5 整理思路—线性回归示例247
13.2 为前馈神经网络选择激励函数250
13.2.1 逻辑斯谛函数概述250
13.2.2 通过softmax函数评估多类别分类任务中的类别概率252
13.2.3 通过双曲正切函数增大输出范围252
13.3 使用Keras提高训练神经网络的效率254
本章小结258
· · · · · · (收起)
读后感
中文翻译(非官方) [https://www.gitbook.com/book/ljalphabeta/python-/details] ==========================================================================================================================================================
评分充其量不过是几个常用python ML包(scikit NumPy SciPy matplotlib pandas)的 cookbook 罢了。 基本上每节的流程就是先告诉你一个ML概念大概是怎么回事,真的很大概,不过好处是至少会告诉你为什么要这么做。然后用一段示例代码告诉你这个东西在Python ML包里要调用哪几个接口...
评分充其量不过是几个常用python ML包(scikit NumPy SciPy matplotlib pandas)的 cookbook 罢了。 基本上每节的流程就是先告诉你一个ML概念大概是怎么回事,真的很大概,不过好处是至少会告诉你为什么要这么做。然后用一段示例代码告诉你这个东西在Python ML包里要调用哪几个接口...
评分但是是有前提的: 1. 基础的线性代数知识需要大家温故知新一下; 2. 对于python中的numpy和pandas的一些基本操作需要熟悉; 3. 抽象能力,最好能把代数方程在大脑里映射出一个几何图形(最多三维); 只要有了以上的前提,读这本书还是挺靠谱的。
评分但是是有前提的: 1. 基础的线性代数知识需要大家温故知新一下; 2. 对于python中的numpy和pandas的一些基本操作需要熟悉; 3. 抽象能力,最好能把代数方程在大脑里映射出一个几何图形(最多三维); 只要有了以上的前提,读这本书还是挺靠谱的。
用户评价
从技术深度和广度的平衡性来看,这本书达到了一个难以企及的高度。很多书籍要么只专注于深度——比如只讲深度学习的某一个网络结构,要么只讲广度——罗列了十几种算法却蜻蜓点水。这本书却成功地在两者之间架起了一座稳固的桥梁。它不仅详尽地覆盖了经典的有监督学习、无监督学习,甚至还为强化学习和集成学习设置了专门的章节,这让我对整个机器学习的版图有了宏观的认识。我尤其欣赏作者对Python生态系统的整合能力。他不是只聚焦于`numpy`和`pandas`的基础操作,而是将`scikit-learn`、`TensorFlow/PyTorch`(在更高级的章节中)无缝地嵌入到讲解流程中,确保读者在学习理论的同时,也能同步掌握工业界最主流的工具链。对于一个希望从零基础迈向高级应用的人来说,这本书简直就是一个一站式的“技能认证中心”,省去了我反复在不同资料间切换的麻烦。
评分这本《python机器学习》的书籍,对我而言,简直是打开了一扇全新的世界大门。我一直对机器学习这个领域充满了好奇,但苦于没有一本能真正将理论与实践完美结合的入门书籍。市面上很多教材要么过于理论化,充斥着晦涩难懂的数学公式,读起来让人望而却步;要么就是代码堆砌,缺乏对核心概念的深入剖析,学完之后总感觉“知其然,而不知其所以然”。然而,这本书的出现彻底改变了我的看法。作者在内容编排上极具匠心,从最基础的线性回归讲起,循序渐进地引入更复杂的算法,每一步的逻辑推导都清晰可见,仿佛有一位经验丰富的导师在旁边耐心指导。尤其值得称赞的是,书中对每一个算法的底层原理都进行了深入浅出的讲解,而不是简单地调用库函数了事。例如,在讲解支持向量机(SVM)时,作者不仅展示了如何用`scikit-learn`实现,更详细地剖析了核函数的选择和拉格朗日乘数法的几何意义,这对于我这种既想用起来又想弄明白的人来说,简直是太重要了。读完第一部分,我信心大增,感觉自己终于抓住了机器学习的“魂”。
评分我对这本书的实践性要求非常高,因为我希望学到的知识能够立即应用到我目前的工作项目中去。坦白说,很多号称实战的书籍,给出的案例往往是那种“玩具级别”的数据集,脱离实际应用场景,读完后根本不知道如何处理真实世界中那些脏乱差的数据。这本书在这方面做得非常出色。它选择的案例贴近行业前沿,涵盖了推荐系统、自然语言处理(NLP)的初步应用以及时间序列预测等多个维度。最让我感到惊喜的是,作者在代码实现上非常严谨,不仅提供了清晰的Python代码,还对数据预处理的每一个步骤进行了详尽的注释和解释。例如,在处理缺失值和异常值时,书中详细对比了插值法和删除法的适用场景,并给出了在特定数据集上进行A/B测试的思路。这种“教你如何思考”而非“直接给你答案”的教学方式,极大地提升了我解决实际问题的能力。我现在已经敢于着手处理我们部门内部的客户行为分析任务了,这多亏了这本书提供的坚实框架和工具箱。
评分这本书的排版和设计细节也体现了作者的用心良苦。在数字化阅读盛行的今天,纸质书的阅读体验变得愈发重要。这本书的字体选择和行距设置非常舒适,长时间阅读也不会感到眼睛疲劳。更重要的是,书中关键公式和算法步骤被高亮或用特殊边框标注出来,使得复习和查找特定知识点时效率极高。我经常在工作遇到问题时,快速翻阅到对应的章节,那些清晰的图示和简洁的伪代码能立刻帮我找回思路。此外,书中附带的学习资源链接(如果我记得没错的话,作者在最后提到了一个GitHub仓库)也十分丰富,里面包含了所有示例代码的完整运行版本以及一些进阶阅读材料。总而言之,这是一本在内容深度、实践指导、阅读体验上都做到了极致的杰作。它不仅仅是一本工具书,更像是我的一个长期学习伙伴,一本值得反复研读的宝典。
评分这本书的叙事风格非常独特,它不像一本标准的教科书那样刻板僵硬,反而带有一种近乎于“技术小说”的阅读体验。作者似乎非常懂得如何拿捏读者的注意力。每当章节即将进入高潮或者理论难度有所提升时,总会巧妙地穿插一些历史典故或者当前工业界的最新动态来缓解阅读疲劳。我特别喜欢它在讨论模型评估和选择时所采用的视角。它没有简单地告诉我们准确率(Accuracy)是黄金标准,而是深入探讨了在不同业务目标下,召回率(Recall)、精确率(Precision)以及F1分数各自的意义和取舍。这种哲学层面的讨论,让我开始以更成熟的眼光看待模型的结果,而不仅仅是盯着一个数字看。我甚至开始反思,我们过去依赖的某个评估指标可能存在根本性的偏差。阅读过程中,我常常会停下来,合上书本,思考半天,这种深度的思考过程,是其他任何我读过的技术书籍都无法给予的体验,它真正做到了“启迪心智”。
评分比较适合入门的工具书,可以时不时拿出来翻翻
评分学了一下,就是有点薄,希望再多一点就好了
评分偏工程,要求它讲明白数学原理可能所求过高。本质还是一场大型的求导。
评分中规中矩而已
评分翻译的不好。错误的地方很多,给译者发邮件也不回 又看了一遍,还是给两星吧
相关图书





本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈图书下载中心 版权所有