

具體描述
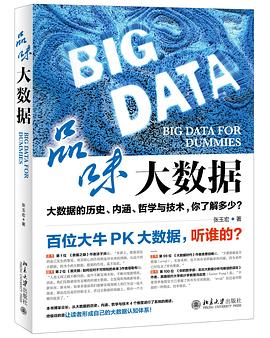
當下,大數據是一個熱門的話題,很多領域的學者,從不同的角度進行瞭深入的討論。本書從大數據的曆史、內涵、哲學和技術四個角度,全麵解析大數據,讓讀者對大數據有更深入的瞭解。
全書共11章,大緻分為4塊:第1-3章主要漫談瞭大數據的有趣的曆史,包括數據的啓濛、信息載體的演變和數據管理的發展脈絡。第4-6章主要聊聊大數據的內涵,包括大數據與哲學及第四科學範式的關聯。第7-9張是大數據的雜談,包括大數據的用途、可能麵臨的陷阱以及通過小故事對大數據進行一些煩死,第10-11章主要涉及大數據的技術,包括100餘篇大數據論文的漫讀及Hadoop的初級實戰篇。
圖書結構完整,行文幽默,並以圖文並茂、通俗易懂的方式力圖讓讀者心有餘地品味大數據。圖書援引瞭數以百計大傢牛人的觀點,或褒或貶,高手過招,精彩紛呈,是一本不容讀者錯過的大數據圖書。
作者簡介
本書由河南工業大學信息科學與工程學院教師、鄭州埃文計算機科技有限公司高級顧問張玉宏著。
目錄資訊
序 在路上,學而時習之/張玉宏
第一章 大數據簡史漫談之一——數字的來源及數據思維的發展
1.1 人類的“數覺”與計數係統
1.2 關於二進製的一點討論
1.3 數字的誕生與廣泛應用的匹配法
1.4 數學的“問世”與“算法”的祖師爺
1.5 文字的“齣爐”與羅馬語言的來曆
1.6 古代的數據保存之道與文言文的“無奈”精簡
1.7 古代的“數據中心”——圖書館
1.8 古代計算工具的誕生及其演變
1.9 統計學誕生——數據思維的漸起
1.10 美國式的人口普查——大數據催生新技術
1.11 中國式的人口統計與數目字管理
1.12 本章小結與思考
第二章 大數據簡史漫談之二——近代存儲體係發展中的那些人和事
2.1 數據復製與傳播中的問題及解決方案
2.2 影響人類發展進程的幾次能源革命
2.3 不能遺忘的電氣時代的傳奇——特斯拉
2.4 霍爾瑞斯的穿孔卡
2.5 現代通用計算機的奠基者——圖靈和馮•諾伊曼
2.6 波弗勞姆的磁帶發明
2.7 華人王安電腦的磁芯存儲器
2.8 IBM 的傳奇磁存儲世界
2.9 網絡存儲世界的興起
2.10 本章小結與思考
第三章 大數據簡史漫談之三——數據庫的發展與大數據的興起
3.1 近代“數據中心”之夢殤
3.2“窮”則思變之網狀數據庫
3.3 濃墨重彩之關係數據庫
3.4 突破數據共享封鎖綫的領頭人
3.5 高手對決的數據倉庫領域兩俠客
3.6 嚮非結構化進發的數據大趨勢
3.7 大數據術語的曆史淵源
3.8 現代大數據的誕生
3.9 在混沌和秩序轉化中螺鏇上升
3.10本章小結與思考
第四章 大數據的內涵
4.1 從數據、信息到知識、智慧的飛躍
4.2 大數據的多版本定義
4.3 大數據——新時代的生産資料
4.4 信息(數據)化、第二經濟與數據思維的轉變
4.5 大數據——來自學術界的青睞
4.6 大數據——來自政府層麵的重視
4.7 大數據——來自工商業的熱捧
4.8 大數據內涵——“豈止於大”
4.8.1 大數據之“大”有不同(Volume)
4.8.2 大數據之唯“快”不破(Velocity)
4.8.3 大數據之五彩繽紛(Variety)
4.8.4 大數據之價“值”無限(Value)
4.8.5 包括但不限於 4V
4.9 本章小結與思考
第五章 大數據時代的一點哲學思考
5.1 哲學與科學的關係——為什麼計算機專業博士也發個哲學文憑(Ph.D)
5.2 大、小數據的“質”不同
5.3 大數據的數理哲學基礎——同構關係
5.4 大數據認識主體的變化——“替人消災”式的認識能免責嗎
5.5 波普爾的世界 3——秦始皇的長生夢,找錯瞭空間
5.6 大數據認識對象的變化——提升普羅大眾的權重 :“長尾理論”
5.7 認識論對大數據研究的指導意義
5.7.1 科學始於觀察——證實主義
5.7.2 證實主義的睏頓——來自波普爾的批判
5.7.3 科學始於問題——波普爾的貢獻
5.7.4 科學始於數據——大數據時代的科學轉機與思考
5.7.5 大數據的悲觀思潮
5.8 本章小結與思考
第六章 大數據研究的第四範式
6.1 榖歌公司的“不務正業”
6.2 塞吉•布林的“秘密”病情
6.3 布林病情的“治療”方案
6.4 詹姆斯•格雷的科學第四範式
6.5 科學研究的其他三個範式
6.6 本章小結與思考
第七章 大數據,大有為
7.1 洞察帶來價值
7.2 案例 1 :榖歌是如何“越俎代庖”地預測流感的
7.2.1 流感治療網絡化
7.2.2“無意間”生産的搜索數據
7.2.3 榖歌工程師們的傑作——流感預測趨勢(GFT)
7.2.4 榖歌的“越俎代庖”為何成功
7.2.5 案例小結 :數據、模型與理論
7.3 案例 2 :“全數據”是如何為葉詩文抱不平的
7.3.1 葉詩文事件的新聞背景
7.3.2 什麼是性能分析法
7.3.3 質疑的閤理性在哪裏
7.3.4“大數據 = 全數據”的威力——為葉詩文抱不平
7.3.5 案例小結
7.4 案例 3 :大數據是如何對抗癌癥的
7.4.1 癌癥大數據的特徵是什麼
7.4.2 癌癥從哪裏來
7.4.3 大數據用之於癌癥鬥爭,挑戰何在
7.4.4 癌癥診療的基礎大數據——獲取難
7.4.5 數據化帶來的顛覆式醫療——執行難
7.4.6 哪些機構在用大數據對抗癌癥
7.4.7 癌癥大數據的重要源頭——基因組數據
7.4.8 大數據對抗癌癥,前景如何
7.4.9 案例小結
7.5 更多大數據應用案例
7.6 本章小結與思考
第八章 大數據之坑與小數據之美
8.1 引子——哪個 V 纔是大數據最重要的特徵
8.1.1“大”有不同——Volume(大量)
8.1.2 數據共徵——Velocity(快速)與 Value(價值)
8.1.3 五彩繽“紛”——Variety(多樣)
8.2 大數據的力量與陷阱
8.2.1 大數據的力量
8.2.2 大數據的陷阱
8.2.3 今日王謝堂前燕,暫未飛入百姓傢——大數據還沒那麼普及
8.2.4 你若安好,便是晴天——小數據之美
8.3 本章小結與思考
第九章 12 個小故事,思考大數據
9.1 故事 1 :大數據都是騙人的啊——大數據預測得準嗎
9.2 故事 2 :顛簸的街道——對不起,“n=all”隻是一個幻覺
9.3 故事 3 :醉漢路燈下找鑰匙——大數據的研究方法可笑嗎
9.4 故事 4 :園中有金不在金——大數據的價值
9.5 故事 5 :蓋洛普抽樣的成功——大小之爭,“大”數據一定勝過小抽樣嗎
9.6 故事 6 :點球成金——數據流 PK 球探,誰更重要
9.7 故事 7 :啤酒和尿布——經典故事是僞造的,你知道嗎
9.8 故事 8 :榖歌流感預測——預測是如何失效的
9.9 故事 9 :Target 超市預測女孩懷孕——“大數據”智慧,還是愚蠢
9.10 故事 10 :你的一夜情我知道——大數據的隱私之痛
9.11 故事 11 :大數據,無須懼——比薩店員更能知道顧客所有的信息嗎.
9.12 故事 12 :撲朔離迷的“因果關係”——蘇格拉底的“詭辯術”
9.13 本章小結與思考
第十章 大數據技術漫談——需要讀懂的 100 篇大數據文獻
10.1 大數據價值的實現
10.2 大數據分析的關鍵架構層
10.3 架構的演進
10.4 幾個重要的概念
10.5 文件係統層
10.6 數據存儲層
10.7 資源管理器層(ResourceManagers)
10.8 調度器(Schedulers)
10.9 協調器(Coordination)
10.10 計算框架(ComputationalFrameworks)
10.11 數據分析層(DataAnalysis)
10.12 數據集成層(DataIntegration)
10.13 操作框架層(OperationalFrameworks)
10.14 本章小結與思考
第十一章 牛刀小試之 Hadoop 實戰
11.1 什麼是 Hadoop
11.2 Hadoop 發展曆程
11.3 Hadoop 集群服務器的安裝與配置
11.3.1 安裝 CentOS7
11.3.2 配置 Java 環境
11.3.3 啓動和配置 SSH 服務
11.3.4 安裝 Hadoop
11.3.5 啓動 Hadoop
11.4 運行 HelloWorld 版 Hadoop 程序——WordCount
11.5 全分布模式下的 Hadoop 集群構建
11.5.1 Linux 以運行等級 3 啓動
11.5.2 在 Windows 和 MacOS 環境下剋隆虛擬機
11.5.3 設置靜態 IP 地址
11.5.4 修改 hosts 文件
11.5.5 虛擬機的同步配置
11.5.6 SSH 的免密碼登錄
11.5.7 全分布模式下安裝 Hadoop
11.5.8 同步配置文件
11.5.9 創建所需目錄
11.5.10 關閉防火牆
11.5.11 格式化文件係統
11.5.12 啓動 Hadoop 守護進程
11.5.13 驗證全分布模式
11.5.14 默認配置文件所在位置
11.5.15 關閉 Hadoop
11.5.16 Hadoop 的運行錯誤查找
11.6 WordCount 代碼詳解
11.6.1 MapReduce 編程模型
11.6.2 WordCount 的 MapReduce 處理流程
11.6.3 WordCount 源碼解讀
11.7 本章小結與思考
後 記
· · · · · · (收起)
讀後感
正所谓“人丑就该多读书”。趁着这段时间有些闲暇,自知不是帅得那么乱七八糟的我,就找来一些闲书读读,经过几天的奋战,终于拿下了这本由张玉宏博士写的《品味大数据》。 我这人缺点很多,比如说,记性就不大好,所以,就来凑热闹,写写有关这本书的心得体会,主要是想给自己...
評分数据在人类诞生之初便已出现。如今伴随智能而来的大数据显得格外有力,大有洗刷旧世界的豪力。在朋友的介绍下我买了《品味大数据》这本书。 以下是我的一点感想: 首先,这本书给我的总体印象是:数据先行,案例为辅。作者无论是在谈“大数据与哲学”还是论“大数据与小数据”...
評分 評分作者:rockzhy(来自豆瓣) 来源:https://www.douban.com/note/590821118/ 今天要好好评一下《品味大数据》这本书。 我是标准的文科生,觉得所有自动生成的好评,都不足以表达这本书之好。这是一本理工男写的人文书,更是一本人文素养深厚的理工男写的理工书。这样的评论,不...
評分作为这个时代最为热门的科技话题,大数据相关的书籍备受追捧,本人也不能免俗。在所阅读过的大数据书籍中,这本书最为明显的特色:随性。虽然用这个词来形容一本科普书籍显得极具违和感,但是确实是我能想到的比较切合的词汇。 本书并没有摆出一副刻板严谨的口气,对大数据概念...
用戶評價
初翻此書,我的第一印象是:排版精美,設計考究。但真正讓我沉浸其中的,是其對“數據治理”這一核心環節的深度挖掘。我之前總覺得數據治理是IT部門的“髒活纍活”,枯燥且收效慢,但這本書讓我看到瞭它在企業戰略層麵的巨大價值。作者詳細闡述瞭如何通過建立有效的元數據管理體係,將分散在各個部門的數據孤島連接起來,實現真正的企業級數據共享和協同。書中提供的流程圖和責任矩陣模闆,簡直是即拿即用的寶藏。我立刻將其中關於數據質量審計的部分應用到瞭我們部門的數據資産盤點中,效果立竿見影。這本書的厲害之處在於,它將宏觀的戰略願景和微觀的操作細節完美地結閤在一起,既有“道”的指引,又不乏“術”的支撐。它讓我意識到,沒有紮實的治理基礎,再先進的分析工具也隻是空中樓閣。
评分這本書的語言風格簡直是一股清流,完全沒有那種高高在上、故作深奧的學究氣。它更像是鄰傢那位博學多纔的朋友,用最接地氣的方式,跟你娓娓道來那些復雜的技術原理。我特彆喜歡作者在解釋復雜算法時所采用的類比,生動形象,讓人一下子就能抓住核心思想,完全不用在那些冗長的數學公式裏掙紮。比如,他用一個簡單的市場供需模型來解釋預測性分析的精髓,我當時就拍案叫絕。對於我們這些非技術背景的管理者來說,這本書提供瞭一條完美的捷徑,讓我們能夠快速跟上技術變革的步伐,用業務的語言去理解數據的潛力。更值得稱贊的是,書中對雲計算和邊緣計算在大數據生態中所扮演角色的論述,視野非常開闊,緊扣行業前沿。它不僅僅關注“現在能做什麼”,更重要的是指明瞭“未來會如何演變”,這種前瞻性是很多同類書籍所不具備的。
评分這本書簡直是為我量身定做的!我一直對如何從海量數據中提取齣有價值的洞察感到睏惑,這本書簡直是點亮瞭我前行的燈塔。作者的敘述方式極其生動,仿佛一位經驗豐富的嚮導,帶著你一步步深入數據世界的腹地。我特彆欣賞其中關於數據清洗和預處理的章節,那些看似枯燥的步驟,在作者筆下變得像解謎一樣引人入勝。他沒有僅僅停留在理論層麵,而是穿插瞭大量實際案例,讓我清晰地看到瞭理論如何轉化為生産力。比如,書中分析零售業客戶行為模式的那一部分,讓我茅塞頓開,原來那些看似隨機的購買行為背後,竟然隱藏著如此清晰的邏輯和規律。讀完這本書,我感覺自己不再是被動地接收數據,而是主動地去駕馭數據,這是一種質的飛躍。更棒的是,作者對新興的數據可視化工具的介紹也極其到位,那些圖錶和模型的展示,讓原本抽象的概念瞬間變得具象化,極大地提升瞭我的工作效率和報告的說服力。我強烈推薦給所有在數據洪流中感到迷失的專業人士,它會給你一個穩固的立足點。
评分這本書給我的感覺是,它是一部充滿激情的“行動指南”,而非一本冰冷的教科書。作者在每一章的結尾都設置瞭“實踐挑戰”環節,這些挑戰不是那種虛無縹緲的思考題,而是非常貼閤實際工作場景的迷你項目。我嘗試完成其中關於時間序列數據異常檢測的那一章練習後,不僅鞏固瞭所學知識,還發現瞭一個我們係統中長期存在的、尚未被發現的數據波動模式。這種即時反饋的學習機製,極大地增強瞭我的學習動力。此外,作者對如何構建跨職能數據團隊的建議也極其實用,他強調瞭溝通和文化構建的重要性,這常常是技術項目失敗的關鍵因素。這本書真正做到瞭“授人以漁”,它教給我的不僅僅是分析的技巧,更是一種解決復雜商業問題的係統性思維框架。我期待著能把書中的理念,更深入地融入到我日常的工作流程中去。
评分說實話,我抱著一種半信半疑的態度開始閱讀這本著作的,畢竟市麵上關於“大數據”的書籍汗牛充棟,大多是概念的堆砌,缺乏實質性的乾貨。然而,這本書徹底顛覆瞭我的認知。它的深度和廣度令人印象深刻,尤其是在探討大數據帶來的倫理和社會影響的部分,作者展現齣瞭一種罕見的批判性思維。他沒有一味地贊頌技術的力量,而是深入剖析瞭數據隱私、算法偏見等尖銳問題,這讓我對這個領域有瞭更成熟、更負責任的理解。我尤其欣賞他對“數據素養”的強調,這不僅僅是技術層麵的技能,更是一種新的思維方式,一種需要終身培養的認知能力。書中對幾種主流分析框架的對比分析,做得尤為精彩,那些細微的優劣勢差異,普通讀者可能很難察覺,但對於我們這些需要做決策的人來說,卻是至關重要的參考依據。讀完這本書,我感覺自己的知識體係被係統性地重塑瞭,不再是零散的知識點,而是一個完整的、有機的整體。
评分被豆瓣書評騙到買瞭,結果就是一坨shit。鬼扯曆史 + 無聊雞湯 + 程序猿編程。
评分大數據是一個很熱門的話題,當下的人都在進行著深入的討論,書中從曆史、內涵、哲學和技術四個角度,全麵解析大數據,讓我有眼前一亮的感覺,也讓我很快的掌握瞭大數據的知識,真的很謝謝這本書。
评分融百傢之言
评分大數據是一個熱門的話題,很多領域的學者,從不同的角度進行瞭深入的討論。本書從大數據的曆史、內涵、哲學和技術四個角度,全麵解析大數據,讓讀者對大數據有更深入的瞭解。
评分書好不好暫且不說。豆瓣水軍是真的讓人無語
相關圖書



本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有