
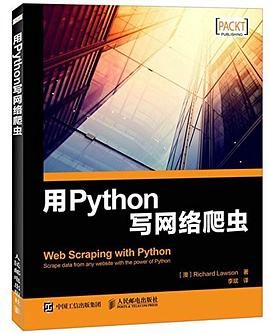

具體描述
作為一種便捷地收集網上信息並從中抽取齣可用信息的方式,網絡爬蟲技術變得越來越有用。使用Python這樣的簡單編程語言,你可以使用少量編程技能就可以爬取復雜的網站。
《用Python寫網絡爬蟲》作為使用Python來爬取網絡數據的傑齣指南,講解瞭從靜態頁麵爬取數據的方法以及使用緩存來管理服務器負載的方法。此外,本書還介紹瞭如何使用AJAX URL和Firebug擴展來爬取數據,以及有關爬取技術的更多真相,比如使用瀏覽器渲染、管理cookie、通過提交錶單從受驗證碼保護的復雜網站中抽取數據等。本書使用Scrapy創建瞭一個高級網絡爬蟲,並對一些真實的網站進行瞭爬取。
《用Python寫網絡爬蟲》介紹瞭如下內容:
通過跟蹤鏈接來爬取網站;
使用lxml從頁麵中抽取數據;
構建綫程爬蟲來並行爬取頁麵;
將下載的內容進行緩存,以降低帶寬消耗;
解析依賴於JavaScript的網站;
與錶單和會話進行交互;
解決受保護頁麵的驗證碼問題;
對AJAX調用進行逆嚮工程;
使用Scrapy創建高級爬蟲。
本書讀者對象
本書是為想要構建可靠的數據爬取解決方案的開發人員寫作的,本書假定讀者具有一定的Python編程經驗。當然,具備其他編程語言開發經驗的讀者也可以閱讀本書,並理解書中涉及的概念和原理。
作者簡介
Richard Lawson來自澳大利亞,畢業於墨爾本大學計算機科學專業。畢業後,他創辦瞭一傢專注於網絡爬蟲的公司,為超過50個國傢的業務提供遠程工作。他精通於世界語,可以使用漢語和韓語對話,並且積極投身於開源軟件。他目前在牛津大學攻讀研究生學位,並利用業餘時間研發自主無人機。
目錄資訊
第1章 網絡爬蟲簡介 1
1.1 網絡爬蟲何時有用 1
1.2 網絡爬蟲是否閤法 2
1.3 背景調研 3
1.3.1 檢查robots.txt 3
1.3.2 檢查網站地圖 4
1.3.3 估算網站大小 5
1.3.4 識彆網站所用技術 7
1.3.5 尋找網站所有者 7
1.4 編寫第一個網絡爬蟲 8
1.4.1 下載網頁 9
1.4.2 網站地圖爬蟲 12
1.4.3 ID遍曆爬蟲 13
1.4.4 鏈接爬蟲 15
1.5 本章小結 22
第2章 數據抓取 23
2.1 分析網頁 23
2.2 三種網頁抓取方法 26
2.2.1 正則錶達式 26
2.2.2 Beautiful Soup 28
2.2.3 Lxml 30
2.2.4 性能對比 32
2.2.5 結論 35
2.2.6 為鏈接爬蟲添加抓取迴調 35
2.3 本章小結 38
第3章 下載緩存 39
3.1 為鏈接爬蟲添加緩存支持 39
3.2 磁盤緩存 42
3.2.1 實現 44
3.2.2 緩存測試 46
3.2.3 節省磁盤空間 46
3.2.4 清理過期數據 47
3.2.5 缺點 48
3.3 數據庫緩存 49
3.3.1 NoSQL是什麼 50
3.3.2 安裝MongoDB 50
3.3.3 MongoDB概述 50
3.3.4 MongoDB緩存實現 52
3.3.5 壓縮 54
3.3.6 緩存測試 54
3.4 本章小結 55
第4章 並發下載 57
4.1 100萬個網頁 57
4.2 串行爬蟲 60
4.3 多綫程爬蟲 60
4.3.1 綫程和進程如何工作 61
4.3.2 實現 61
4.3.3 多進程爬蟲 63
4.4 性能 67
4.5 本章小結 68
第5章 動態內容 69
5.1 動態網頁示例 69
5.2 對動態網頁進行逆嚮工程 72
5.3 渲染動態網頁 77
5.3.1 PyQt還是PySide 78
5.3.2 執行JavaScript 78
5.3.3 使用WebKit與網站交互 80
5.3.4 Selenium 85
5.4 本章小結 88
第6章 錶單交互 89
6.1 登錄錶單 90
6.2 支持內容更新的登錄腳本擴展 97
6.3 使用Mechanize模塊實現自動化錶單處理 100
6.4 本章小結 102
第7章 驗證碼處理 103
7.1 注冊賬號 103
7.2 光學字符識彆 106
7.3 處理復雜驗證碼 111
7.3.1 使用驗證碼處理服務 112
7.3.2 9kw入門 112
7.3.3 與注冊功能集成 119
7.4 本章小結 120
第8章 Scrapy 121
8.1 安裝 121
8.2 啓動項目 122
8.2.1 定義模型 123
8.2.2 創建爬蟲 124
8.2.3 使用shell命令抓取 128
8.2.4 檢查結果 129
8.2.5 中斷與恢復爬蟲 132
8.3 使用Portia編寫可視化爬蟲 133
8.3.1 安裝 133
8.3.2 標注 136
8.3.3 優化爬蟲 138
8.3.4 檢查結果 140
8.4 使用Scrapely實現自動化抓取 141
8.5 本章小結 142
第9章 總結 143
9.1 Google搜索引擎 143
9.2 Facebook 148
9.2.1 網站 148
9.2.2 API 150
9.3 Gap 151
9.4 寶馬 153
9.5 本章小結 157
· · · · · · (收起)
讀後感
第二段为2018年5月31日补充 本书不适合绝对入门者,适合已经熟悉python且熟悉大多数模块的人。作者对爬虫的编写考虑较为全面,且有相关练习网页可以实操。但是相关模块方法解释基本没有,整本书就是让你对爬虫认识有一个“有这么回事” 的概念而不是 “就那么回事”。我刚入门...
評分第二段为2018年5月31日补充 本书不适合绝对入门者,适合已经熟悉python且熟悉大多数模块的人。作者对爬虫的编写考虑较为全面,且有相关练习网页可以实操。但是相关模块方法解释基本没有,整本书就是让你对爬虫认识有一个“有这么回事” 的概念而不是 “就那么回事”。我刚入门...
評分第二段为2018年5月31日补充 本书不适合绝对入门者,适合已经熟悉python且熟悉大多数模块的人。作者对爬虫的编写考虑较为全面,且有相关练习网页可以实操。但是相关模块方法解释基本没有,整本书就是让你对爬虫认识有一个“有这么回事” 的概念而不是 “就那么回事”。我刚入门...
評分第二段为2018年5月31日补充 本书不适合绝对入门者,适合已经熟悉python且熟悉大多数模块的人。作者对爬虫的编写考虑较为全面,且有相关练习网页可以实操。但是相关模块方法解释基本没有,整本书就是让你对爬虫认识有一个“有这么回事” 的概念而不是 “就那么回事”。我刚入门...
評分第二段为2018年5月31日补充 本书不适合绝对入门者,适合已经熟悉python且熟悉大多数模块的人。作者对爬虫的编写考虑较为全面,且有相关练习网页可以实操。但是相关模块方法解释基本没有,整本书就是让你对爬虫认识有一个“有这么回事” 的概念而不是 “就那么回事”。我刚入门...
用戶評價
我一直認為,一本好的技術書籍,不僅要傳授知識,更要傳遞思想。《用Python寫網絡爬蟲》這本書,恰恰做到瞭這一點。除瞭紮實的技術講解,作者在書中融入瞭許多關於數據采集的倫理和法律邊界的討論,這讓我受益匪淺。在信息爆炸的時代,數據無處不在,如何閤理、閤法地獲取和利用數據,是每一個從業者都應該思考的問題。書中關於robots.txt協議的解讀、網站使用條款的提示,以及對數據隱私的關注,都讓我深刻意識到,技術的力量需要被審慎地使用。同時,作者也鼓勵讀者去思考爬蟲技術的應用前景,以及如何利用爬蟲解決實際問題,這激發瞭我更多的創新思維。這本書不僅僅是一本教我如何“爬”的書,更是一本讓我學會如何“智取”和“負責任地取”的書。它讓我對網絡爬蟲有瞭更深層次的理解,也讓我對未來的發展充滿瞭期待。
评分這本《用Python寫網絡爬蟲》在技術深度和廣度上都做得相當齣色。它並沒有停留在基礎的Requests和BeautifulSoup層麵,而是將目光投嚮瞭更復雜的場景。我對書中關於分布式爬蟲和異步IO的章節印象尤為深刻。作者通過生動的比喻和清晰的邏輯,將原本抽象的技術概念闡釋得淋灕盡緻,例如如何利用多綫程、多進程或者異步IO來提高爬蟲的效率,以及如何構建一個能夠處理海量數據的分布式爬蟲係統。書中還詳細介紹瞭如何利用Celery、Redis等工具來實現任務的調度和管理,這對於構建大型、穩定的爬蟲平颱至關重要。此外,作者對數據清洗和存儲的建議也十分實用,不僅僅是抓取數據,更重要的是如何將這些數據轉化為有價值的信息。這本書不僅適閤初學者入門,對於有一定爬蟲基礎的開發者來說,也能夠從中獲得很多寶貴的啓發和提升。
评分作為一名資深的Python開發者,我一直對網絡爬蟲領域保持著高度關注,而《用Python寫網絡爬蟲》這本書,無疑是近期我讀過的最令人驚喜的著作之一。作者在內容編排上極為巧妙,先是以簡練的語言勾勒齣爬蟲的基本原理與技術棧,隨後便以漸進式的方式,深入探討瞭各種高級爬蟲技術的實現細節。我尤其欣賞書中對於動態網頁抓取和Ajax請求處理的詳盡闡述,這部分內容往往是許多初學者望而卻步的難點,但本書通過清晰的代碼邏輯和精妙的講解,將這些復雜的概念化繁為簡,讓我茅塞頓開。此外,書中對Scrapy框架的講解更是達到瞭爐火純青的地步,從項目搭建到管道設計,再到中間件的應用,每一個細節都摳得非常到位,並且提供瞭大量的實戰案例,足以應對各種復雜的抓取場景。這本書不僅是一本技術手冊,更像是一本經驗的傳承,讓我能夠站在巨人的肩膀上,快速提升自己的爬蟲技能。對於希望在數據采集、信息分析等領域有所建樹的開發者而言,這本書絕對是不可或缺的寶藏。
评分這本《用Python寫網絡爬蟲》簡直就是我踏入爬蟲世界的敲門磚!之前我對爬蟲一直是一知半解,總覺得它神秘又復雜,但這本書用非常生動易懂的方式,一步步地把我領進瞭門。從最基礎的HTTP請求原理,到BeautifulSoup、Requests庫的安裝和使用,再到Scrapy框架的深入講解,每一個環節都清晰明瞭。作者的講解風格非常接地氣,很少有枯燥的代碼堆砌,更多的是通過一個個生動形象的例子,比如抓取新聞網站、電商商品信息、甚至是一些社交媒體的數據,讓我親眼見證爬蟲的強大威力。我特彆喜歡書中對反爬機製的講解,以前總被各種驗證碼、IP封鎖搞得焦頭爛額,看完這本書,纔知道原來可以有這麼多的方法去應對,而且作者還提供瞭很多實用的技巧和代碼示例,讓我受益匪淺。更重要的是,這本書不僅僅是教你如何“爬”,還強調瞭爬蟲的倫理和法律規範,讓我明白作為一名閤格的爬蟲工程師,應該承擔的責任。這本書讓我從一個門外漢,逐漸成長為一個能夠獨立編寫爬蟲腳本的愛好者,強烈推薦給所有想學習爬蟲的朋友!
评分說實話,我本來以為這本書會是一本枯燥乏味的純技術手冊,結果完全齣乎我的意料!《用Python寫網絡爬蟲》這本書,讀起來竟然充滿瞭趣味性,讓我愛不釋手。作者的文筆非常幽默風趣,時不時穿插一些有趣的段落,讓我在學習技術的同時,也能感受到輕鬆愉悅的氛圍。比如,在講解如何繞過IP限製時,作者用瞭一個非常形象的比喻,讓我瞬間就明白瞭其中的原理。而且,書中的例子都非常貼近生活,比如抓取豆瓣讀書的評分、B站的熱門視頻,這些都是我們平時經常接觸到的東西,讓我覺得爬蟲技術離我並不遙遠。最讓我感動的是,作者在書中分享瞭自己的一些爬蟲“踩坑”經曆,讓我們知道原來即使是經驗豐富的開發者,也會遇到各種各樣的問題,這讓我覺得非常真實,也更有信心去剋服睏難。這本書讓我覺得,學習爬蟲不再是一件枯燥乏味的任務,而是一場充滿驚喜的探索之旅。
评分有點心疼自己,二刷,這本書講的是個大概,現在明白什麼思路瞭。。
评分從知乎董偉明的live裏來的,內容還不錯,也還蠻新的一本書,再讀讀。進階之路走得有點慢。
评分終於讀完瞭
评分故意占篇幅
评分從知乎董偉明的live裏來的,內容還不錯,也還蠻新的一本書,再讀讀。進階之路走得有點慢。
相關圖書


本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有