
具体描述
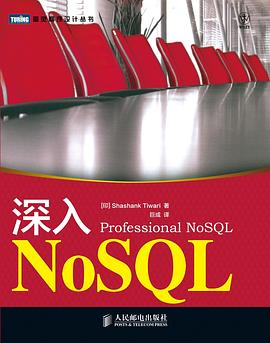
《深入NoSQL》是一本全面的NoSQL实践指南。书中主要关注NoSQL的基本概念,以及使用NoSQL数据库的切实可行的解决方案。书中介绍了基于MapReduce的可伸缩处理,演示Hadoop用例,还有Hive和Pig这样的高层抽象。包含许多用例演示,同时也会讨论Google、Amazon、Facebook、Twitter和LinkedIn的可伸缩数据架构。
作者简介
Shashank Tiwari
创业者、开发者、技术作家、演讲者和导师,技术型创业公司Treasury of Ideas(www.treasuryofideas.com)的创始人。
他是一位经验丰富的软件开发者和企业家,长期关注高性能应用、分析、Web应用以及移动平台,对数据可视化和统计机器学习有着浓厚的兴趣,喜欢喝咖啡、吃甜点、骑自行车。他撰写了许多技术文章和著作,并且应邀在全球各地的技术会议上进行演讲。
目录信息
第一部分 NoSQL入门
第1章 NoSQL的概念及适用范围 2
1.1 定义和介绍 3
1.1.1 背景与历史 3
1.1.2 大数据 5
1.1.3 可扩展性 7
1.1.4 MapReduce 8
1.2 面向列的有序存储 9
1.3 键/值存储 11
1.4 文档数据库 14
1.5 图形数据库 15
1.6 小结 16
第2章 NoSQL上手初体验 17
2.1 第一印象——两个简单的例子 17
2.1.1 简单的位置偏好数据集 17
2.1.2 存储汽车品牌和型号数据 22
2.2 使用多种语言 30
2.2.1 MongoDB驱动 30
2.2.2 初识Thrift 33
2.3 小结 34
第3章 NoSQL接口与交互 36
3.1 没了SQL还剩什么 36
3.1.1 存储和访问数据 37
3.1.2 MongoDB数据存储与访问 37
3.1.3 MongoDB数据查询 41
3.1.4 Redis数据存储与访问 43
3.1.5 Redis数据查询 47
3.1.6 HBase数据存储与访问 50
3.1.7 HBase数据查询 52
3.1.8 Apache Cassandra数据存储与访问 54
3.1.9 Apache Cassandra数据查询 55
3.2 NoSQL数据存储的语言绑定 56
3.2.1 Thrift 56
3.2.2 Java 56
3.2.3 Python 58
3.2.4 Ruby 59
3.2.5 PHP 59
3.3 小结 60
第二部分 NoSQL基础
第4章 理解存储架构 62
4.1 使用面向列的数据库 63
4.1.1 使用关系型数据库中的表格和列 63
4.1.2 列数据库对比RDBMS 65
4.1.3 列数据库当做键/值对的嵌套映射表 67
4.1.4 Webtable布局 70
4.2 HBase分布式存储架构 71
4.3 文档存储内部机制 73
4.3.1 用内存映射文件存储数据 74
4.3.2 MongoDB集合和索引使用指南 75
4.3.3 MongoDB的可靠性和耐久性 75
4.3.4 水平扩展 76
4.4 键/值存储Memcached和Redis 78
4.4.1 Memcached的内部结构 78
4.4.2 Redis的内部结构 79
4.5 最终一致性非关系型数据库 80
4.5.1 一致性哈希 81
4.5.2 对象版本 82
4.5.3 闲话协议和提示移交 83
4.6 小结 83
第5章 执行CRUD操作 84
5.1 创建记录 84
5.1.1 在以文档为中心的数据库中创建记录 85
5.1.2 面向列数据库的创建操作 91
5.1.3 键/值映射表的创建操作 93
5.2 访问数据 96
5.2.1 用MongoDB访问文档 96
5.2.2 用HBase访问数据 97
5.2.3 查询Redis 98
5.3 更新和删除数据 98
5.3.1 使用MongoDB、HBase和Redis更新及修改数据 98
5.3.2 有限原子性和事务完整性 99
5.4 小结 100
第6章 查询NoSQL存储 101
6.1 SQL与MongoDB查询功能的相似点 101
6.1.1 加载MovieLens数据 103
6.1.2 MongoDB中的MapReduce 108
6.2 访问HBase等面向列数据库中的数据 111
6.3 查询Redis数据存储 113
6.4 小结 116
第7章 修改数据存储及管理演进 117
7.1 修改文档数据库 117
7.1.1 弱schema的灵活性 120
7.1.2 MongoDB的数据导入与导出 121
7.2 面向列数据库中数据schema的演进 124
7.3 HBase数据导入与导出 125
7.4 键/值存储中的数据演变 126
7.5 小结 126
第8章 数据索引与排序 127
8.1 数据库索引的基本概念 127
8.2 MongoDB的索引与排序 128
8.3 MongoDB里创建和使用索引 131
8.3.1 组合与嵌套键 136
8.3.2 创建唯一索引和稀疏索引 138
8.3.3 基于关键字的搜索和多重键 139
8.4 CouchDB的索引与排序 140
8.5 Apache Cassandra的索引与排序 141
8.6 小结 143
第9章 事务和数据完整性的管理 144
9.1 RDBMS和ACID 144
9.2 分布式ACID系统 147
9.2.1 一致性 149
9.2.2 可用性 149
9.2.3 分区容忍性 149
9.3 维持CAP 151
9.3.1 妥协可用性 153
9.3.2 妥协分区容忍性 153
9.3.3 妥协一致性 154
9.4 NoSQL产品的一致性实现 155
9.4.1 MongoDB的分布一致性 155
9.4.2 CouchDB的最终一致性 155
9.4.3 Apache Cassandra的最终一致性 156
9.4.4 Membase的一致性 157
9.5 小结 157
第三部分 熟悉NoSQL
第10章 使用云中的NoSQL 160
10.1 Google App Engine 161
10.1.1 GAE Python SDK:安装、设置和起步 161
10.1.2 使用Python进行基本的GAE数据建模 165
10.1.3 查询与索引 168
10.1.4 过滤和结果排序 170
10.1.5 Java App Engine SDK 172
10.2 Amazon SimpleDB 175
10.2.1 SimpleDB入门 176
10.2.2 使用REST API 178
10.2.3 使用Java访问SimpleDB 181
10.2.4 通过Ruby和Python使用SimpleDB 182
10.3 小结 183
第11章 MapReduce可扩展并行处理 185
11.1 理解MapReduce 186
11.1.1 找出每股最高价 188
11.1.2 加载历史NYSE市场数据到CouchDB 189
11.2 MapReduce和HBase 192
11.3 MapReduce和Apache Mahout 196
11.4 小结 197
第12章 使用Hive分析大数据 199
12.1 Hive基础 199
12.2 回到电影评分 203
12.3 亲切的SQL 209
12.4 HiveQL连接 211
12.4.1 计划解释 213
12.4.2 分区表 215
12.5 小结 215
第13章 综览数据库内部 216
13.1 MongoDB内部 217
13.1.1 MongoDB传输协议 218
13.1.2 插入文档 219
13.1.3 查询集合 219
13.1.4 MongoDB数据库文件 220
13.2 Membase架构 222
13.3 Hypertable底层 224
13.3.1 正则表达式支持 224
13.3.2 布隆过滤器 224
13.4 Apache Cassandra 225
13.4.1 点对点模型 225
13.4.2 基于Gossip和Antientropy 225
13.4.3 快速写 226
13.4.4 提示移交 226
13.5 Berkeley DB 226
13.6 小结 228
第四部分 掌握NoSQL
第14章 选择NoSQL 230
14.1 比较NoSQL产品 230
14.1.1 可扩展性 230
14.1.2 事务完整性和一致性 233
14.1.3 数据模型 233
14.1.4 查询支持 235
14.1.5 接口可用性 236
14.2 性能测试 237
14.2.1 50/50的读和更新 237
14.2.2 95/5的读和更新 237
14.2.3 扫描 238
14.2.4 可扩展性测试 238
14.2.5 Hypertable测试 238
14.3 背景比较 239
14.4 小结 240
第15章 共存 241
15.1 MySQL用作NoSQL 241
15.2 静态数据存储 244
15.2.1 存储多元化在Facebook中的应用 245
15.2.2 数据仓库和商业智能 246
15.3 Web框架和NoSQL 247
15.3.1 Rails和NoSQL 247
15.3.2 Django和NoSQL 248
15.3.3 使用Spring Data 250
15.4 从RDBMS迁移到NoSQL 254
15.5 小结 254
第16章 性能调校 256
16.1 并行算法的目标 256
16.1.1 减少延迟的含义 256
16.1.2 如何增加吞吐 257
16.1.3 线性扩展 257
16.2 公式与模型 257
16.2.1 Amdahl法则 257
16.2.2 Little法则 258
16.2.3 消息成本模型 259
16.3 分区 259
16.4 规划异构环境 260
16.5 其他MapReduce调校 261
16.5.1 通信成本 261
16.5.2 压缩 261
16.5.3 文件块大小 261
16.5.4 并行复制 262
16.6 HBase Coprocessor 262
16.7 布隆过滤器 262
16.8 小结 262
第17章 工具和实用程序 263
17.1 RRDTool 263
17.2 Nagios 265
17.3 Scribe 266
17.4 Flume 267
17.5 Chukwa 267
17.6 Pig 268
17.6.1 使用Pig 269
17.6.2 Pig Latin基础 269
17.7 Nodetool 271
17.8 OpenTSDB 272
17.9 SOLANDRA 273
17.10 Hummingbird和C5T 274
17.11 GeoCouch 275
17.12 Alchemy Database 276
17.13 Webdis 276
17.14 小结 276
附录A 安装与配置 278
· · · · · · (收起)
读后感
作者主要关注了三类最常用的 nosql 数据库:文档数据库,列存储数据库,和键值数据库,主要以mongodb,hbase,redis为例。也多处提到了最终一致性数据库,以cassandra为例。还提到了couchbase,memcached,berkeley DB等。不到300页的书,不能要求更深入了。这本书读完之后,可...
作者主要关注了三类最常用的 nosql 数据库:文档数据库,列存储数据库,和键值数据库,主要以mongodb,hbase,redis为例。也多处提到了最终一致性数据库,以cassandra为例。还提到了couchbase,memcached,berkeley DB等。不到300页的书,不能要求更深入了。这本书读完之后,可...
本书是对NoSQL的入门级介绍,受篇幅所限,很多理论与内容无法一一详述,但如果读者有耐心,将书中所附内容外链之内容一一深入研究,就会对NoSQL有一个整体的全局认识,建议阅读本书之前,先研习《NoSQL精粹》,然后借助本书内容,结合论文以及各种DB的Github上的源码,辅以前人...
本书是对NoSQL的入门级介绍,受篇幅所限,很多理论与内容无法一一详述,但如果读者有耐心,将书中所附内容外链之内容一一深入研究,就会对NoSQL有一个整体的全局认识,建议阅读本书之前,先研习《NoSQL精粹》,然后借助本书内容,结合论文以及各种DB的Github上的源码,辅以前人...
用户评价
我是一名刚刚接触到大数据领域的初学者,对数据库的世界充满好奇。《深入NoSQL》这个名字对我来说,就像是一张藏宝图,指引着我走向一个充满未知与机遇的新大陆。在学校里,我们接触到的主要是关系型数据库,SQL语言对我来说已经比较熟悉了,但我也知道,在现实世界的很多复杂应用场景中,关系型数据库并不是唯一的选择,甚至可能不是最优的选择。听朋友说,NoSQL数据库在处理海量数据、高并发访问以及非结构化数据方面有着独特的优势。所以,我非常渴望通过这本书,能够系统地学习NoSQL的知识。我希望这本书能够从最基础的概念讲起,比如“NoSQL”到底代表着什么,它与SQL数据库的根本区别在哪里,以及为什么会出现NoSQL。我希望能看到对各种主流NoSQL数据库的详细介绍,包括它们各自的数据模型(文档型、键值型、列族型、图型),以及这些模型是如何被设计出来的,分别适用于哪些场景。同时,我也非常关注学习如何进行数据建模,因为我听说在NoSQL中,数据建模的方式与关系型数据库有很大的不同,需要从应用的需求出发来设计。安全性、备份恢复、以及如何进行性能优化这些实用的技能,也是我非常期待在书中找到答案的。
作为一个对技术充满热情的研究生,我对数据存储和处理的未来趋势非常关注。《深入NoSQL》这个书名,让我看到了一扇通往更广阔数据科学世界的大门。在学术研究中,我们经常需要处理各种复杂的数据集,这些数据往往具有高度的非结构化特性,并且规模庞大,传统的关系型数据库在处理这些数据时往往显得力不从心。我希望这本书能够提供扎实的理论基础,帮助我理解NoSQL数据库的核心原理,例如,各种数据模型(键值、文档、列族、图)的设计动机和优劣势分析,以及它们如何映射到实际的应用场景。我特别希望书中能够深入探讨分布式系统的设计,包括一致性协议(如Paxos、Raft)、数据复制策略、以及如何处理网络分区等问题。在算法层面,我希望能够了解NoSQL数据库是如何进行查询优化的,如何处理大数据量的聚合操作,以及在分布式环境下如何实现高效的数据检索。此外,如果书中能够结合一些经典的NoSQL应用案例,比如社交网络中的图数据库应用,或者物联网场景下的时序数据库应用,并对其进行深入分析,那将是非常有价值的。我希望这本书能够帮助我建立起一个关于NoSQL的系统性认知,为我未来的研究和开发工作打下坚实的基础。
我是一名对编程充满热情的大学生,在课堂之外,我也喜欢自己动手做一些小项目。《深入NoSQL》这本书,听起来就像是我提升编程技能、拓展技术视野的一本“秘籍”。虽然目前我的主要精力还在学习基础的算法和数据结构,以及掌握一门或几门编程语言,但我知道,在未来的开发实践中,了解不同的数据库技术是必不可少的。我希望这本书能够用通俗易懂的语言,为我揭开NoSQL神秘的面纱。我希望它能够详细介绍NoSQL数据库的种类,比如键值存储、文档数据库、列族数据库和图数据库,并且能够解释它们各自的数据组织方式是怎样的。我特别想了解,为什么不同的NoSQL数据库会有如此不同的设计?它们各自的优势和劣势又是什么?书中如果能包含一些简单的代码示例,演示如何使用这些NoSQL数据库来存储和查询数据,那将对我学习如何将这些技术应用到我的个人项目中非常有帮助。当然,我也会对NoSQL数据库的伸缩性、高可用性这些概念感到好奇,希望这本书也能解释清楚这些技术是如何实现的,以及它们对开发者的意义。
从我从事后端开发的经验来看,数据库的选择和优化直接关系到整个系统的稳定性和性能。《深入NoSQL》这个标题,毫不夸张地说,正是我近期在技术栈升级过程中非常迫切需要的知识。我们现在的项目,随着用户量的爆炸式增长和业务数据的几何级数扩张,传统的MySQL数据库在读写压力和横向扩展方面已经开始显现出瓶颈。我意识到,是时候深入理解并掌握NoSQL技术了。我期待这本书能够提供一套完整的理论框架,让我能够理解不同NoSQL数据库的哲学和设计思想,而不仅仅是学习API的调用。具体来说,我希望能够深入探讨CAP定理在不同NoSQL系统中的具体体现和权衡,例如,在Cassandra中如何理解“最终一致性”的实现细节,以及它如何保证高可用性;在MongoDB中,事务支持的引入又带来了哪些新的可能性和挑战。我对于分布式事务、数据分片策略、以及如何设计高效的索引来应对大数据量的查询也有着浓厚的兴趣。此外,这本书如果能提供一些关于如何进行数据迁移、如何构建混合云环境下的NoSQL解决方案,甚至是对一些新兴的NoSQL技术(如NewSQL)的初步探讨,那将是锦上添花。
我是一家初创公司的技术负责人,在公司快速发展的过程中,我们面临着技术选型和架构设计的巨大挑战。《深入NoSQL》这本书,恰好是我最近团队讨论中重点关注的技术领域之一。我们当前的业务场景,数据量增长迅猛,用户并发访问量也日益增高,原有的技术栈在扩展性和灵活性方面已经开始捉襟见肘。我需要一本能够提供深入洞察和实操指导的书籍,帮助我们团队做出明智的技术决策。我期待这本书能够系统地梳理NoSQL数据库的演进历程、核心设计理念以及不同数据模型的特点,并能够就如何根据业务需求选择最合适NoSQL数据库提供清晰的评估框架。更重要的是,我希望书中能够深入探讨分布式系统的构建和管理,包括数据分片(Sharding)的策略、副本(Replication)机制、以及一致性模型(Consistency Models)的权衡,并能给出在实际部署中如何实现高可用和灾难恢复的方案。我尤其关注的是,在面对海量数据场景时,如何进行有效的查询优化,如何设计可扩展的数据模型,以及如何构建低延迟、高吞吐量的读写服务。如果书中还能涉及到NoSQL数据库在云原生环境下的部署和管理,以及DevOps实践中的相关内容,那将对我们非常有价值。
这本书的标题《深入NoSQL》在我第一次看到的时候就吸引了我。作为一个在数据库领域摸爬滚打多年的开发者,我一直对关系型数据库的扩展性和灵活性局限性有着切身的体会,尤其是在面对海量数据、高并发读写以及多样化数据结构时,传统SQL数据库往往显得力不从心。NoSQL作为一种新兴的数据库范式,其多样化的数据模型和分布式架构,无疑为解决这些痛点提供了新的思路。我期待这本书能够带领我从更深层次理解NoSQL的本质,不仅仅是停留在“它是什么”的层面,而是能够真正“为什么”以及“怎么用”。我希望书中能够详细阐述不同NoSQL数据模型(键值对、文档、列族、图数据库)的设计理念、优缺点,以及在实际场景中选择哪种模型更合适。更重要的是,我希望这本书能够深入探讨NoSQL数据库的分布式原理、一致性模型(CAP定理的权衡)、以及如何在分布式环境下实现高可用和高性能。语言风格上,我偏爱严谨而又不失趣味的讲解,能够通过鲜活的案例和深入的原理分析,让我不仅知其然,更知其所以然。这本书的厚度也让我感到欣慰,意味着内容一定非常丰富,能够满足我探索的欲望。我迫不及待地想翻开它,开始这段NoSQL的深度探索之旅。
我在一家快速发展的互联网公司担任系统架构师,日常工作中需要不断评估和引入新的技术以应对业务的快速迭代和海量数据的挑战。《深入NoSQL》这个标题,在我看来,绝对是解决我们当前困境的“关键钥匙”。虽然我们已经在使用一些NoSQL服务,但对于其底层原理和最佳实践的理解,仍然存在不少盲区。我迫切需要一本能够帮助我们团队深入理解NoSQL技术体系的书。我期待这本书能够详细阐述不同NoSQL数据库在数据一致性(如强一致、最终一致)、可用性、分区容忍度(CAP理论)方面的权衡,并能给出具体的实践指导,说明在不同的业务场景下,应该如何选择最合适的模型和配置。例如,我们现在面临海量日志分析的需求,对写入性能和实时性要求极高,我希望这本书能深入讲解列族数据库(如Cassandra)在应对此类场景时的优势,以及其内部的数据组织和查询机制。同时,对于我们日益增长的用户关系和社交网络数据,图数据库的运用是必然趋势,我希望书中能够详细介绍图数据库的数据建模、查询语言(如Cygnus)以及其在社交网络分析、推荐系统等领域的应用。此外,高性能的内存数据库(如Redis)在缓存、会话管理等场景下的深度运用,以及如何构建高可用的NoSQL集群,也都是我非常关注的内容。
作为一个长期在数据工程一线工作的工程师,我始终关注着技术发展的最新动态,特别是那些能够显著提升开发效率和解决实际问题的技术。《深入NoSQL》这个书名,immediately piqued my interest because it suggests a comprehensive exploration of a domain that has become increasingly vital in modern software development. While I have a foundational understanding of various NoSQL databases like MongoDB, Cassandra, and Redis, I often feel that my knowledge is fragmented, lacking the cohesive understanding of their underlying architectural principles and the strategic considerations for choosing and implementing them effectively. I’m particularly keen to understand the nuances of different consistency models, the trade-offs involved in choosing between eventual consistency and strong consistency, and how these choices impact application design and performance. I also hope the book will delve into the practical aspects of migrating from relational databases to NoSQL, including common pitfalls and best practices for data modeling in a NoSQL context. The ability to scale horizontally and handle massive datasets with high availability is a core promise of NoSQL, and I’m eager to gain a deeper insight into the mechanisms that enable these capabilities, such as sharding, replication, and consensus protocols. Furthermore, I’m looking for practical guidance on performance tuning, query optimization within NoSQL databases, and strategies for managing complex data relationships that might be challenging in relational models.
作为一名对技术原理充满好奇心的软件工程师,我一直在思考“为什么”和“怎么做”的问题。《深入NoSQL》这个书名,恰好满足了我对技术深度挖掘的需求。我现有的知识体系中,对关系型数据库的理解相对比较扎实,但对于NoSQL,更多的是停留在“知道有这么回事”的层面,对其底层运作机制和设计哲学缺乏深入的了解。我希望这本书能够填补这一知识空白,让我能够真正理解不同NoSQL数据模型的优势所在,例如,文档数据库(如MongoDB)如何通过灵活的文档结构支持复杂数据,列族数据库(如Cassandra)如何通过列为中心的存储优化海量数据的读写,以及图数据库(如Neo4j)如何高效地表示和查询数据之间的关系。我非常渴望理解NoSQL数据库在分布式环境下的容错机制、一致性保证以及性能调优的策略。比如,CAP理论的取舍在不同NoSQL系统中的具体实现方式,以及如何通过调整配置参数来优化系统的表现。如果书中能够结合具体的数据库产品,深入剖析其内部架构,例如,MongoDB的存储引擎、Cassandra的LSM-tree结构,以及图数据库的遍历算法,那将是非常有启发性的。
作为一个在金融科技领域工作的开发者,我深知数据安全、稳定性和高性能对于我们业务的重要性。《深入NoSQL》这个书名,在我看到的时候,就激起了我极大的兴趣,因为金融行业的业务场景往往伴随着海量交易数据、复杂的业务逻辑以及极高的并发需求,这使得传统的关系型数据库在某些方面面临着巨大的压力。我希望这本书能够提供一个系统性的视角,让我能够全面地理解NoSQL数据库的架构设计、核心概念以及它们在金融领域的潜在应用。我特别关注的是,NoSQL数据库在处理高并发交易、保证数据一致性和可靠性方面的能力。例如,我希望了解在分布式NoSQL环境中,如何实现ACID事务的兼容性,或者如何在CAP理论的权衡下,设计出既能保证业务连续性又能满足一定一致性要求的解决方案。对于金融领域的风险控制、反欺诈等应用,图数据库的潜力巨大,我希望书中能有关于图数据库数据建模、查询以及在欺诈检测、身份验证等场景下的实际案例分析。同时,如何在高负载下保证NoSQL数据库的读写性能,如何进行有效的监控和运维,也是我非常希望能够从书中获取的宝贵经验。
大杂烩的介绍了一系列NOSQL数据库,不要被书名骗啦,讲了很多NOSQL数据库,是不可能做到深入的.了解罢了,还得再看其他文档
太粗了,什么都讲一点
看了一章,有点晦涩,弃了。看w3c直接些
谈不上深入,所有内容都是蜻蜓点水,泛泛的讲了讲
话题很广泛,可惜没有太深入的地方。代码示例太多,影响阅读流畅性