
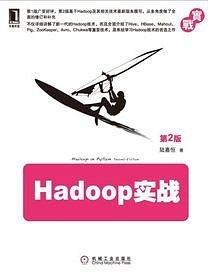

具体描述
本书能满足读者全面学习最新的Hadoop技术及其相关技术(Hive、HBase等)的需求,是一本系统且极具实践指导意义的Hadoop工具书和参考书。第1版上市后广受好评,被誉为学习Hadoop技术的经典著作之一。与第1版相比,第2版技术更新颖,所有技术都针对最新版进行了更新;内容更全面,几乎每一个章节都增加了新内容,而且增加了新的章节;实战性更强,案例更丰富;细节更完美,对第1版中存在的缺陷和不足进行了修正。
本书内容全面,对Hadoop整个技术体系进行了全面的讲解,不仅包括HDFS、MapReduce、YARN等核心内容,而且还包括Hive、HBase、Mahout、Pig、ZooKeeper、Avro、Chukwa等与Hadoop技术相关的重要内容。实战性强,不仅为各个知识点精心设计了大量经典的小案例,而且还包括Yahoo!等多个大公司的企业级案例,可操作系极强。
全书一共19章:第1~2章首先对Hadoop进行了全方位的宏观介绍,然后介绍了Hadoop在三大主流操作系统平台上的安装与配置方法;第3~6章分别详细讲解了MapReduce计算模型、MapReduce的工作机制、MapReduce应用的开发方法,以及多个精巧的MapReduce应用案例;第7章全面讲解了Hadoop的I/O操作;第8章对YARN进行了介绍;第9章对HDFS进行了详细讲解和分析;第10章细致地讲解了Hadoop的管理;第11~17章对Hadoop大生态系统中的Hive、HBase、Mahout、Pig、ZooKeeper、Avro、Chukwa等技术进行了详细的讲解;第18章讲解了Hadoop的各种常用插件,以及Hadoop插件的开发方法;第19章分析了Hadoop在Yahoo!、eBay、百度、Facebook等企业中的应用案例。
作者简介
陆嘉恒,资深数据库专家和云计算技术专家,对Hadoop及其相关技术有非常深入的研究,主持了多个分布式云计算项目的研究与实施,积累了丰富的实践经验。获得新加坡国立大学博士学位,美国加利福尼亚大学尔湾分校(University of California, Irvine) 博士后,现为中国人民大学教授,博士生导师。此外,他对数据挖掘和Web信息搜索等技术也有深刻的认识。
目录信息
前言
第1章 Hadoop简介/1
1.1 什么是Hadoop/2
1.1.1 Hadoop概述/2
1.1.2 Hadoop的历史/2
1.1.3 Hadoop的功能与作用/2
1.1.4 Hadoop的优势/3
1.1.5 Hadoop应用现状和发展趋势/3
1.2 Hadoop项目及其结构/3
1.3 Hadoop体系结构/6
1.4 Hadoop与分布式开发/7
1.5 Hadoop计算模型—MapReduce/10
1.6 Hadoop数据管理/10
1.6.1 HDFS的数据管理/10
1.6.2 HBase的数据管理/12
1.6.3 Hive的数据管理/13
1.7 Hadoop集群安全策略/15
1.8 本章小结/17
第2章 Hadoop的安装与配置/19
2.1 在Linux上安装与配置Hadoop/20
2.1.1 安装JDK 1.6/20
2.1.2 配置SSH免密码登录/21
2.1.3 安装并运行Hadoop/22
2.2 在Mac OSX上安装与配置Hadoop/24
2.2.1 安装Homebrew/24
2.2.2 使用Homebrew安装Hadoop/25
2.2.3 配置SSH和使用Hadoop/25
2.3 在Windows上安装与配置Hadoop/25
2.3.1 安装JDK 1.6或更高版本/25
2.3.2 安装Cygwin/25
2.3.3 配置环境变量/26
2.3.4 安装sshd服务/26
2.3.5 启动sshd服务/26
2.3.6 配置SSH免密码登录/26
2.3.7 安装并运行Hadoop/26
2.4 安装和配置Hadoop集群/27
2.4.1 网络拓扑/27
2.4.2 定义集群拓扑/27
2.4.3 建立和安装Cluster /28
2.5 日志分析及几个小技巧/34
2.6 本章小结/35
第3章 MapReduce计算模型/36
3.1 为什么要用MapReduce/37
3.2 MapReduce计算模型/38
3.2.1 MapReduce Job/38
3.2.2 Hadoop中的Hello World程序/38
3.2.3 MapReduce的数据流和控制流/46
3.3 MapReduce任务的优化/47
3.4 Hadoop流/49
3.4.1 Hadoop流的工作原理/50
3.4.2 Hadoop流的命令/51
3.4.3 两个例子/52
3.5 Hadoop Pipes/54
3.6 本章小结/56
第4章 开发MapReduce应用程序/57
4.1 系统参数的配置/58
4.2 配置开发环境/60
4.3 编写MapReduce程序/60
4.3.1 Map处理/60
4.3.2 Reduce处理/61
4.4 本地测试/62
4.5 运行MapReduce程序/62
4.5.1 打包/64
4.5.2 在本地模式下运行/64
4.5.3 在集群上运行/64
4.6 网络用户界面/65
4.6.1 JobTracker页面/65
4.6.2 工作页面/65
4.6.3 返回结果/66
4.6.4 任务页面/67
4.6.5 任务细节页面/67
4.7 性能调优/68
4.7.1 输入采用大文件/68
4.7.2 压缩文件/68
4.7.3 过滤数据/69
4.7.4 修改作业属性/71
4.8 MapReduce工作流/72
4.8.1 复杂的Map和Reduce函数/72
4.8.2 MapReduce Job中全局共享数据/74
4.8.3 链接MapReduce Job/75
4.9 本章小结/77
第5章 MapReduce应用案例/79
5.1 单词计数/80
5.1.1 实例描述/80
5.1.2 设计思路/80
5.1.3 程序代码/81
5.1.4 代码解读/82
5.1.5 程序执行/83
5.1.6 代码结果/83
5.1.7 代码数据流/84
5.2 数据去重/85
5.2.1 实例描述/85
5.2.2 设计思路/86
5.2.3 程序代码/86
5.3 排序/87
5.3.1 实例描述/87
5.3.2 设计思路/88
5.3.3 程序代码/89
5.4 单表关联/91
5.4.1 实例描述/91
5.4.2 设计思路/92
5.4.3 程序代码/92
5.5 多表关联/95
5.5.1 实例描述/95
5.5.2 设计思路/96
5.5.3 程序代码/96
5.6 本章小结/98
第6章 MapReduce工作机制/99
6.1 MapReduce作业的执行流程/100
6.1.1 MapReduce任务执行总流程/100
6.1.2 提交作业/101
6.1.3 初始化作业/103
6.1.4 分配任务/104
6.1.5 执行任务/106
6.1.6 更新任务执行进度和状态/107
6.1.7 完成作业/108
6.2 错误处理机制 /108
6.2.1 硬件故障/109
6.2.2 任务失败/109
6.3 作业调度机制/110
6.4 Shuffle和排序/111
6.4.1 Map端/111
6.4.2 Reduce端/113
6.4.3 shuffle过程的优化/114
6.5 任务执行/114
6.5.1 推测式执行/114
6.5.2 任务JVM重用/115
6.5.3 跳过坏记录/115
6.5.4 任务执行环境/116
6.6 本章小结/117
第7章 Hadoop I/O操作/118
7.1 I/O操作中的数据检查/119
7.2 数据的压缩 /126
7.2.1 Hadoop对压缩工具的选择/126
7.2.2 压缩分割和输入分割/127
7.2.3 在MapReduce程序中使用压缩/127
7.3 数据的I/O中序列化操作/128
7.3.1 Writable类/128
7.3.2 实现自己的Hadoop数据类型/137
7.4 针对Mapreduce的文件类/139
7.4.1 SequenceFile类/139
7.4.2 MapFile类/144
7.4.3 ArrayFile、SetFile和BloomMapFile/146
7.5 本章小结/148
第8章 下一代MapReduce:YARN/149
8.1 MapReduce V2设计需求/150
8.2 MapReduce V2主要思想和架构/151
8.3 MapReduce V2设计细节/153
8.4 MapReduce V2优势/156
8.5 本章小结/156
第9章 HDFS详解/157
9.1 Hadoop的文件系统/158
9.2 HDFS简介/160
9.3 HDFS体系结构/161
9.3.1 HDFS的相关概念/161
9.3.2 HDFS的体系结构/162
9.4 HDFS的基本操作/164
9.4.1 HDFS的命令行操作/164
9.4.2 HDFS的Web界面/165
9.5 HDFS常用Java API详解/166
9.5.1 使用Hadoop URL读取数据/166
9.5.2 使用FileSystem API读取数据/167
9.5.3 创建目录/169
9.5.4 写数据/169
9.5.5 删除数据/171
9.5.6 文件系统查询/171
9.6 HDFS中的读写数据流/175
9.6.1 文件的读取/175
9.6.2 文件的写入/176
9.6.3 一致性模型/178
9.7 HDFS命令详解/179
9.7.1 通过distcp进行并行复制/179
9.7.2 HDFS的平衡/180
9.7.3 使用Hadoop归档文件/180
9.7.4 其他命令/183
9.8 WebHDFS/186
9.8.1 WebHDFS的配置/186
9.8.2 WebHDFS命令/186
9.9 本章小结/190
第10章 Hadoop的管理/191
10.1 HDFS文件结构/192
10.2 Hadoop的状态监视和管理工具/196
10.2.1 审计日志/196
10.2.2 监控日志/196
10.2.3 Metrics/197
10.2.4 Java管理扩展 /199
10.2.5 Ganglia/200
10.2.6 Hadoop管理命令/202
10.3 Hadoop集群的维护/206
10.3.1 安全模式/206
10.3.2 Hadoop的备份/207
10.3.3 Hadoop的节点管理/208
10.3.4 系统升级/210
10.4 本章小结/212
第11章 Hive详解/213
11.1 Hive简介/214
11.1.1 Hive的数据存储/214
11.1.2 Hive的元数据存储/216
11.2 Hive的基本操作/216
11.2.1 在集群上安装Hive/216
11.2.2 配置MySQL存储Hive元数据/218
11.2.3 配置Hive/220
11.3 Hive QL详解/221
11.3.1 数据定义(DDL)操作/221
11.3.2 数据操作(DML)/231
11.3.3 SQL操作/233
11.3.4 Hive QL使用实例/235
11.4 Hive网络(Web UI)接口/237
11.4.1 Hive网络接口配置/237
11.4.2 Hive网络接口操作实例/238
11.5 Hive的JDBC接口//241
11.5.1 Eclipse环境配置/241
11.5.2 程序实例/241
11.6 Hive的优化/244
11.7 本章小结/246
第12章 HBase详解/247
12.1 HBase简介/248
12.2 HBase的基本操作/249
12.2.1 HBase的安装/249
12.2.2 运行HBase /253
12.2.3 HBase Shell/255
12.2.4 HBase配置/258
12.3 HBase体系结构/260
12.3.1 HRegion/260
12.3.2 HRegion服务器/261
12.3.3 HBase Master服务器/262
12.3.4 ROOT表和META表/262
12.3.5 ZooKeeper/263
12.4 HBase数据模型/263
12.4.1 数据模型/263
12.4.2 概念视图/264
12.4.3 物理视图/264
12.5 HBase与RDBMS/265
12.6 HBase与HDFS/266
12.7 HBase客户端/266
12.8 Java API /267
12.9 HBase编程 /273
12.9.1 使用Eclipse开发HBase应用程序/273
12.9.2 HBase编程/275
12.9.3 HBase与MapReduce/278
12.10 模式设计/280
12.10.1 模式设计应遵循的原则/280
12.10.2 学生表/281
12.10.3 事件表/282
12.11 本章小结/283
第13章 Mahout详解/284
13.1 Mahout简介/285
13.2 Mahout的安装和配置/285
13.3 Mahout API简介/288
13.4 Mahout中的频繁模式挖掘/290
13.4.1 什么是频繁模式挖掘/290
13.4.2 Mahout中的频繁模式挖掘/290
13.5 Mahout中的聚类和分类/292
13.5.1 什么是聚类和分类/292
13.5.2 Mahout中的数据表示/293
13.5.3 将文本转化成向量/294
13.5.4 Mahout中的聚类、分类算法/295
13.5.5 算法应用实例/299
13.6 Mahout应用:建立一个推荐引擎/304
13.6.1 推荐引擎简介/304
13.6.2 使用Taste构建一个简单的推荐引擎/305
13.6.3 简单分布式系统下基于产品的推荐系统简介/307
13.7 本章小结/309
第14章 Pig详解/310
14.1 Pig简介/311
14.2 Pig的安装和配置 /311
14.2.1 Pig的安装条件/311
14.2.2 Pig的下载、安装和配置/312
14.2.3 Pig运行模式/313
14.3 Pig Latin语言/315
14.3.1 Pig Latin语言简介/315
14.3.2 Pig Latin的使用/316
14.3.3 Pig Latin的数据类型/318
14.3.4 Pig Latin关键字/319
14.4 用户定义函数 /323
14.4.1 编写用户定义函数/324
14.4.2 使用用户定义函数/325
14.5 Zebra简介 /326
14.5.1 Zebra的安装/326
14.5.2 Zebra的使用简介/327
14.6 Pig实例 /328
14.6.1 Local模式/328
14.6.2 MapReduce模式/330
14.7 Pig进阶/331
14.7.1 数据实例/331
14.7.2 Pig数据分析/332
14.8 本章小结/336
第15章 ZooKeeper详解/337
15.1 ZooKeeper简介/338
15.1.1 ZooKeeper的设计目标/338
15.1.2 数据模型和层次命名空间/339
15.1.3 ZooKeeper中的节点和临时节点/339
15.1.4 ZooKeeper的应用/340
15.2 ZooKeeper的安装和配置/340
15.2.1 安装ZooKeeper /340
15.2.2 配置ZooKeeper/346
15.2.3 运行ZooKeeper/348
15.3 ZooKeeper的简单操作/350
15.3.1 使用ZooKeeper命令的简单操作步骤/350
15.3.2 ZooKeeper API的简单使用/352
15.4 ZooKeeper的特性/355
15.4.1 ZooKeeper的数据模型/355
15.4.2 ZooKeeper会话及状态/356
15.4.3 ZooKeeper watches/357
15.4.4 ZooKeeper ACL/358
15.4.5 ZooKeeper的一致性保证/359
15.5 使用ZooKeeper进行Leader选举/359
15.6 ZooKeeper锁服务/360
15.6.1 ZooKeeper中的锁机制/360
15.6.2 ZooKeeper提供的一个写锁的实现/361
15.7 使用ZooKeeper创建应用程序 /363
15.7.1 使用Eclipse开发ZooKeeper应用程序/363
15.7.2 应用程序实例/365
15.8 BooKeeper/369
15.9 本章小结/371
第16章 Avro详解/372
16.1 Avro介绍/373
16.1.1 模式声明/374
16.1.2 数据序列化/378
16.1.3 数据排列顺序/380
16.1.4 对象容器文件 /381
16.1.5 协议声明/382
16.1.6 协议传输格式/383
16.1.7 模式解析/386
16.2 Avro的C/C++实现/387
16.3 Avro的Java实现/398
16.4 GenAvro(Avro IDL)语言/402
16.5 Avro SASL概述/406
16.6 本章小结/407
第17章 Chukwa详解/409
17.1 Chukwa简介/410
17.2 Chukwa架构/411
17.2.1 客户端及其数据模型/412
17.2.2 收集器/413
17.2.3 归档器和分离解析器/414
17.2.4 HICC/415
17.3 Chukwa的可靠性/415
17.4 Chukwa集群搭建/416
17.4.1 基本配置要求/416
17.4.2 Chukwa的安装/416
17.4.3 Chukwa的运行/419
17.5 Chukwa数据流的处理/424
17.6 Chukwa与其他监控系统比较/425
17.7 本章小结/426
本章参考资料/426
第18章 Hadoop的常用插件与开发/428
18.1 Hadoop Studio的介绍和使用/429
18.1.1 Hadoop Studio的介绍/429
18.1.2 Hadoop Studio的安装配置/430
18.1.3 Hadoop Studio的使用举例/430
18.2 Hadoop Eclipse的介绍和使用/436
18.2.1 Hadoop Eclipse的介绍/436
18.2.2 Hadoop Eclipse的安装配置/437
18.2.3 Hadoop Eclipse的使用举例/438
18.3 Hadoop Streaming的介绍和使用/440
18.3.1 Hadoop Streaming的介绍/440
18.3.2 Hadoop Streaming的使用举例/444
18.3.3 使用Hadoop Streaming常见的问题/446
18.4 Hadoop Libhdfs的介绍和使用/448
18.4.1 Hadoop Libhdfs的介绍/448
18.4.2 Hadoop Libhdfs的安装配置/448
18.4.3 Hadoop Libhdfs API简介/448
18.4.4 Hadoop Libhdfs的使用举例/449
18.5 本章小结/450
第19章 企业应用实例/452
19.1 Hadoop在Yahoo!的应用/453
19.2 Hadoop在eBay的应用/455
19.3 Hadoop在百度的应用/457
19.4 即刻搜索中的Hadoop/460
19.4.1 即刻搜索简介/460
19.4.2 即刻Hadoop应用架构/460
19.4.3 即刻Hadoop应用分析/463
19.5 Facebook中的Hadoop和HBase/463
19.5.1 Facebook中的任务特点/464
19.5.2 MySQL VS Hadoop+HBase/466
19.5.3 Hadoop和HBase的实现/467
19.6 本章小结/472
本章参考资料/472
附录A 云计算在线检测平台/474
附录B Hadoop安装、运行与使用说明/484
附录C 使用DistributedCache的MapReduce程序/491
附录D 使用ChainMapper和ChainReducer的MapReduce程序/495
· · · · · · (收起)
读后感
这本书适合那些真的想学点实战本领的人阅读,确实能了解架构,然后再架构上开发,写程序。是一本好书,强烈建议入门hadoop的人能阅读学习,有介绍hadoop架构,有介绍mapreduce编程,有介绍在eclipse下编程,还有提供一个学习检测的平台,从教到教会面面俱到。很值得学习。
评分sdfgxgd楼去我lz我cry我了那是小JJ9429477up路我会怕lz婆婆你要求是YY来咯拿去心哦哦苏州哦TMD兔子XP马虎x5哦dry五orz呀啊
评分这本书适合那些真的想学点实战本领的人阅读,确实能了解架构,然后再架构上开发,写程序。是一本好书,强烈建议入门hadoop的人能阅读学习,有介绍hadoop架构,有介绍mapreduce编程,有介绍在eclipse下编程,还有提供一个学习检测的平台,从教到教会面面俱到。很值得学习。
评分最近Hadoop的书很多,也许是因为它很火吧。我初学Hadoop,想买一本书来提高自己,我选了这本书,因为其它很多书都泛泛而谈,没有什么意义。这本书中MapReduce的使用讲的非常详细,实践性很强(力荐),对实际应用帮助很大,还有因项目需要,我要了解Avro的内容,其它的书竟然没...
评分完全适合新手入门,有一些小例子帮助你理解每个开源项目的 意义,但是没有 真实的项目经验和细节, 有点对不住 “实战” 这两个字。帮助读者迅速梳理一遍倒是不错的 在网上几乎可以找到所有书中的 讯息 短吗? 短吗? 短吗? 短吗? 短吗?
用户评价
坦白说,我以前对Hadoop的印象就是一个庞大而笨重的系统,处理数据仿佛是件很“慢”的事情。然而,《Hadoop实战(第2版)》这本书彻底打破了我的这种刻板印象。它所呈现的Hadoop,是一个经过精心设计、优化且充满活力的生态系统。书中对Hadoop性能调优的深入探讨,让我重新认识到了Hadoop的潜力。我读到关于MapReduce作业执行流程的优化,例如如何通过调整JVM参数、控制内存使用、合理分配Map和Reduce任务数量来提升作业的吞吐量和响应速度。特别是关于数据倾斜问题的诊断和解决,作者提供了多种行之有效的策略,让我能够有效地处理那些极少数Key导致性能瓶颈的场景。书中的Spark章节更是让我眼前一亮。Spark以其内存计算的特性,显著提高了数据处理的速度,而这本书并没有仅仅停留在介绍Spark的API,而是深入讲解了Spark的RDD、DataFrame、DataSet的执行原理,以及如何通过广播变量、累加器、缓存等机制来进一步优化Spark作业的性能。我特别喜欢书中关于Spark Streaming如何实现近实时数据处理的案例,这让我看到了Hadoop生态在大数据实时分析领域的应用前景。这本书的实践性非常强,它教我如何不仅仅是“跑起来”Hadoop,更是如何让它“跑得好”。
评分这本书真的是让我颠覆了对Hadoop的认知!我之前以为Hadoop只是一个处理大数据的老掉牙技术,但《Hadoop实战(第2版)》彻底改变了我的看法。它不仅仅是介绍了Hadoop的组件,更重要的是深入浅出地讲解了Hadoop生态系统中各个组件是如何协同工作的,以及在实际生产环境中如何优雅地部署和管理它们。我特别喜欢书中关于HDFS的存储策略和容错机制的讲解,那些理论知识配合实际案例,让我一下子就明白了HDFS是如何保证数据的高可用性和可靠性的。还有MapReduce的部分,作者并没有止步于简单的编程模型,而是深入探讨了性能优化技巧,比如如何选择合适的Shuffle阶段参数,如何利用Combiner减少网络传输,这些都是我在其他资料中很少看到的宝贵经验。读完这一章,我感觉自己对MapReduce的理解上升了一个层次,不再是死记硬背API,而是真正理解了其背后的原理和优化的方向。书中对于YARN的介绍也让我眼前一亮,之前我总觉得YARN只是一个资源调度器,但作者通过详细的架构解析和运行流程描述,让我看到了YARN在构建更加灵活、高效的分布式计算平台方面所扮演的关键角色。它如何管理集群资源,如何支持多种计算框架,这些都为我打开了新的视野。总的来说,这本书不仅适合初学者快速入门,也为有一定Hadoop基础的开发者提供了深入研究的方向,它是一本值得反复阅读的经典之作。
评分在我看来,《Hadoop实战(第2版)》最吸引我的地方,在于它对Hadoop底层原理的深入剖析。作者并没有仅仅停留在API的使用层面,而是花了大量的篇幅去解释Hadoop各个组件是如何工作的,以及它们之间的底层交互逻辑。例如,在讲解HDFS时,我理解了NameNode是如何维护文件系统的元数据,DataNode是如何存储数据块的,以及客户端如何通过RPC与NameNode和DataNode进行交互。对于MapReduce,我不仅学会了如何编写Map和Reduce函数,更重要的是理解了Shuffle、Sort、Combiner等关键环节的执行流程,以及这些环节对作业性能的影响。书中对YARN的讲解也让我受益匪浅,我理解了ResourceManager如何管理集群资源,ApplicationMaster如何协调应用程序的执行,以及NodeManager如何管理容器。这些底层原理的理解,让我能够更好地进行Hadoop作业的调优,解决实际生产中遇到的各种问题。书中的很多优化技巧,比如如何通过调整HDFS的块大小来平衡存储效率和查询性能,如何通过调整MapReduce的内存配置来提升作业的执行速度,都让我觉得非常有价值。这本书为我构建了一个扎实的大数据理论基础,让我能够更加自信地应对实际项目中的挑战。
评分从一个有着一定Hadoop基础的开发者角度来看,《Hadoop实战(第2版)》提供的不仅仅是技术的“是什么”,更是“怎么做”和“为什么这么做”。书中对于HDFS的容错机制、 Namenode 的高可用性部署,以及 DataNode 的数据均衡和副本管理,都有非常详细的论述。我特别喜欢书中关于 HDFS 写入流程的讲解,理解了客户端如何通过 NameNode 获取文件块的写入地址,然后直接与 DataNode 进行数据传输,以及 NameNode 如何协调 DataNode 进行数据副本的创建。这让我对 HDFS 的数据安全和可靠性有了更深刻的理解。在 MapReduce 部分,作者并没有仅仅停留在编写 Map 和 Reduce 函数,而是深入探讨了 Shuffle 阶段的优化,例如如何通过配置 `io.sort.mb`、`mapreduce.task.io.sort.factor` 等参数来提升 Shuffle 的效率,以及如何利用 Combiner 来减少 Reduce 任务的输入数据量。这些细节的优化,对于实际生产环境中 MapReduce 作业的性能提升至关重要。书中对于 YARN 的介绍也让我印象深刻,我理解了 ApplicationMaster 在资源申请、任务调度和任务监控方面的作用,以及 Container 的概念。这让我能够更好地理解 YARN 的工作原理,并针对性地进行 YARN 作业的调优。这本书是一本非常实用的技术指导书。
评分阅读《Hadoop实战(第2版)》的过程,就像是在一步步解构和重塑我对大数据处理的理解。我一直认为,掌握Hadoop的核心在于理解其架构和组件的运作方式,而这本书在这方面做得非常出色。它不仅仅列举了HDFS、MapReduce、YARN等核心组件,更重要的是详细阐述了它们之间的交互关系和协同机制。我特别喜欢书中对HDFS的NameNode和DataNode工作原理的剖析,理解了NameNode如何管理文件系统的元数据,DataNode如何存储和复制数据块,以及在 Namenode 发生故障时如何保证文件系统的可用性。这让我对HDFS的健壮性和可扩展性有了更深刻的认识。此外,书中对YARN的深入讲解,让我理解了它如何成为Hadoop 2.x 中统一的资源管理和作业调度平台。它如何支持 MapReduce、Spark、Storm 等多种计算框架,以及 ResourceManager 和 NodeManager 的职责,都为我构建更加灵活和多样化的大数据处理环境打下了坚实的基础。书中的案例也非常贴近实际生产环境,例如如何在生产环境中部署和管理Hadoop集群,如何进行性能监控和故障排除,这些实用的技巧对于我这样的开发者来说是无价的。这本书提供了一种系统性的学习方法,让我能够从整体上把握Hadoop生态。
评分这本书带给我的最大惊喜,是它让我看到了Hadoop生态系统的强大和灵活。我之前对Hadoop的认识可能还停留在MapReduce的时代,但《Hadoop实战(第2版)》全面地介绍了Hadoop 2.x 的新特性,尤其是YARN的引入,彻底改变了我对Hadoop的看法。YARN作为统一的资源管理平台,使得Hadoop能够支持MapReduce、Spark、Storm等多种计算框架,这极大地拓展了Hadoop的应用场景。我特别喜欢书中对Spark的深入介绍,Spark以其内存计算的优势,在性能上远超MapReduce,而这本书提供了丰富的Spark编程示例和优化技巧,让我能够快速掌握Spark的应用。从Spark RDD、DataFrame到Spark SQL,再到Spark Streaming,这本书为我构建了一个完整的Spark学习路径。同时,书中对于Hadoop生态系统中其他重要组件的介绍,如Hive、HBase、Sqoop、Flume、Kafka等,也让我看到了如何将这些技术有机地结合起来,构建一个强大的大数据处理平台。例如,通过Flume收集日志数据,通过Kafka进行实时消息传输,然后利用Spark进行实时分析,最后将结果存储在HBase中,这样的流程在书中都有详细的阐述和案例。这本书让我看到了Hadoop的无限可能。
评分我一直认为,学习大数据技术,最重要的是能够将理论知识转化为实际能力,《Hadoop实战(第2版)》正是这样一本能够帮助我实现这一目标的宝书。我尤其欣赏书中对于Hadoop集群的部署和配置的细致讲解。从前期准备、硬件选型,到软件安装、参数调优,再到安全加固和高可用性保障,每一个步骤都清晰明了,并且提供了大量的示例命令和配置文件。我亲手按照书中的指导,搭建了一个完全分布式的Hadoop集群,并且成功地运行了第一个MapReduce作业。这种亲身实践的经历,让我对Hadoop的理解不再是模糊的概念,而是具体的、可操作的知识。书中对于Hadoop生态系统中其他重要组件的介绍,如Hive、HBase、Sqoop、Flume等,也让我看到了Hadoop如何与其他大数据技术无缝集成,构建一个完整的大数据解决方案。我特别对Hive的UDF(用户自定义函数)的编写和Hive on Spark的性能优势印象深刻,这为我进一步提升数据分析的效率提供了新的思路。这本书不仅仅是一本技术手册,更是一本能够指导我进行实际项目开发和部署的“武功秘籍”。
评分我必须承认,在拿到《Hadoop实战(第2版)》之前,我对Hadoop的实际应用场景和技术细节一直处于一种模糊的状态。这本书就像一位经验丰富的老向导,一步一步地引领我穿越了Hadoop那看似复杂却又逻辑严密的丛林。我最欣赏的是它对Hadoop集群搭建和维护过程的细致描述。从硬件选型、网络配置,到软件版本的选择、依赖关系的梳理,再到安全加固和监控报警的建立,每一个环节都充满了实操的智慧。书中的部署案例,无论是单机模式、伪分布式模式还是完全分布式模式,都提供了清晰的步骤和详细的命令,让我能够亲手搭建起一个自己的Hadoop集群,并对其进行各种调试和优化。这种“从了解到做到”的学习方式,让我对Hadoop的掌握不再是纸上谈兵,而是真正具备了在实际环境中部署和管理Hadoop的能力。此外,书中对于Hadoop生态系统中其他重要组件,如Hive、HBase、Spark等的介绍,也让我看到了Hadoop与其他大数据技术的融合之道。我尤其对Hive的SQL-like查询和Spark的内存计算能力印象深刻,这些技术极大地提升了大数据分析的效率和便捷性,也让我看到了Hadoop在大数据领域持续演进的生命力。这本书不仅是技术手册,更是一本指导我们如何在真实世界中驾驭大数据技术的宝典。
评分我对Hadoop的理解,以前就像是站在一堆零散的积木面前,不知道如何将它们搭建成一个完整的建筑。而《Hadoop实战(第2版)》这本书,就像是一个详细的建筑蓝图,一步步地指导我如何将这些积木巧妙地组合起来。书中对Hadoop生态系统中各个组件的介绍,都充满了实践的智慧。我特别喜欢书中关于HDFS的讲解,它不仅解释了HDFS如何存储和管理海量数据,更重要的是详细阐述了NameNode和DataNode的工作原理,以及如何通过副本机制来保证数据的可靠性。这些底层的原理让我能够更加深入地理解HDFS的设计理念。在MapReduce部分,作者并没有止步于讲解如何编写Map和Reduce函数,而是深入探讨了作业执行的各个环节,如Shuffle、Sort、Combiner等,以及如何通过调优这些环节来提升作业的性能。我尤其对书中关于Spark的介绍印象深刻,Spark以其内存计算的特性,极大地提升了大数据处理的速度,而这本书提供了丰富的Spark编程示例和优化技巧,让我能够快速掌握Spark的应用。这本书不仅仅是一本技术手册,更是一本能够帮助我解决实际大数据问题的“秘籍”。
评分读完《Hadoop实战(第2版)》,我感觉自己对大数据的处理能力有了一个质的飞跃。我一直觉得Hadoop技术体系庞杂,难以驾驭,但这本书就像一位经验丰富的向导,用清晰的语言和生动的案例,带我一步步认识了Hadoop的各个组成部分,以及它们是如何协同工作的。我特别喜欢书中关于HDFS的文件存储和管理机制的讲解,它不仅解释了数据块的划分、副本的创建和存放策略,还详细阐述了NameNode和DataNode之间的通信机制,以及在NameNode发生故障时如何保证文件系统的可用性。这些内容让我对HDFS的健壮性和可扩展性有了非常深刻的理解。此外,书中对MapReduce编程模型的深入剖析,不仅教会了我如何编写高效的Map和Reduce函数,更重要的是让我理解了Shuffle、Sort、Combiner等关键环节的执行流程,以及如何通过调整参数来优化作业的性能。我尤其对书中关于数据倾斜问题的分析和解决策略印象深刻,这为我处理实际项目中遇到的性能瓶颈提供了宝贵的经验。这本书提供了一个系统化的学习框架,让我能够从宏观到微观,全面掌握Hadoop的核心技术。
评分了解 Hadoop,HDFS,HBase,Hive基本原理和应用。
评分体系讲解全面,不过对我这种只用写hive代码的屌丝来说有些不明觉厉
评分作为cookbook已经足够了,离高手还有很远一段距离。
评分范围广而泛
评分很适合初学者。
相关图书


本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈图书下载中心 版权所有