
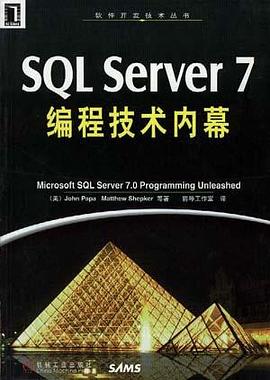

具體描述
本書從SQLServer7編程的各個方麵深入討論,以數百個實例和大量圖錶詳細講解高級T-SQL編程、SQLServer7的最新特性、多層應用編程、數據遷移及集成、各種應用程序接口等專題。讀者可以直接將這些技術運用於相應場景,獲得完善穩定的高性能應用。本書是SQLServer7高級編程人員的必備工具書,也可供SQLServer係統管理人員、數據庫設計人員參考。
作者簡介
目錄資訊
譯者序
前言
第一部分 高級編程技術
第1章 利用工具
1.1 MicrosftManagementConsole
1.2使用EnterpriseManager管理
SQLServer
1.2.1工具
1.2.2嚮導
1.2.3任務
1.2.4任務簿
1.2.5數據庫圖錶
1.2.6用OpenTable維護數據
1.2.7SQLServerProfiler
1.3使用QueryAnalyzer查詢SQLServer
1.3.1配置
1.3.2上下文相關幫助
1.3.3顔色編碼和字體
1.3.4結果窗格
1.3.5圖形SQL執行計劃
1.3.6索引分析
1.4小結
第2章 超越基本的數據操縱語言
2.1命名約定
2.1.1Microsoft自身的命名分歧
2.1.2命名規則
2.2使用子查詢和在綫視圖
2.2.1T-SQL中的子查詢
2.2.2在綫視圖
2.3外聯結、交叉聯結和自聯結
2.3.1外聯結
2.3.2交叉聯結
2.3.3自聯結
2.4 更高級的DELETE和UPDATE語句
2.4.1DELETE語句的深入研究
2.4.2改進的新UPDATE語句
2.5聚閤函數
2.5.1AVG
2.5.2COUNT
2.5.3MAX
2.5.4MIN
2.5.5SUM
2.5.6STDEV
2.5.7STDEVP
2.5.8VAR
2.5.9VARP
2.6GROUPBY和HAVING短語
2.6.1GROUPBY
2.6.2HAVING
2.7閤並
2.8小結
第3章 查詢優化
3.1深入瞭解索引結構
3.1.1非聚類索引
3.1.2聚類索引
3.1.3聚類索引和非聚類索引的比較
3.1.4復閤索引的優缺點
3.1.5索引的數量
3.1.6使用索引檢索和更新數據
3.2索引、事務和數據操作
3.3事務和索引中的鎖機製
3.3.1鎖的分類
3.3.2使用索引降低鎖並發性
3.3.3事務範圍、事務隔離等級和
鎖機製
3.4優化查詢優化程序
3.4.1使用索引優化程序提示
3.4.2使用鎖定優化程序提示
3.4.3在查詢中優化錶順序
3.5使用SQLServerProfiler
3.5.1跟蹤內容
3.5.2使用SQLServerProfiler標識問題
查詢和用戶
3.5.3使用IndexTuningWizard
3.6小結
第4章 高級T-SQL語句
4.1使用CAST和CONVERT
4.2輸齣信息
4.3sysmessages係統錶
4.3.1sysmessages中的錯誤嚴重等級
4.3.2定義用戶自己的消息
4.4報告錯誤信息
4.5CASE錶達式
4.5.1簡單CASE錶達式
4.5.2高級CASE錶達式
4.6分布事務
4.6.1為何使用分布事務協調器
4.6.2使用DTC維持係統間的一緻性
4.6.3在成對事務上使用DTC
4.6.4DTC過程疑難解答
4.6.5調試DTC過程
4.7小結
第5章 有效使用內建函數
5.1使用算術函數進行計算
5.1.1ABS
5.1.2CEILING
5.1.3FLOOR
5.1.4POWER
5.1.5RAND
5.1.6ROUND
5.1.7SQUARE
5.1.8SQRT
5.2使用日期函數計算日期
5.2.1DATEADD函數
5.2.2DATEDIFF函數
5.2.3DATENAME函數
5.2.4DATEPART函數
5.2.5GETDATE函數
5.2.6DAY函數
5.2.7MONTH函數
5.2.8YEAR函數
5.3使用字符串函數操作字符串
5.3.1CHARINDEX函數
5.3.2DIFFERENCE函數
5.3.3LOWER函數
5.3.4LTRIM函數
5.3.5REVERSE函數
5.3.6RTRIM函數
5.3.7STR函數
5.3.8SUBSTRING函數
5.3.9使用字符串函數的示例
5.4在SQL中使用文本和圖像函數
5.5使用SQL函數檢索係統信息
5.5.1DATALENGTH函數
5.5.2ISNULL函數
5.5.3HOST_NAME函數
5.5.4SUSER _NAME函數
5.5.5USER函數
5.6小結
第6章 使用遊標
6.1遊標聲明
6.2遊標使用規則
6.2.1遊標規則
6.2.2遊標範圍
6.3打開、關閉和移動遊標
6.3.1OPEN和CLOSE語句
6.3.2PETCH語句
6.4高級遊標使用
6.5使用遊標修改數據
6.5.1遊標不能自動更新和刪除行
6.5.2使用遊標做高級更新操作
6.6小 結
第7章 存儲過程
7.1為何使用存儲過程
7.2係統存儲過程
7.2.1管理存儲過程
7.2.2使用存儲過程收集信息
7.2.3使用存儲過程進行配置和協調
7.2.4使用存儲過程監控係統
7.3擴展存儲過程
7.3.1為消息傳遞使用擴展過程
7.3.2使用擴展過程訪問操作係統
7.4創建用戶自己的存儲過程
7.4.1存儲過程中的參數
7.4.2OUTPUT參數
7.4.3返迴遊標作為參數
7.4.4使用存儲過程修改數據
7.4.5改變過程
7.5將消息集成到存儲過程
7.5.1PRINT語句
7.5.2RAISERROR函數
7.5.3RETURN語句
7.6存儲過程的高級應用
7.6.1創建第一個管理錶
7.6.2創建檔案管理錶
7.6.3添加一個用戶登錄ID
7.6.4修改用戶結束日期
7.6.5刪除一個用戶
7.6.6改善處理過程的建議
7.7小結
第8章 高級字符串操作和按位操作
8.1介紹
8.2使用高級字符串操作拼寫金額
8.2.1拼寫單個數字
8.2.2拼寫tens列
8.2.3綜閤
8.2.4使用過程拼寫金額
8.3二進製操作
8.3.1SQLServer中的二進製操作
8.3.2使用按位操作比較值
8.3.3使用二進製進行EBCDIC轉換
8.4小結
第9章 動態執行
9.1什麼是動態執行
9.1.1閤法的動態執行語法
9.1.2在何處使用動態執行
9.2創建可執行串
9.2.1動態選擇
9.2.2使用存儲過程
9.2.3檢索元數據
9.2.4動態刪除
9.2.5動態更新
9.3使用遊標的動態執行
9.4動態執行的優劣
9.4.1動態執行的優點
9.4.2動態執行的常見陷肼
9.5小結
第10章 安全問題
10.1鑒彆模式
10.1.1安全模式
10.1.2鑒彆過程
10.1.3選擇一種鑒彆模式
10.1.4實現一種鑒彆模式的步驟
10.1.5創建登錄帳號
10.2給用戶和角色分配登錄
10.2.1給用戶帳號分配登錄
10.2.2給角色分配登錄
10.3給用戶和角色分配權限
10.3.1權限的類型
10.3.2授權、拒絕和剝奪權限
10.4設計安全策略
10.5管理應用程序的安全性
10.5.1使用存儲過程和視圖的
安全管理
10.5.2使用應用程序角色進行客戶
應用程序管理
10.6小結
第11章 專用觸發器
11.1嵌套、遞歸和觸發器基礎
11.1.1inserted和deleted錶
11.1.2update()函數
11.1.3嵌套觸發器
11.1.4遞歸觸發器
11.1.5觸發器的T-SQL限製
11.1.6帶觸發器的係統錶作用
11.2使用觸發器加強業務規則
11.3觸發器檢查
11.4存儲係統信息
11.5用觸發器維護引用完整性
11.6級聯刪除觸發器
11.7級聯更新觸發器
11.8小結
第12章 更新錶索引和統計信息
12.1索引性能和調整
12.1.1設計快速的索引
12.1.2分布頁麵和步進存儲數據
12.1.3使用索引密度代替步進值
12.1.4更新分布頁麵
12.2創建實用程序進行優化錶索引
12.3對最後的優化進行驗證
12.4自動運行任務
12.4.1自動執行存儲過程
12.4.2調度任務
12.5使用DBCC語句監控數據庫
12.5.1CHECKALLOC
12.5.2CHECKCATALOG
12.5.3CHECKDB
12.5.4CHECKFILEGROUP
12.5.5CHECKIDENT
12.5.6CHECKTABLE
12.5.7DBREPAIR
12.5.8DBREINDEX
12.5.9dllname
12.5.10INPUTBUFFER
12.5.11NEWALLOC
12.5.12OPENTRAN
12.5.13OUTPUTBUFFER
12.5.14PINTABLE
12.5.15PROCACHE
12.5.16ROWLOCK
12.5.17SHOWCONTIG
12.5.18SHOWSTATISTICS
12.5.19SHRINKDATABASE
12.5.20SHRINKFILE
12.5.21SQLPERF
12.5.22TEXTALL和TEXTALLOC
12.5.23TRACEOFF
12.5.24TRACEON
12.5.25TRACESTATUS
12.5.26UNPINTABLE
12.5.27UPDATEUSAGE
12.5.28USEROPTIONS
12.6小結
第13章 交叉製錶
13.1交叉製錶的描述
13.1.1交叉製錶的必要考慮
13.1.2安全性
13.1.3聚閤
13.1.4數據分組
13.1.5過程
13.2驗證對象的存在
13.2.1驗證參數
13.2.2驗證數據類型和聚閤操作
13.3檢查列的安全性
13.4産生列頭列錶
13.4.1創建colnames錶
13.4.2檢查列的計數值和長度並
加入行數據
13.5生成交叉錶報告
13.5.1創建和修改crosstable
13.5.2更新crosstable值
13.5.3完成任務
13.6小結
第二部分 SQLServer必要信息
第14章 編寫高效代碼
14.1簡潔、高效的代碼是好的代碼
14.1.1明確目標
14.1.2存儲過程的主要邏輯構件
14.1.3編寫存儲過程的步驟
14.1.4數據檢索的示例
14.1.5數據存儲的示例
14.1.6數據存檔的示例
14.1.7數據刪除的示例
14.1.8記錄處理的示例
14.1.9業務邏輯的示例
14.1.10優化方法
14.1.11怎樣增加可讀性
14.2存儲過程的模塊化
14.3小結
第15章 使用多層客戶/服務器結構
15.1理解客戶/服務器結構
15.1.1客戶/服務器模型
15.1.2客戶/服務器應用
15.1.3客戶/服務器係統
15.2客戶/服務器計算結構的發展
15.2.1基於主機的係統
15.2.2兩層客戶.服務器結構
15.2.3對等係統
15.2.4三層客戶/服務器
15.3Web瀏覽器、Web服務器和
客戶/服務器模型
15.3.1兩層Web結構
15.3.2三層Web結構
15.4Microsoft的三層服務模型
15.4.1用戶服務
15.4.2業務服務
15.4.3數據服務
15.5使用RAD開發工具的多層應用
15.5.1COM和Microsoft應用服務
15.5.2COM和商業應用程序服務
15.5.3RAD和工程生命周期
15.5.4設計和建模
15.5.5開發
15.5.6配置
15.6可擴展性和SQLServer
15.6.1平颱可擴展性
15.6.2增強型查詢處理
15.6.3動態行鎖
15.6.4高級復製
15.6.5移動計算支持
15.7小結
第16章 復製
16.1編程人員的復製概念
16.1.1復製語言
16.1.2事務
16.1.3復製如何工作
16.1.4復製局限性
16.1.5復製商業模型
16.2高級復製
16.2.1復製和SQL-DMO
16.2.2存儲過程
16.2.3閤並復製
16.2.4撥號連接上的復製
16.3小結
第三部分 數據轉換和集成
第17章 超越Access
17.1判斷從Access到SQLServer的
轉移需求
17.1.1對企業數據庫的要求
17.1.2Access與SQLServer的特性
對比
17.2實現從Access到SQLServer的轉移
17.2.1與VisualBasic、Access以及
SQLServer有關的問題
17.2.2使用DTSImport Wizard
17.3小結
第18章 對SybaseSQLServer進行轉換
18.1Sybase和Microsoft的發展曆程
18.2發展趨勢
18.3保留的相似之處
18.3.1係統過程
18.3.2MicrosoftT-SQL與SybaseT-SQL
的對比
18.4MicrosoftSQL7和SybaseAdaptive
Server的差彆
18.4.1兼容模式
18.4.2事務管理模式
18.4.3隔離等級
18.4.4保留字
18.4.5遊標語法
18.4.6迴滾觸發器
18.4.7優化程序暗示
18.4.8優化查詢計劃
18.4.9臨時錶名稱
18.4.10RAISERROR語句
18.4.11數據類型
18.4.12標識列
18.4.13PRINT語法
18.5小結
第19章 使用VisualC++優化ODBC
19.1ODBC體係結構
19.2數據庫概要
19.3為何使用ODBC
19.3.1統一連接
19.3.2建立技術
19.4ODBC的安全問題
19.5連接ODBC的方法
19.5.1安裝驅動程序
19.5.2使用數據源工作
19.6調用級接口
19.6.1基礎
19.6.2連接到數據庫
19.6.3語句:操作SQLServer數據
19.6.4提取數據
19.6.5遊標
19.6.6端到端 :調試ODBC代碼
19.6.7使用大數據項
19.7使用MicrosoftFoundationClasses
簡化ODBC
19.7.1對象模型
19.7.2非常簡單:使用記錄集和
ClassWizard
第20章 從VisualBasic連接SQLServer
20.1為SQLServer開發高效VisualBasic
應用程序
20.1.1三層應用模型:選擇一種實現
20.1.2調用級和對象接口:選擇一個
接口
20.2使用開放式數據庫連接
20.2.1SQLServer的開放式數據庫連接
驅動程序
20.2.2連接ODBC數據源
20.2.3執行SQL語句:處理查詢
20.2.4結果集
20.3數據訪問對象
20.3.1創建和調整數據庫:數據定義
語言操作
20.3.2使用記錄集:數據操縱語言
操作
20.4遠程數據對象
20.4.1RDO與DAO比較
20.4.2RDO層次和rdoEngine對象
20.4.3rdoEnvironment對象
20.4.4建立RDO連接
20.4.5遊標和結果集
20.4.6遞交查詢
20.4.7使用ODBC擴展RDO
20.5小結
第21章 通過VisualBasic使用SQL-DMO
管理SQLServer
21.1DMO概念
21.1.1它是什麼,它不是什麼
21.1.2從VisualBasic中訪問
SQL-DMO對象
21.2實現SQL-DMO對象
21.2.1創建SQL-DMO對象
21.2.2不可創建的對象
21.2.3集
21.2.4列錶對象
21.3使用SQL-DMO管理數據庫
21.4使用SQL-DMO管理服務器
21.5探索SQL-DMO對象模型
21.5.1SQL-DMO對象模型
21.5.2Application對象
21.5.3SQLServer對象
21.5.4Database對象
21.5.5Table對象
21.5.6JobServer對象
21.5.7Replication對象
21.6SQL-DMO的一般用途
21.6.1用戶管理示例
21.6.2文本文件導入/導齣示例
21.6.3遠程數據庫同步示例
21.7構造數據庫管理工具
21.8小結
第22章 SQLServer數據的自動Web
發布
22.1WebAssistant的構件
22.2使用WebAssistantWizard
22.3使用xp_makewebtask和
sp_makewebtask
22.4使用sp_makewebtask和
xp_makewebtask精化Web頁麵
22.4.1sp_makewebtask的必須和基本
的參數
22.4.2頁麵格式化參數
22.4.3鏈接相關的參數
22.4.4每頁行數參數
22.4.5模闆參數
22.5使用工作相關的參數自動Web發布
22.6小結
第23章 SQLServer、ADO和Web
23.1數據訪問的發展
23.2ADO對象模型
23.2.1ADO主要對象
23.2.2ADO輔助對象
23.3Connection對象
23.3.1事務管理
23.3.2事務考慮
23.3.3連接池
23.3.4執行SQL
23.4Command對象中使用存儲過程
23.5Recordset對象
23.5.1檢索整個錶
23.5.2Recordset基礎
23.5.3利用斷連記錄集
23.6RDS:將ADO移到瀏覽器
23.7小結
第24章 Microsoft的COM和DCOM
24.1DCOM的結構
24.1.1DCERPC和IDL
24.1.2分布對象
24.1.3DCOM的安全機製
24.2常見技術
24.2.1DCOM服務器
24.2.2配置
24.2.3可擴展性
24.2.4故障
24.2.5性能
24.3小結
第25章 未來是MicrosoftTransaction
Server的時代
25.1在Internet上應用三層結構
25.1.1客戶層
25.1.2 業務邏輯層
25.1.3數據層
25.2理解MTS
25.2.1ObjectControl_Activate
25.2.2ObjectControl_Deactivate
25.2.3ObjectControl_CanBePooled
25.3編寫MTS事務
25.4配置MTS構件
25.5無狀態環境的重要性
25.5.1狀態維持限製可擴展性
25.5.2使用Just-in-Time激活
25.6使用MTS最大化係統性能
25.6.1確定是否釋放或者中止
25.6.2為Webfarm提供無狀態性
第26章 其他開發平颱與SQL服務器
的連接
26.1Delphi的數據庫模型
26.2Delphi中的數據庫編程
26.2.1使用數據庫訪問控件
26.2.2數據控件
26.2.3在錶單中使用控件
26.2.4錶單嚮導
26.2.5通過代碼來訪問數據庫
26.2.6通過Delphi來管理數據庫
26.3PowerBuilder和Microsoft
SQLServer
26.3.1連接數據庫
26.3.2ODBC和底層驅動的比較
26.3.3連接數據庫
26.3.4使用PowerBuilder管理數據庫
26.3.5PowerBuilder數據庫對象
26.4Delphi和PowerBuilder 該用
哪個
第27章 將SQL與Microsoft的其他産品
集成
27.1將Access作為SOLServer7的前端
27.1.1創建Access項目
27.1.2使用Access項目
27.1.3使用DataAccessPage
27.1.4MicrosoftSQLServer的雙嚮
數據復製
27.2在SQLServer7中使用Excel
27.3在InternetInformationServer和Internet
Explorer中使用SQLServer
27.3.1在服務方訪問數據庫
27.3.2使用InternetExplorer進行客戶端
數據庫訪問
27.4與MicrosoftTransactionServer
集成
27.4.1MTS事務和IIS
27.4.2MTS事務和SQLServer
27.4.3MTS事務處理和可視化編程
工具
27.5小結
第28章 工作調度及使用ActiveXServer
實現業務解決方案
28.1使用SQLServerAgent
28.2實現工作
28.3T-SQL工作
28.4在VBScript中運行ActiveXServer
28.5綜述
28.6小結
第29章 業務解決方案的編程方針
29.1基礎結構
29.2源代碼管理
29.3數據庫需求
29.4設計和開發
29.4.1標準化
29.4.2主鍵
29.4.3Null約束
29.5編程中優化性能
29.5.1減少數據傳輸
29.5.2事務中不允許用戶輸入
29.5.3防止死鎖
29.5.4不要混淆OLTP和OLAP
29.5.5避免耗時較長的查詢
29.6測試數據庫應用
29.7修改第三方SQLServer應用
29.8小結
第30章 數據倉庫和在綫事務處理
30.1SQLServer作為數據倉庫
30.2實現數據倉庫
30.2.1確定需求
30.2.2設計和構造數據庫
30.3如何為倉庫清理數據
30.3.1使用數據遷移服務
30.3.2使用bcp載入數據
30.3.3使用存儲過程載人數據
30.3.4使用復製載人數據
30.3.5CUBE和ROLLUP操作
30.3.6批處理
30.4大型查詢和性能優化
30.4.1查詢數據
30.4.2視圖
30.4.3存儲過程
30.5倉庫維護任務
30.6SQLServer和OLTP係統
30.6.1OLTP問題
30.6.2創建數據庫
30.6.3索引數據庫
30.6.4事務
30.6.5鎖
30.6.6死鎖
30.7優化SQLServer作為OLTP係統
30.7.1事務核對清單
30.7.2配置選項
30.8監視性能
30.8.1內存和過程cache
30.8.2輸入/輸齣
30.8.3事務配置選項
30.9小結
第四部分 附 錄
附錄A Master數據庫的係統錶
附錄B 所有數據庫的係統錶
附錄C 常見錯誤信息
· · · · · · (收起)
讀後感
用戶評價
從技術哲學的角度來看,《SQL Server 7編程技術內幕》展現瞭一種與當下截然不同的**數據中心構建思維**。它充滿瞭對“本地化處理”的推崇——盡可能在服務器端完成所有的數據轉換、業務邏輯驗證和復雜的報告生成。書中對**T-SQL腳本的組織與版本控製**的探討,雖然沒有現代Git-based的DevOps流程,但其強調的“冪等性腳本編寫”和“預部署檢查列錶”,為我們後來構建CI/CD管道提供瞭早期的思想雛形。它不是一本關於“如何快速上綫”的書,而是一本關於“如何讓係統穩定運行五年”的書。例如,書中對於**觸發器(Triggers)的嵌套和級聯影響**的警告和應對策略,其嚴謹程度遠超很多入門級教程,它直指在沒有完善事務日誌迴溯工具時,如何通過代碼結構保證數據完整性的核心難題。這種對係統韌性的關注,讓我對那個時代係統工程師的責任感深感敬佩,也讓我反思,在追求敏捷性的今天,我們是否過度犧牲瞭這種對係統底層穩定性的敬畏之心。這本書更像是一份關於如何“建造一座能夠抵抗時間侵蝕的數據堡壘”的手冊,而非一個快速迭代的“應用開發指南”。
评分作為一個從Visual Basic 6.0時代過渡過來的開發者,我發現這本書在**ADO(ActiveX Data Objects)與SQL Server 7.0的集成應用**方麵,提供瞭極為實用的代碼範例。那些關於如何正確處理連接字符串中的Provider和CursorLocation,以及如何手動管理Recordset對象的滾動和更新機製的講解,簡直是我的救命稻草。很多初學者都會遇到的“參數化查詢陷阱”——比如如何正確傳遞日期時間類型避免歧義,書中通過大量具體的VB/VBA代碼片段進行瞭演示,而且重點說明瞭在SQL Server 7.0中,由於缺乏後期版本中更智能的類型推斷,手動指定`adType`的重要性。我記得我曾經因為一個日期字段的顯示問題睏擾瞭三天,最後在書中一個關於`dbbindcol`函數調用的例子中找到瞭答案——原來是數據類型定義不夠明確導緻的。雖然現在我們主要使用.NET框架下的SqlCommand和Entity Framework,但迴顧那段曆史,這本書讓我深刻理解瞭**數據訪問層抽象的演變過程**,即從直接操作COM對象到麵嚮對象的封裝,每一步的改進都是為瞭解決早期版本中那些繁瑣且易齣錯的手動內存和指針管理問題。
评分哎呀,這本《SQL Server 7編程技術內幕》真是讓我又愛又恨,愛的是它在那個年代幾乎是唯一的“內幕”揭示者,恨的是……嗯,現在的眼光來看,很多內容確實已經時過境遷瞭。我記得當年為瞭搞清楚那些晦澀的存儲過程優化技巧,我幾乎是把它當成武林秘籍一樣啃下來的。書中對**事務隔離級彆**的深入剖析,放到現在來看,依然具有很強的理論指導意義,尤其是它用當時SQL Server 7.0特有的**鎖粒度**機製來解釋並發控製的原理,那種手把手的推導過程,遠比現在那些雲裏霧裏、隻講API的教材要紮實得多。那時候沒有Stack Overflow這種便捷的資源,能有一本書把DBCC命令的底層邏輯講得這麼透徹,簡直是救星。不過,有一點必須提,關於**索引的物理結構描述**部分,內容雖然詳盡,但由於缺乏對新型B-Tree變體(比如LSM-Tree或者更復雜的列式存儲結構)的介紹,讀起來總感覺是在懷舊,缺少對未來架構的預判。我花瞭大量時間去對照書中的圖示和實際執行的Profiler跟蹤結果,試圖復現那些教科書式的“完美執行計劃”,那段摸索的過程,雖然辛苦,但確實奠定瞭我對SQL Server執行引擎的初步認知基礎。可以說,這本書是那個特定技術棧下,理解SQL Server 7.0“為什麼這麼乾”的最佳鑰匙,可惜的是,當你深入到現代版本時,你會發現鑰匙孔已經換瞭。
评分這本書的裝幀和排版,坦率地說,是那個時代技術書籍的典型風格——厚重、字密,圖錶相對簡陋,但內容密度極高。我印象最深的是關於**遠程存儲過程(RPC)和分布式事務(2PC)**那一章。當時我們公司剛開始嘗試在多個數據庫服務器間建立集成,配置過程充滿瞭各種權限和網絡問題的泥潭。這本書沒有停留在簡單的配置步驟說明上,而是詳細拆解瞭MSDTC(Microsoft Distributed Transaction Coordinator)在SQL Server 7環境下是如何實現兩階段提交的協議握手過程的。它甚至涉及到瞭如何通過修改注冊錶項來微調分布式事務的超時設置,這在官方文檔中是極其罕見的“野路子”。雖然我們最終因為性能原因放棄瞭大規模使用RPC,但正是通過這本書,我纔第一次意識到數據庫操作的“分布式一緻性”代價有多麼高昂。它沒有過多渲染現代雲架構的彈性,而是聚焦於那種堅實、老派的“要麼成功,要麼失敗”的強一緻性哲學。閱讀時,我常常需要準備另一本關於Windows NT係統管理的參考書來輔助理解,因為其中很多底層配置是與操作係統緊密耦閤的,這體現瞭那個時期數據庫軟件深度的係統依賴性。
评分這本書的另一大亮點,也是我個人認為它在今天依然有價值的部分,是對**SQL Server 7.0的內存管理架構**的描述。在沒有現代SQL Server Management Studio(SSMS)提供直觀的性能儀錶盤之前,理解內存是如何被分配給緩衝池(Buffer Pool)和過程緩存(Procedure Cache)的,是進行性能調優的關鍵。書中詳細解釋瞭SGA(System Global Area)的概念,以及SQL Server如何根據當時的硬件限製來動態調整內存池的比例。雖然我們現在麵對的是GB甚至TB級彆的內存,但書中關於**緩存失效策略**的討論非常值得細品。它描述瞭在資源受限時,係統會優先驅逐不常使用的執行計劃,而不是僅僅基於LRU(最近最少使用)算法來操作。這種對曆史查詢計劃的保留意圖,揭示瞭數據庫設計者在權衡CPU開銷和I/O成本時的早期哲學。通過這本書,我學會瞭如何觀察SQL Server的內部計數器,而不是盲目相信高層工具的提示,這種“鑽井取油”式的學習方法,對於任何想深入理解數據庫內核的人來說,都是一筆寶貴的財富。
评分 评分 评分 评分 评分相關圖書



本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有