
具体描述
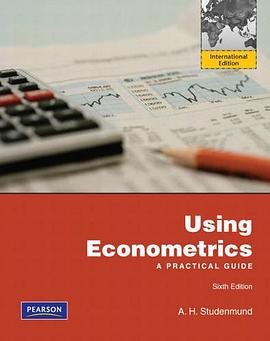
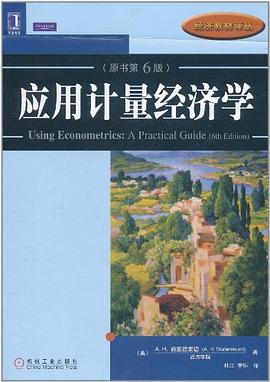
《应用计量经济学(第6版)》被誉为“近30年来最具重要性的创新性教材之一”,是美国高校教授基础计量经济学的首选教材!全书简单、直观且通俗易懂地讲解了各类计量模型的设定方法、用途以及模型的解释等,几乎没有涉及数学推导。更为难得的是,作者用生动的语言讲解了假设检验的思想及其局限,也系统化地讲解了计量实证研究的各个步骤及注意事项,对学生如何做好国际研究项目提供了很多有意义的帮助。另外,作者还给出了大量实用有趣的案例及其原始数据,比如iPod在eBay的价格,预测总统选举结果,宽松的打分对“评教”网站的影响。好莱坞夜总会的出席情况,病人如何选择医院,等等,让读者更容易理解计量经济学。
《应用计量经济学(第6版)》不仅仅是针对计量经济学的初学者,还针对那些使用回归分析提高解决问题能力的应用者,以及那些经验丰富的从业者,可以作为他们一本更为方便实用的参考书。
作者简介
目录信息
前言
教学建议
第1章 回归分析概论
1.1 什么是计量经济学
1.2 什么是回归分析
1.3 回归方程的估计
1.4 回归分析实例
1.5 应用回归分析解释住房价格
小结
第2章 普通最小二乘法
2.1 用普通最小二乘法估计单变量模型
2.2 用普通最小二乘法估计多元回归模型
2.3 评价回归方程的质量
2.4 估计模型的拟合优度
2.5 错用R2的例子
小结
第3章 应用回归分析
3.1 回归分析的步骤
3.2 回归分析实例:餐厅选址
小结
第4章 古典模型
4.1 古典假设
4.2 口的抽样分布
4.3 高斯-马尔科夫定理和普通最小二乘估计量的性质
4.4 标准计量经济学符号
小结
第5章 假设检验
5.1 什么是假设检验
5.2 t检验
5.3 t检验示例
5.4 t检验的局限
小结
附录5A F检验
第6章 模型设定:解释变量的选择
6.1 遗漏变量
6.2 不相干变量
6.3 误用模型设定准则的实例
6.4 设定搜索
6.5 选择解释变量的实例
小结
附录6A 其他设定准则
第7章 模型设定:函数形式的选择
7.1 常数项的应用和解释
7.2 备选函数形式
7.3 滞后解释变量
7.4 虚拟变量的应用
7.5 斜率虚拟变量
7.6 选择错误函数形式存在的
问题
小结
第8章 多重共线性
8.1 完全多重共线性与不完全多重共线性
8.2 多重共线性产生的后果
8.3 多重共线性的诊断
8.4 多重共线性的补救措施
8.5 最好不要修正多重共线性的实例
小结
附录8A SAT互动回归练习
第9章 序列相关性
9.1 纯序列相关和非纯序列相关
9.2 序列相关性的后果
9.3 杜宾一沃森检验
9.4 序列相关性的修正
小结
第10章 异方差性
10.1 纯异方差性和非纯异方差性
10.2 异方差性的后果
10.3 异方差性的检验
10.4 异方差性的补救措施
10.5 完整的实例
小结
第11章 回归课题研究
11.1 选择主题
11.2 收集数据
11.3 高级数据来源
11.4 对研究课题的实用性建议
11.5 撰写研究报告
11.6 回归分析的用户清单及应用指南
小结
附录11A 关于房价的互动练习
第12章 时间序列模型
12.1 动态模型
12.2 序列相关性和动态模型
12.3 Granger因果关系
12.4 谬误相关和非平稳性
小结
第13章 虚拟被解释变量模型估计方法
13.1 线性概率模型
13.2 二元Iogit模型
13.3 其他虚拟被解释变量模型估计方法
小结
第14章 联立方程模型
14.1 结构式方程和简约式方程
14.2 普通最小二乘法的偏误
14.3 二阶段最小二乘法
14.4 识别问题
小结
附录14A 变量误差
第15章 预测
15.1 什么是预测
15.2 比较复杂的预测
15.3 ARIMA模型
小结
第16章 实验和面板数据
16.1 经济学中的实验方法
16.2 面板数据
16.3 固定效应模型和随机效应模型
小结
第17章 统计学原理
17.1 概率分布
17.2 抽样
17.3 估计
小结
附录A 部分习题答案
附录B 统计表
· · · · · · (收起)
读后感
用户评价
**读者评价四:对模型假设的批判性思维训练** 这本书最让我受益匪浅的地方,在于它始终不厌其烦地提醒读者:所有模型都是对现实的简化,而模型的有效性完全依赖于我们对其假设的检验和理解。许多初级教材会把OLS回归描述得如同万能钥匙,但本书却花了大量的篇幅来讨论“如果违反了这些假设会怎样?”。例如,在讨论异方差性时,作者不仅介绍了White检验,更重要的是,他解释了在存在异方差的情况下,最小二乘估计量虽然仍然是无偏的,但其标准误的估计却是错误的,从而导致我们对显著性的判断出现偏差。这种对估计量性质的深刻剖析,培养了一种健康的怀疑精神。读完后,我不再仅仅满足于看到$R^2$值和P值,而是会下意识地去追问:残差是否正态?是否存在序列相关?这些问题不再是应试的负担,而是确保研究结论可靠性的必要步骤。这种对模型局限性的坦诚,使得这本书的论述显得尤为成熟和负责任,它教导的不是“如何做出一个看起来很棒的回归”,而是“如何做出一个站得住脚的实证分析”。
**读者评价五:从线性到非线性的平滑过渡与前沿视野** 这本书在内容的广度和深度上做到了一个极佳的平衡,尤其是在处理非线性模型方面,它的铺陈非常具有前瞻性。我们知道,现实世界中的许多经济现象是非线性的,比如概率选择模型、离散选择模型等。这本书非常有效地将读者从熟悉的线性回归框架中引导出来,去接触Logit和Probit模型。作者在处理这些非线性模型时,非常注重对边际效应的解释,这比单纯解释系数本身要重要得多,因为它直接关联到政策干预的实际效果。此外,我注意到书中对一些新兴研究热点也有所涉猎,比如对大数据背景下的高维模型(如LASSO等收缩估计)的简要介绍,虽然篇幅不长,但足以打开读者的视野,让他们明白计量经济学的研究仍在不断前行。这种将经典理论与现代方法有机结合的编排,使得这本书的生命力很强,它既能服务于基础学习者,也能为希望跟进前沿研究的进阶读者提供一个坚实的立足点和必要的知识储备。
**读者评价二:严谨的学术探讨与对因果推断的执着** 我阅读了许多关于经济学方法的书籍,但这本书在处理“因果关系”这一核心议题上展现出的那种近乎偏执的严谨性,令我印象深刻。很多入门级的读物往往满足于展示相关性,然后草草收场,但这本书显然不满足于此。作者在计量方法的选择上,明显倾向于那些能够更好地解决识别问题的工具,比如工具变量法(IV)以及更高级的面板数据模型中的固定效应和随机效应选择。我个人非常喜欢它对内生性问题的深度剖析,它不仅仅是提供了一个公式,而是像一位耐心的导师一样,一步步拆解为什么会出现内生性,以及在不同情境下(如遗漏变量偏差、测量误差)应该如何对症下药。书中的一些高级章节,比如关于断点回归设计(RDD)和倾向得分匹配(PSM)的讨论,几乎可以作为一篇独立的学术论文来参考,其对模型假设条件的讨论极为审慎和详尽。这使得本书不仅仅是一本工具书,更像是一本方法论的哲学著作,它强迫读者跳出“拟合数据”的表层需求,转而关注“我们是否真的找到了那个影响因素的真实效应”。对于研究生阶段的我来说,这种对方法论深度的要求,是衡量一本计量经济学著作是否优秀的关键标准。
**读者评价一:对数据挖掘与预测的深度探索** 这本书简直是为我这种对市场趋势和经济指标背后驱动力充满好奇的读者量身定制的。我一直觉得,光是掌握那些宏观的经济理论是不够的,真正让人兴奋的是如何用严谨的数学工具去捕捉和量化这些看似虚无缥缈的关系。这本书的结构安排得非常巧妙,它没有停留在教科书式的概念堆砌上,而是直接带你进入实战的迷宫。我特别欣赏作者在介绍时间序列分析时的那种渐进式引导,从最基础的平稳性检验到复杂的向量自回归模型(VAR),每一步都有清晰的理论铺垫和直观的案例佐证。特别是关于波动率建模的部分,作者用非常精炼的语言阐述了ARCH/GARCH族模型的精髓,这对于我理解金融市场的风险管理至关重要。我记得书中有一个关于消费者信心指数和未来支出的实证分析,它不仅仅是展示了模型的拟合优度,更重要的是,它引导读者思考在模型设定过程中需要克服的内生性、多重共线性等一系列“陷阱”。读完这部分,我感觉自己手中的不仅仅是理论知识,而是一把解剖经济现象的精密手术刀,能够更深入地洞察那些隐藏在数字背后的真实经济活动。这种将复杂理论与实际问题无缝对接的能力,是这本书最大的亮点,让我对“数据驱动决策”这句话有了更深刻的体悟。
**读者评价三:案例的丰富性与对现实世界问题的贴近度** 这本书的魅力在于,它成功地将枯燥的数学推导“拉回”到了我们日常能接触到的经济场景中。不同于那些只关注理论推导的学术专著,这本书的每一章似乎都紧密地扣合着当下的政策讨论或商业难题。我记得其中关于教育回报率的案例,它没有使用那种陈旧的、脱离实际的收入数据,而是巧妙地引入了不同教育阶段的公共政策变量作为外生冲击的代理变量,这让我看到了计量工具是如何被用来评估社会公平和人力资本投资效益的。再比如,关于环境规制对企业生产效率影响的分析,作者展示了如何运用双重差分(DID)模型来构造一个具有说服力的“反事实”比较组。这些案例的生动性,极大地降低了学习曲线的陡峭程度。每当我在学习一个新的估计方法时,我都会习惯性地翻到后面的案例部分,去看看这个方法在现实世界中究竟能解决什么样的问题,从而巩固对理论的理解。这种“理论先行,案例驱动,互相印证”的叙事节奏,让阅读过程充满了发现的乐趣,而非纯粹的知识灌输。
: F224.0/0262-1
: F224.0/0262-1
: F224.0/0262-1
: F224.0/0262-1
: F224.0/0262-1