

具体描述
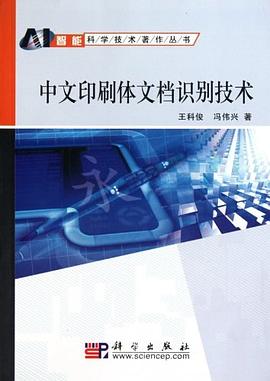
《中文印刷体文档识别技术(附光盘1张)》一书全面阐述了中文印刷体文档识别的原理、方法和系统组成,依据中文印刷体文档的特点,分别介绍了文档图像预处理、版面分析、汉字识别、公式的定位与提取、公式字符分割与识别、公式结构分析与表示、图表处理等内容的基本原理和技术实现方法,并提供了一个中文印刷体文档识别系统实例。
作者简介
目录信息
读后感
用户评价
我发现这本书的独特之处在于其对“鲁棒性”的执着追求,这在很多浮于表面的技术书籍中是难以见到的。作者似乎深知,任何识别系统在实验室环境下表现优异都是虚幻的,真正的考验来自于真实世界中的“脏数据”。因此,书中用了相当大的篇幅来讨论抗干扰策略,比如对渗透、污渍、折痕、甚至手写批注的鲁棒性处理。这里不仅仅涉及算法优化,还包含了对传感器输入端的考量,比如不同扫描仪和相机在采集文档时引入的系统性误差分析。特别是对多语言混合文档(中文与少量英文或符号混排)的处理,作者提出的多模态特征融合方案,巧妙地平衡了不同字符集的识别难度。此外,书中对性能评估指标的选取也十分审慎,它不只满足于最高的Top-1准确率,而是强调了误识别的代价分析(Cost Analysis),这对于决策者和项目管理者来说至关重要。这本书的整体基调是务实且深刻的,它提供的不只是“如何做”,更是“为什么这么做”以及“在什么情况下你会失败”,这才是真正有价值的知识沉淀。
评分坦白说,我对“技术文档”的容忍度一向不高,常常读上几页就容易陷入困境,但这本书记述的图像预处理章节,简直是为我这种“实践派”量身定做的。它没有停留在传统的二值化和去噪这些基础操作上,而是花了大量篇幅讨论了实际应用场景中,文档的扭曲矫正和背景噪声抑制的复杂性。比如,书中详细描绘了针对发黄纸张边缘光照不均导致的灰度漂移问题,提出了几种基于局部自适应阈值的优化方案,并且配上了清晰的流程图,让我立刻就能在脑海中构建出程序模块的框架。更让我惊喜的是,它对“版面分析”这一关键环节的阐述。作者并没有采用那种“一刀切”的分类方法,而是巧妙地引入了基于图论的连通域分析,用以区分文本块、图表和页眉页脚,这种处理思路的精妙之处在于其强大的泛化能力,能够适应版式布局差异巨大的古籍和现代表格文件。我对那种将复杂问题拆解成一系列可执行、可验证的小步骤的写作风格深感佩服,读完这一部分,我感觉自己对如何处理一张“脏乱差”的扫描件心里有底多了,这远超了我对一本理论书籍的预期。
评分这本书的学术严谨性与跨学科视野的结合,是其最值得称道之处。在谈及标准化的重要性时,作者没有将焦点局限于技术指标,而是将视角拉高到国家信息安全和文化遗产保护层面。书中引用的多项国际和国内标准(如GB/T系列文档处理标准),并对其在实际应用中的兼容性和局限性进行了批判性分析。此外,它还非常敏锐地触及了“语义理解”与“表层识别”之间的鸿沟。识别出字符只是第一步,如何将识别出的文本结构化并转化为可查询、可分析的数据,是文档智能化的终极目标。书中对表格结构识别(Table Structure Recognition)的复杂性进行了深入的剖析,探讨了基于几何关系和语义上下文的混合模型如何更有效地提取非结构化数据中的核心信息。这种从物理形态到逻辑结构的层层深入,让读者领悟到,文档识别不仅仅是图像处理,更是一种复杂的知识工程。阅读过程中,我时常停下来思考,作者对未来文档解析技术发展趋势的预测,无疑为我们描绘了一个更加智能、更具上下文感知的文档处理蓝图。
评分这部作品的深度,主要体现在它对深度学习时代来临前后,特征工程范式的根本性转变的探讨上。作者并没有盲目追捧最新的神经网络模型,而是非常理性地分析了传统机器学习方法(如SVM、Adaboost在特征选择上的应用)的局限性,特别是它们在面对海量、多样化印刷字体时的泛化能力瓶颈。随后,笔锋一转,深入剖析了卷积神经网络(CNN)如何通过自动学习层次化特征,彻底颠覆了字符识别的范式。书中对于特定网络结构(如ResNet或Inception在识别任务上的微调)的选择标准,以及如何设计损失函数来平衡识别精度与计算效率,阐述得极为透彻。我尤其对其中关于“小样本学习”的讨论印象深刻,在中文印刷体识别中,稀有字、异体字的学习样本往往不足,作者提出的迁移学习和数据增强策略,为解决实际生产环境中的“冷启动”问题提供了极具参考价值的思路。这不是一本停留在理论介绍的书,它更像是一份详尽的“工程实践备忘录”,指导读者如何将尖端的AI技术落地到具体的文档处理流程中去。
评分这本《中文印刷体文档识别技术》的封面设计简洁大方,那种略带复古的墨绿色调,让人联想到老旧的档案和珍贵的文献,第一眼就给人一种专业而厚重的印象。我本来以为这会是一本纯粹的技术手册,充满了晦涩难懂的算法描述和枯燥的代码片段,但翻开之后才发现,作者的叙述方式非常注重从宏观背景切入,探讨了数字化浪潮下,传统印刷体文档保存与信息提取的迫切性。书中对历史上的中文信息处理瓶颈做了深入剖析,比如早期的OCR(光学字符识别)系统在处理不同年代、不同油墨质量的印刷品时遇到的系统性偏差,这些内容读起来非常引人入胜,简直就像在看一部技术发展史的纪录片。特别是对不同字体风格(宋体、黑体、楷书等)在不同分辨率下的特征提取差异,作者没有简单地罗列公式,而是通过大量的案例对比,阐释了特征工程在早期识别框架中的核心地位。这种从“为什么需要这项技术”到“如何实现这项技术”的递进结构,使得即使是对底层算法不甚精通的读者,也能建立起对整个识别流程的清晰认知。我特别欣赏作者在阐述核心识别模块时,穿插的历史典故和行业发展趣闻,让原本冰冷的技术描述变得生动起来,极大地提高了阅读的连贯性和趣味性。
评分 评分 评分 评分 评分相关图书







本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈图书下载中心 版权所有