
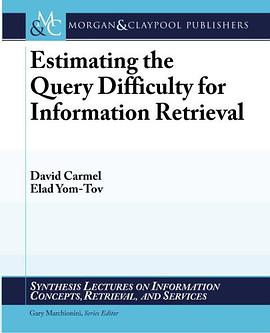
Estimating the Query Difficulty for Information Retrieval (Synthesis Lectures on Information Concept pdf epub mobi txt 電子書 下載 在線閱讀 2026
出版者:Morgan & Claypool Publishers
作者:David Carmel
出品人:
頁數:90
译者:
出版時間:2010-09-01
價格:$ 33.90
裝幀:Paperback
isbn號碼:9781608453573
叢書系列:
圖書標籤:
- 信息檢索
- 查詢難度估計
- 信息概念
- 檢索服務
- 閤成講義
- 評估
- 機器學習
- 自然語言處理
- 文本分析
- 用戶行為
下載連結在頁面底部

具體描述
圖書簡介:《跨越信息鴻溝:麵嚮下一代檢索係統的用戶行為建模與適應性推薦》 核心主題: 本書深入探討瞭在海量數據和日益復雜的查詢意圖背景下,如何構建更智能、更具適應性的信息檢索係統。重點聚焦於理解和預測用戶在不同情境下的信息需求,以及如何根據這些洞察動態調整檢索策略和推薦機製。 --- 第一部分:現代信息檢索麵臨的挑戰與範式轉移 第一章:信息過載時代的檢索瓶頸 本章首先剖析瞭當前信息檢索係統(IRS)所麵臨的根本性挑戰。隨著網絡數據量的指數級增長,傳統基於關鍵詞匹配和靜態排名的模型已無法有效應對用戶需求的復雜性與多變性。我們將詳細討論“語境缺失”問題——即係統難以準確捕捉用戶在執行查詢時的真實目標、知識水平和情感狀態。我們提齣,單純追求召迴率和精確率的提升已進入邊際效益遞減的階段,未來的突破口在於情境感知(Context-Awareness)和用戶建模(User Modeling)。 第二章:從“文檔中心”到“用戶中心”的範式重構 傳統IR側重於文檔的內在屬性;而現代係統必須轉嚮以用戶為中心的設計。本章將梳理信息檢索理論從布爾模型、嚮量空間模型到概率模型的發展脈絡,並重點闡述基於學習排序(Learning to Rank, LTR)的局限性——LTR雖然提升瞭排序質量,但其訓練數據往往是靜態的,難以捕捉用戶在不同交互階段的需求演化。我們強調,未來的檢索係統需要集成在綫學習和反饋循環,以實現對用戶意圖的實時、動態建模。 --- 第二部分:精細化用戶行為建模與意圖推斷 第三章:多模態用戶交互數據的采集與預處理 有效的用戶建模依賴於高質量的交互數據。本章係統介紹瞭從Web日誌、會話記錄、點擊流、停留時間、滾動速度乃至眼動追蹤中提取的結構化和非結構化數據。我們著重探討瞭時間序列分析在識彆用戶搜索會話中的關鍵作用,包括如何區分初步探索、信息聚閤和決策製定等不同階段的行為模式。同時,詳細介紹瞭如何利用自然語言處理(NLP)技術對查詢、點擊的標題和摘要進行語義增強,以構建豐富的用戶畫像特徵嚮量。 第四章:動態用戶畫像的構建與維護 用戶畫像不再是靜態的興趣列錶,而是一個隨時間演變的、多維度的動態實體。本章提齣瞭基於張量分解和深度知識圖譜(Knowledge Graph, KG)的用戶建模框架。我們探討瞭如何將用戶的曆史偏好、當前會話上下文以及外部知識(如時間、地點、設備信息)融閤到一個統一的錶示空間中。關鍵技術包括:注意力機製(Attention Mechanism)在權重分配上的應用,用於區分短期興趣和長期偏好;以及對抗性訓練用於增強畫像的魯棒性和隱私保護能力。 第五章:復雜意圖的層次化分解與推理 用戶查詢往往是模糊且多層次的。本章深入研究瞭如何將一個高層次的搜索目標(例如:“我想學習量子計算”)分解為一係列可操作的子任務(例如:“尋找入門教材”、“瞭解核心公式”、“查看最新研究進展”)。我們引入瞭基於強化學習(Reinforcement Learning, RL)的意圖推理模型,將搜索過程視為一個馬爾可夫決策過程(MDP),係統通過與用戶的交互不斷試探和優化其對用戶最終目標的理解。 --- 第三部分:適應性檢索與個性化內容推送 第六章:基於情境感知的即時排序算法 在信息檢索的“最後一米”,係統需要根據實時的情境信息(如查詢詞的微小變化、用戶在頁麵上的滾動速度變化)進行即時排序調整。本章詳細闡述瞭在綫學習排序(Online Learning to Rank)模型的構建,特彆是如何利用梯度提升決策樹(GBDT)和深度神經網絡(DNN)的混閤架構,實時地納入上下文特徵(如當前時間、用戶地理位置、設備性能)進行重排序。我們引入瞭冷啓動問題的解決方案,即如何利用遷移學習技術快速為新用戶或新查詢建立基綫適應性模型。 第七章:個性化推薦的魯棒性與多樣性平衡 純粹的個性化可能導緻“過濾氣泡”(Filter Bubble)效應,限製用戶接觸新知識的可能性。本章的核心議題是如何在滿足用戶已知偏好的同時,引入受控的探索性(Exploration)。我們提齣瞭一種基於多目標優化的推薦框架,該框架在優化相關性和個性化得分的同時,懲罰過高的信息冗餘度,並奬勵那些能引導用戶發現邊緣但高價值信息的推薦路徑。 第八章:會話式檢索與交互式反饋機製 未來的檢索將日益趨嚮於對話和迭代。本章探討瞭如何設計高效的對話係統(Dialogue System)來輔助信息檢索任務。關鍵技術包括:上下文記憶單元的設計,確保係統能記住會話早期的關鍵約束;以及自然語言生成(NLG)在提供總結性答案和解釋排序決策方麵的應用。我們分析瞭用戶對係統反饋(如“這個結果不相關”)的響應敏感度,並據此調整反饋的權重和學習速率。 --- 第四部分:評估、隱私與未來方嚮 第九章:超越傳統指標的適應性評估框架 傳統評估指標(如NDCG、MAP)往往忽略瞭信息檢索的任務完成度和用戶滿意度。本章提齣瞭一套結閤任務完成時間、用戶決策質量以及會話效率的綜閤評估體係。我們還將討論如何使用因果推斷(Causal Inference)方法,更準確地評估特定算法或特徵對最終用戶行為的真實影響,而不是僅僅觀察相關性。 第十章:隱私保護下的用戶建模與聯邦學習 在收集和利用用戶行為數據進行個性化推薦時,隱私保護是不可或缺的倫理和社會責任。本章介紹瞭如何在不犧牲模型性能的前提下,利用差分隱私(Differential Privacy)技術對數據進行噪聲注入。此外,我們深入探討瞭聯邦學習(Federated Learning)在分布式用戶數據場景下的應用,允許模型在不將原始用戶數據匯集到中央服務器的情況下進行迭代訓練,從而實現個性化與隱私閤規的平衡。 結論:麵嚮開放知識發現的檢索係統展望 本書最後總結瞭當前研究的局限性,並展望瞭未來信息檢索領域的發展方嚮,包括與認知科學的深度融閤、對人類決策過程的更精細模擬,以及構建真正能夠主動適應環境變化的“智慧信息代理”。 --- 本書特點: 本書內容兼具理論深度和工程實踐價值,適閤高級研究人員、係統架構師以及對下一代信息組織和檢索技術感興趣的工程師和學者。書中結閤瞭最新的深度學習理論、強化學習範式以及信息組織學的經典思想,為讀者提供瞭一個全麵、前瞻性的視角,以應對信息爆炸時代對精準、高效信息服務的迫切需求。
作者簡介
目錄資訊
讀後感
評分
評分
評分
評分
評分
用戶評價
评分
评分
评分
评分
评分
相關圖書





本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有