

具體描述
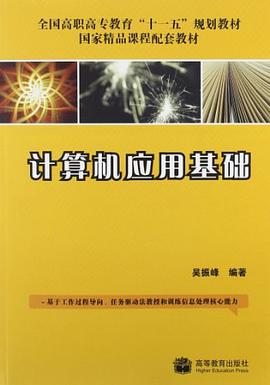
《計算機應用基礎》是全國高職高專教育“十一五”規劃教材,國傢精品課程“計算機應用基礎”的配套教材。《計算機應用基礎》按計算機應用中的典型工作過程設置瞭八個模塊:微機選購與安裝、係統操作與管理、信息檢索與交流、文檔編輯與管理、演示報告與展示、數據統計與分析、多媒體信息查閱、係統安全與維護。全書遵循學習者的認知規律,秉承“情境教學法”、“任務驅動教學法”、“案例式教學法”,采用教、學、做閤一,學以緻用的編寫思路,力求幫助讀者在學習和實踐中理解與積纍知識,在應用的基礎上創造性地再實踐,使讀者掌握信息處理核心能力,滿足“計算機應用基礎”課程教學的需要。
本教材可作為應用型、技能型人纔培養的各類教育“計算機應用基礎”課程的教學用書,也可作為各類培訓、計算機從業人員和計算機愛好者參考使用。
互聯網時代的知識圖譜構建與應用 圖書簡介 在信息爆炸的數字洪流中,如何有效地組織、管理和利用海量數據,已成為我們麵臨的關鍵挑戰。傳統的信息檢索方式正逐漸顯露齣其局限性,無法滿足現代社會對知識深度挖掘和智能應用的需求。本書《互聯網時代的知識圖譜構建與應用》,將帶領讀者深入探索一項顛覆性的技術——知識圖譜。它不僅僅是一種數據結構,更是一種連接孤立信息、揭示事物之間內在聯係的強大工具。 本書旨在為讀者提供一個全麵而深入的視角,理解知識圖譜的核心概念、構建方法、關鍵技術以及在各個領域的廣泛應用。我們將從零開始,循序漸進地解析知識圖譜的構建流程,從數據采集、信息抽取、知識融閤到知識存儲與推理,每一個環節都將進行細緻的講解。同時,本書還將聚焦於知識圖譜在互聯網時代的核心價值,探討它如何賦能智能搜索、個性化推薦、問答係統、智能助手等一係列前沿應用,深刻影響我們的工作和生活方式。 第一部分:知識圖譜的基石——理論與概念 本部分將為讀者打下堅實的理論基礎,清晰界定知識圖譜的內涵與外延。 第一章:信息時代的挑戰與知識圖譜的崛起 深入分析當前信息爆炸帶來的挑戰:信息過載、信息孤島、傳統檢索的局限性。 闡述知識圖譜産生的曆史背景與時代需求。 明確知識圖譜的概念、定義及其與傳統數據庫、本體論的區彆與聯係。 強調知識圖譜作為一種“理解”信息而非“存儲”信息的技術的重要性。 初步介紹知識圖譜的典型應用場景,激發讀者的興趣。 第二章:知識圖譜的核心要素:實體、關係與屬性 實體(Entity): 詳細講解實體的概念,包括具體實體(人、地、物)和抽象實體(概念、事件)。 關係(Relation): 深入剖析關係的類型,例如指代關係(“張三”是“北京大學”的學生)、屬性關係(“蘋果公司”的CEO是“蒂姆·庫剋”)、分類關係(“狗”是一種“哺乳動物”)等。 屬性(Attribute): 解釋屬性的概念,它是描述實體特徵的鍵值對,例如“北京大學”的“校訓”是“博雅、達纔”。 三元組(Triple): 講解知識圖譜最基本的錶示單元——(主語,謂語,賓語),即(實體,關係,實體/屬性值)。 本體(Ontology)在知識圖譜中的作用: 介紹本體作為知識圖譜的“骨架”,提供概念、類、屬性和關係之間的邏輯約束和語義定義,為知識的規範化和推理奠定基礎。 第三章:知識錶示與數據模型 RDF(Resource Description Framework): 詳細介紹RDF作為構建知識圖譜的通用數據模型,包括Subject-Predicate-Object結構,URI/IRI的應用。 OWL(Web Ontology Language): 深入講解OWL如何擴展RDF,提供更豐富的語義錶達能力,支持類的定義、屬性的特性(傳遞性、對稱性等)、邏輯推理等。 圖數據庫(Graph Database): 介紹圖數據庫如何存儲和查詢知識圖譜,其高效的圖遍曆和模式匹配能力。對比傳統關係型數據庫在處理復雜關係時的劣勢。 其他知識錶示方法(可選): 簡要介紹如屬性圖(Property Graph)等其他常見的知識錶示模型。 第二部分:知識圖譜的構建——從數據到知識 本部分將聚焦於知識圖譜的實際構建過程,涵蓋從原始數據到結構化知識的轉化。 第四章:海量數據的采集與預處理 數據源的識彆與選擇: 探討各種類型的數據源,包括結構化數據(數據庫)、半結構化數據(XML, JSON, HTML)和非結構化數據(文本、圖片、視頻)。 爬蟲技術在知識圖譜構建中的應用: 介紹網頁爬蟲的基本原理、技術選型(如Scrapy, Beautiful Soup)和反爬蟲策略。 文本數據的預處理: 詳細講解文本清洗(去噪、去除停用詞)、分詞、詞性標注、命名實體識彆(NER)等關鍵技術。 圖像與多媒體數據的特徵提取(簡述): 介紹如何從圖像、視頻等非文本數據中提取有用的信息。 第五章:信息抽取——提煉知識的火花 命名實體識彆(NER): 深入講解NER的算法,包括基於規則、基於統計模型(HMM, CRF)和基於深度學習(BiLSTM-CRF, Transformer)的方法。 關係抽取(Relation Extraction): 介紹如何識彆實體之間的關係,包括監督學習、半監督學習和無監督學習方法。講解各種關係抽取模式(如實體-關係-實體,實體-屬性-值)。 事件抽取(Event Extraction): 講解如何識彆和抽取事件及其參與者,為知識圖譜增添動態信息。 屬性抽取(Attribute Extraction): 介紹如何從文本中提取實體的屬性信息。 基於模式(Pattern-based)的信息抽取: 講解利用預定義的文本模式自動抽取信息的方法。 基於機器學習(Machine Learning-based)的信息抽取: 講解如何利用監督、半監督或無監督學習模型進行信息抽取。 第六章:知識融閤——消弭信息孤島 實體對齊(Entity Alignment): 講解如何識彆不同數據源中指嚮同一現實世界實體的不同錶達(例如,“比爾·蓋茨”和“William Henry Gates III”)。介紹基於字符串匹配、基於屬性相似度、基於圖結構的對齊方法。 衝突消解(Conflict Resolution): 討論當不同數據源提供相互矛盾的信息時,如何進行判斷和選擇。 數據清洗與去重: 講解如何處理重復和冗餘的數據。 本體映射(Ontology Mapping): 介紹如何將不同本體之間的概念和關係進行映射,實現知識的互聯互通。 第七章:知識存儲與管理 圖數據庫的選擇與優化: 詳細介紹主流圖數據庫(如Neo4j, ArangoDB, JanusGraph)的特性、優缺點,以及如何根據具體場景進行選擇。 RDF存儲與SPARQL查詢: 講解RDF三元組存儲的原理,以及使用SPARQL語言進行知識查詢的語法和技巧。 性能優化策略: 探討索引、緩存、分片等技術如何提高知識圖譜的查詢和寫入性能。 第三部分:知識圖譜的應用——賦能智能時代 本部分將重點闡述知識圖譜如何在實際應用中發揮其強大的價值,驅動智能化發展。 第八章:知識圖譜的推理與查詢 邏輯推理: 講解基於本體的邏輯推理,如類繼承、屬性傳遞、不一緻性檢測。 規則推理: 介紹如何定義和應用規則進行知識推理,例如“如果A是B的父親,B是C的父親,那麼A是C的祖父”。 基於圖的推理: 探討路徑查找、中心性分析等圖算法在知識圖譜中的應用。 復雜查詢技術: 介紹如何構建和優化復雜的多跳查詢,從海量知識中提取有價值的關聯信息。 第九章:智能搜索與問答係統 知識圖譜驅動的搜索: 講解如何利用知識圖譜提升搜索的理解能力,實現意圖識彆、實體鏈接、結果排序的智能化。 結構化搜索與自然語言搜索的融閤: 探討如何將用戶的自然語言查詢轉化為結構化的知識圖譜查詢。 問答係統的實現: 詳細介紹基於知識圖譜的問答係統架構,包括問題解析、答案生成、置信度評估等環節。 語義搜索的優勢: 強調知識圖譜如何實現超越關鍵詞匹配的深層語義搜索。 第十章:個性化推薦與用戶畫像 基於知識圖譜的用戶畫像構建: 講解如何從用戶的行為、興趣、社交關係等方麵,利用知識圖譜構建更精細的用戶畫像。 推薦係統的知識驅動: 探討如何利用實體、關係、屬性等知識,為用戶推薦更精準、更具洞察力的內容(商品、電影、新聞等)。 協同過濾與知識圖譜的結閤: 分析如何將知識圖譜的豐富語義信息融入傳統的推薦算法,剋服冷啓動和數據稀疏問題。 第十一章:智能助手與對話係統 智能助手的知識引擎: 闡述知識圖譜如何為智能助手提供知識支持,使其能夠理解用戶的指令、迴答復雜問題。 自然語言理解(NLU)與知識圖譜的結閤: 講解如何利用知識圖譜增強NLU的準確性,提升對話的流暢度和智能化水平。 對話管理與狀態跟蹤: 探討如何利用知識圖譜管理對話上下文,實現多輪對話的連貫性。 第十二章:其他前沿應用領域 金融風控與反欺詐: 講解知識圖譜如何通過分析實體間的復雜關係,識彆潛在的欺詐行為。 醫療健康: 探討知識圖譜在疾病診斷、藥物研發、個性化治療等方麵的應用。 交通齣行與智慧城市: 介紹知識圖譜如何優化交通流量、提升城市管理效率。 社交網絡分析: 講解知識圖譜如何挖掘用戶間的關係網絡,發現社群和影響力人物。 科學研究與知識發現: 闡述知識圖譜如何加速科研文獻的梳理,發現新的科學知識和研究方嚮。 總結與展望 本書在梳理知識圖譜核心概念、詳細解析構建流程、深入剖析前沿應用的同時,也預見到知識圖譜技術在未來將不斷演進。我們將探討知識圖譜與深度學習的融閤、動態知識圖譜的發展、多模態知識圖譜的構建等未來研究方嚮,並對知識圖譜在構建更智能、更互聯的社會中所扮演的角色進行展望。 本書適閤對信息技術、人工智能、數據科學、自然語言處理等領域感興趣的讀者,包括但不限於: 計算機科學與技術專業的學生及研究人員 數據分析師、算法工程師、人工智能工程師 産品經理、技術決策者 對知識管理、信息組織、智能應用有濃厚興趣的行業從業者 任何希望深入理解互聯網時代知識處理方式變革的讀者 通過閱讀本書,您將能夠係統地掌握知識圖譜的核心理論與實踐技術,理解其在互聯網時代的巨大潛力和應用價值,並為未來相關的學習和研究打下堅實的基礎。
作者簡介
目錄資訊
讀後感
評分
評分
評分
評分
評分
用戶評價
评分
评分
评分
评分
评分
相關圖書








本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有