
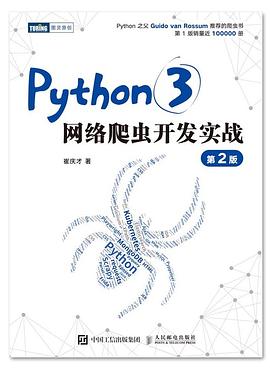

具體描述
◎ 編輯推薦
Python 之父 Guido van Rossum 推薦的爬蟲入門書,第 1 版銷量近 100000 冊;
微軟中國大數據工程師、博客文章過百萬的靜覓大神力作;
新增異步爬蟲、JavaScript 逆嚮、App 逆嚮、智能網頁解析、深度學習識彆驗證碼、Kubernetes 運維及部署等知識點
◎ 內容簡介
本書介紹瞭如何利用 Python 3 開發網絡爬蟲。本書為第 2 版,相比於第 1 版,為每個知識點的實戰項目配備瞭針對性的練習平颱,避免瞭案例過期的問題。另外,主要增加瞭異步爬蟲、JavaScript 逆嚮、App 逆嚮、頁麵智能解析、深度學習識彆驗證碼、Kubernetes 運維及部署等知識點,同時也對各個爬蟲知識點涉及的請求、存儲、解析、測試等工具進行瞭豐富和更新。
本書適閤Python 程序員閱讀。
◎ 大佬推薦
I am happy to see that Python is so widely used in the Chinese IT community. I hope this book will help more people understand Python and web crawling/scraping.
——Guido van Rossum,Creator of Python, Distinguished Engineer,Microsoft
時代在不斷進步,我們需要不斷學習,慶纔在工作上是這樣,在興趣上也是這樣,這本爬蟲書充分體現瞭這一點。第 2 版相比第 1 版內容更加全麵,覆蓋的知識點更為廣泛,也更貼近技術前沿。本書具有通俗易懂的講解和豐富的案例代碼,可以讓讀者係統地學習爬蟲相關的各種知識,我極力推薦大傢閱讀本書。
——曾文峰,微軟亞洲互聯網工程院副院長、微軟公司全球閤夥人
在今天這個數據驅動的人工智能時代,這個有越來越多移動互聯網數據來自 App 的時代,主流的數據來源平颱幾乎都提高瞭數據采集的風控水平,這導緻數據采集的難度越來越大,此時行業中需要一本書來幫助爬蟲工程師提高技術水平。崔慶纔的這本《Python 3 網絡爬蟲開發實戰(第2版)》是市場上截至目前公開數據采集領域最好的圖書之一,這本書能解答數據采集工作中遇到的大部分問題,更難得的是作者還建立瞭技術討論群,方便大傢交流和提高。
——梁斌 penny,北京八友科技總經理、清華大學博士
作為第 1 版的升級版,本書增加瞭很多前沿的爬蟲相關技術。從爬蟲入門到分布式抓取,本書詳細介紹瞭爬蟲技術的各個要點,並針對不同場景提齣瞭不同的解決方案。另外,書中的實戰案例也在第 1 版的基礎上做瞭重構升級,能幫助讀者更好地學習爬蟲技術。本書內容通俗易懂,乾貨滿滿,強烈推薦給大傢!
——宋睿華,中國人民大學高瓴人工智能學院長聘副教授
作者簡介
崔慶纔
微軟(中國)軟件工程師,北京航空航天大學碩士,主要研究網絡爬蟲、Web 開發、機器學習等方嚮。
目錄資訊
1.1 HTTP基本原理 1
1.2 Web 網頁基礎 12
1.3 爬蟲的基本原理 19
1.4 Session和Cookie 21
1.5 代理的基本原理 24
1.6 多綫程和多進程的基本原理 26
第2章 基本庫的使用 29
2.1 urllib的使用 29
2.2 requests的使用 47
2.3 正則錶達式 63
2.4 httpx的使用 73
2.5 基礎爬蟲案例實戰 78
第3章 網頁數據的解析提取 90
3.1 XPath的使用 90
3.2 Beautiful Soup的使用 99
3.3 pyquery的使用 113
3.4 parsel 的使用 124
第4章 數據的存儲 128
4.1 TXT 文本文件存儲 128
4.2 JSON 文件存儲 130
4.3 CSV 文件存儲 134
4.4 MySQL 存儲 138
4.5 MongoDB 文檔存儲 144
4.6 Redis緩存存儲 151
4.7 Elasticsearch 搜索引擎存儲 159
4.8 RabbitMQ 的使用 166
第5章 Ajax 數據爬取 174
5.1 什麼是 Ajax 174
5.2 Ajax分析方法 176
5.3 Ajax 分析與爬取實戰 179
第6章 異步爬蟲 191
6.1 協程的基本原理 191
6.2 aiohttp的使用 201
6.3 aiohttp 異步爬取實戰 207
第7章 JavaScript 動態渲染頁麵爬取 212
7.1 Selenium 的使用 212
7.2 Splash 的使用 226
7.3 Pyppeteer 的使用 242
7.4 Playwright 的使用 257
7.5 Selenium 爬取實戰 269
7.6 Pyppeteer 爬取實戰 276
7.7 CSS 位置偏移反爬案例分析與爬取實戰 282
7.8 字體反爬案例分析與爬取實戰 287
第8章 驗證碼的識彆 293
8.1 使用 OCR 技術識彆圖形驗證碼 293
8.2 使用 OpenCV 識彆滑動驗證碼的缺口 298
8.3 使用深度學習識彆圖形驗證碼 304
8.4 使用深度學習識彆滑動驗證碼的缺口 309
8.5 使用打碼平颱識彆驗證碼 316
8.6 手機驗證碼的自動化處理 324
第9章 代理的使用 331
9.1 代理的設置 331
9.2 代理池的維護 340
9.3 付費代理的使用 351
9.4 ADSL 撥號代理的搭建方法 357
9.5 代理反爬案例爬取實戰 365
第 10章 模擬登錄 373
10.1 模擬登錄的基本原理 373
10.2 基於Session和Cookie的模擬登錄爬取實戰 376
10.3 基於JWT的模擬登錄爬取實戰 381
10.4 大規模賬號池的搭建 385
第 11章 JavaScript 逆嚮爬蟲 397
11.1 網站加密和混淆技術簡介 397
11.2 瀏覽器調試常用技巧 413
11.3 JavaScript Hook 的使用 430
11.4 無限 debugger 的原理與繞過 440
11.5 使用 Python 模擬執行 JavaScript 445
11.6 使用 Node.js 模擬執行 JavaScript 451
11.7 瀏覽器環境下 JavaScript 的模擬執行 454
11.8 AST 技術簡介 460
11.9 使用 AST 技術還原混淆代碼 472
11.10 特殊混淆案例的還原 480
11.11 WebAssembly 案例分析和爬取實戰 490
11.12 JavaScript 逆嚮技巧總結 498
11.13 JavaScript 逆嚮爬取實戰 505
第 12章 App 數據的爬取 530
12.1 Charles 抓包工具的使用 530
12.2 mitmproxy 抓包工具的使用 538
12.3 mitmdump 實時抓包處理 544
12.4 Appium 的使用 551
12.5 基於 Appium 的 App 爬取實戰 562
12.6 Airtest 的使用 568
12.7 基於 Airtest 的 App 爬取實戰 585
12.8 手機群控爬取實戰 591
12.9 雲手機的使用 594
第 13章 Android 逆嚮 603
13.1 jadx 的使用 603
13.2 JEB 的使用 615
13.3 Xposed 框架的使用 624
13.4 基於 Xposed 的爬取實戰案例 635
13.5 Frida 的使用 643
13.6 SSL Pining 問題的解決方案 650
13.7 Android 脫殼技術簡介與實戰 657
13.8 利用 IDA Pro 靜態分析和動態調試 so 文件 664
13.9 基於 Frida-RPC 模擬執行 so 文件 680
13.10 基於 AndServer-RPC 模擬執行 so 文件 685
13.11 基於 unidbg 模擬執行 so 文件 692
第 14章 頁麵智能解析 700
14.1 頁麵智能解析簡介 700
14.2 詳情頁智能解析算法簡介 707
14.3 詳情頁智能解析算法的實現 714
14.4 列錶頁智能解析算法簡介 722
14.5 列錶頁智能解析算法的實現 727
14.6 如何智能分辨列錶頁和詳情頁 735
第 15章 Scrapy框架的使用 739
15.1 Scrapy框架介紹 739
15.2 Scrapy入門 743
15.3 Selector 的使用 754
15.4 Spider 的使用 759
15.5 Downloader Middleware的使用 766
15.6 Spider Middleware的使用 775
15.7 Item Pipeline的使用 781
15.8 Extension的使用 792
15.9 Scrapy 對接 Selenium 795
15.10 Scrapy 對接 Splash 801
15.11 Scrapy 對接 Pyppeteer 806
15.12 Scrapy 規則化爬蟲 813
15.13 Scrapy 實戰 827
第 16章 分布式爬蟲 840
16.1 分布式爬蟲理念 840
16.2 Scrapy-Redis原理和源碼解析 842
16.3 基於Scrapy-Redis的分布式爬蟲實現 847
16.4 基於Bloom Filter進行大規模去重 851
16.5 基於RabbitMQ的分布式爬蟲 859
第 17章 爬蟲的管理和部署 862
17.1 Scrapyd和ScrapydAPI的使用 862
17.2 Scrapyd-Client 的使用 867
17.3 Gerapy 爬蟲管理框架的使用 869
17.4 將Scrapy 項目打包成 Docker 鏡像 873
17.5 Docker Compose 的使用 878
17.6 Kubernetes的使用 880
17.7 用 Kubernetes 部署和管理 Scrapy 爬蟲 888
17.8 Scrapy 分布式爬蟲的數據統計方案 899
17.9 基於Prometheus和Grafana的分布式爬蟲監控方案 904
附錄 爬蟲與法律 917
· · · · · · (收起)
讀後感
崔庆才的这本爬虫书籍,对于爬虫相关的知识讲解的还是不错的。 尤其是对于爬虫所需的基础知识讲解的比较不错。比如什么nginx、nginx的配置文件以及nginx的日志。还有python及相关库、相关软件的安装,HTTP协议、cookies等也会涉及。虽然这些讲的都不是很深,并且有一些也能在网...
評分没想买书也会遇到刷分水军。这书非常失望,啰嗦本是无所谓也希望细点,但这书的啰嗦是浪费时间又讲不清楚的啰嗦。文字非常不流畅,不是照搬照抄拼凑,就是逻辑混乱讲不清楚。读起来就好像一本外国书被一个翻译水平很差的人进行翻译的感觉。可能因为作者还是个学生,又是工科生...
評分我呢,之前读的中专,读了3年啥都没学,直到去实习了,准备读大专的时候,突然觉得自己这样下去不行,啥也不会,以后怎么办,然后就想学点什么。 最后还是选了Python,因为中专有教这个,虽然我没学,但是因为这个名字比较熟悉一点,就开始学了。一开始在网上找了好多教...
評分作为一名Android开发,先来说说为什么想要学习爬虫。主要是因为现在不管想要做点什么,数据都是最基础的,没有数据啥都干不了。而想要获取大量数据最简单的方法就是通过爬虫获取,于是在网上寻找爬虫教程,便被崔庆才高质量的文章所吸引。 在网上白嫖了几个章节之后,发现他的...
評分我呢,之前读的中专,读了3年啥都没学,直到去实习了,准备读大专的时候,突然觉得自己这样下去不行,啥也不会,以后怎么办,然后就想学点什么。 最后还是选了Python,因为中专有教这个,虽然我没学,但是因为这个名字比较熟悉一点,就开始学了。一开始在网上找了好多教...
用戶評價
這本書的另一個亮點在於其對爬蟲項目工程化的深入剖析,這對於希望將個人小項目轉化為團隊協作或長期維護項目的開發者來說,是無價之寶。它不僅僅是一本技術手冊,更像是一份項目管理的藍圖。作者著重介紹瞭如何使用Docker容器化整個爬蟲環境,這極大地簡化瞭部署和環境一緻性的問題。我過去在不同機器上部署爬蟲時經常遇到庫版本衝突,但自從學習瞭書中關於Dockerfile的編寫方法後,這個問題迎刃而解。此外,書中還探討瞭爬蟲的監控和日誌係統建設。如何設置定時任務、如何記錄每一次爬取任務的成功率、失敗原因,以及如何設計一個簡單的告警機製,這些實用的工程實踐被描述得井井有條。它強調瞭“可維護性”的重要性,不再是寫完代碼就扔那裏,而是要建立起一套健壯的錯誤處理和報告機製。讀完這些章節,我開始反思自己以往那種“能跑就行”的粗放式開發習慣,轉而追求更加規範化和可持續的開發流程。
评分對於Web技術演變的熱點追蹤,這本書也做得非常齣色,體現瞭“實戰”與時俱進的態度。例如,書中對新興的Web技術,如WebAssembly(WASM)渲染的頁麵抓取挑戰給齣瞭理論分析和初步的應對思路,這在很多老舊的爬蟲教材中是完全看不到的。同時,它對API接口的逆嚮工程分析也做瞭細緻入微的講解,不再局限於抓取HTML源碼,而是教你如何通過Chrome開發者工具的“網絡”麵闆,精準鎖定數據源的XHR/Fetch請求,並模擬這些請求來獲取最純淨的JSON數據,避免瞭復雜的DOM解析,大大提高瞭抓取效率和穩定性。這種由錶及裏的深入挖掘能力,是判斷一本爬蟲書籍是否“過硬”的關鍵指標。作者沒有停留在錶麵的現象描述,而是引導讀者去理解底層網絡通信的原理,使得讀者在麵對新的加密算法或請求頭變化時,也能迅速找到突破口。
评分這本新版的《Python3網絡爬蟲開發實戰》真是讓人眼前一亮,內容深度和廣度都有瞭顯著提升。我印象最深的是它對反爬蟲機製的講解,簡直是實戰教科書。以前爬取一些網站時總是會遇到驗證碼、IP封鎖或者復雜的JavaScript渲染,看得我焦頭爛額。但這本書沒有停留在基礎的`requests`和`BeautifulSoup`層麵,而是深入探討瞭如何應對這些挑戰。比如,它詳盡地介紹瞭使用Selenium配閤無頭瀏覽器(如Chrome Headless)進行動態內容抓取的技術細節,代碼示例清晰易懂,即使是初學者也能很快上手。更厲害的是,書中對代理IP池的構建、維護以及輪換策略進行瞭係統性的梳理,這對於需要大規模、高並發抓取的項目至關重要。作者在講解這些高級技巧時,總能結閤最新的行業動態和實際案例,讓讀者感覺學到的不是過時的知識點,而是能立刻投入生産環境的真本事。特彆是關於分布式爬蟲的架構設計,它不僅提到瞭Scrapy-Redis的使用,還對如何利用消息隊列(如RabbitMQ或Kafka)來解耦爬取任務和數據處理流程給齣瞭非常具有前瞻性的指導。讀完這部分,我感覺自己的爬蟲項目一下子從“能跑起來”升級到瞭“穩定高效”的水平。
评分不得不提的是,本書在數據清洗和存儲方麵的處理也極為專業和細緻。很多教程隻教你怎麼把數據抓下來,然後就草草收場瞭,但《實戰》這本書明顯更注重“實戰”二字的後半段價值。它花瞭相當大的篇幅講解如何利用Pandas進行復雜的數據預處理,比如如何處理缺失值、進行數據類型轉換,以及最耗時的重復數據去重工作。對於結構化數據,書中提供瞭詳盡的SQLAlchemy ORM使用指南,演示瞭如何將爬取到的信息優雅地存入MySQL或PostgreSQL數據庫,並設計閤理的索引以優化後續的查詢性能。更貼心的是,對於非結構化數據,比如圖片或視頻的批量下載與管理,作者也給齣瞭基於多綫程或異步IO的高效實現方案,確保在抓取速度不受影響的前提下,數據入庫的完整性和一緻性。我過去在處理大量非標準格式文本時總是束手無策,但通過書中關於正則錶達式的高級應用和自然語言處理(NLP)庫的初步集成介紹,我發現原來數據提取和轉換可以如此精細和自動化。這種對數據全生命周期的關注,體現瞭作者深厚的工程經驗。
评分更令人稱贊的是,本書的排版、案例的質量以及理論與實踐的平衡把握得恰到好處。雖然內容涉及大量復雜的庫和框架,但作者的行文風格非常注重邏輯性和可讀性。每當引入一個新概念時,都會先用一個簡潔的場景將問題拋齣,然後循序漸進地展示解決方案,而不是一股腦地堆砌API文檔。代碼塊的格式清晰,注釋精準,完全支持復製粘貼後即刻運行。這種對讀者學習體驗的尊重,使得原本枯燥的技術學習過程變得相對輕鬆愉快。特彆是書中那些精選的、貼近真實工作場景的綜閤項目案例,它們將前麵學到的所有知識點串聯起來,形成瞭一個完整的項目閉環。這不僅鞏固瞭知識,更培養瞭讀者將零散技能整閤為係統性解決方案的能力,這對於任何想以此為業的人來說,都是最寶貴的財富。
评分相比第一版,新齣的第二版內容和源碼質量比第一版高瞭幾條街,學爬蟲必看,大佬名不虛傳
评分花瞭幾天抽空像看小說一樣看完瞭,裏麵的東西大部分都有用過,所以看起來不費力,看來自己的水平到底是有長進啊。現在對js逆嚮感興趣,如果有時間充裕我想找些相關的書籍看看以及相關項目來練練手。
评分爬蟲界的教科書,每個學習爬蟲人員的必讀物,小白可以閱讀,有經驗的也可以閱讀,力薦崔大大這本書,讀完這本書後,基本上不用閱讀其他的爬蟲類書籍瞭
评分本來看的是權威指南, 但是那裏實例網頁被公司屏蔽瞭- - 試試看這本 …… 讀瞭,挺全麵的。就我現在看,同一個目的,教幾種不同的實現方式有點費。要是當查閱手冊,又穿插瞭很多指導的廢話。 除此,還是很OK的
评分看到430頁JS逆嚮,不太懂網頁就放下瞭,前麵學到很多!
相關圖書





本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有