
具体描述
◎ 编辑推荐
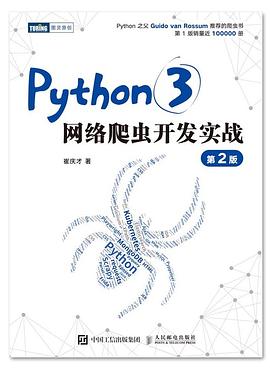
Python 之父 Guido van Rossum 推荐的爬虫入门书,第 1 版销量近 100000 册;
微软中国大数据工程师、博客文章过百万的静觅大神力作;
新增异步爬虫、JavaScript 逆向、App 逆向、智能网页解析、深度学习识别验证码、Kubernetes 运维及部署等知识点
◎ 内容简介
本书介绍了如何利用 Python 3 开发网络爬虫。本书为第 2 版,相比于第 1 版,为每个知识点的实战项目配备了针对性的练习平台,避免了案例过期的问题。另外,主要增加了异步爬虫、JavaScript 逆向、App 逆向、页面智能解析、深度学习识别验证码、Kubernetes 运维及部署等知识点,同时也对各个爬虫知识点涉及的请求、存储、解析、测试等工具进行了丰富和更新。
本书适合Python 程序员阅读。
◎ 大佬推荐
I am happy to see that Python is so widely used in the Chinese IT community. I hope this book will help more people understand Python and web crawling/scraping.
——Guido van Rossum,Creator of Python, Distinguished Engineer,Microsoft
时代在不断进步,我们需要不断学习,庆才在工作上是这样,在兴趣上也是这样,这本爬虫书充分体现了这一点。第 2 版相比第 1 版内容更加全面,覆盖的知识点更为广泛,也更贴近技术前沿。本书具有通俗易懂的讲解和丰富的案例代码,可以让读者系统地学习爬虫相关的各种知识,我极力推荐大家阅读本书。
——曾文峰,微软亚洲互联网工程院副院长、微软公司全球合伙人
在今天这个数据驱动的人工智能时代,这个有越来越多移动互联网数据来自 App 的时代,主流的数据来源平台几乎都提高了数据采集的风控水平,这导致数据采集的难度越来越大,此时行业中需要一本书来帮助爬虫工程师提高技术水平。崔庆才的这本《Python 3 网络爬虫开发实战(第2版)》是市场上截至目前公开数据采集领域最好的图书之一,这本书能解答数据采集工作中遇到的大部分问题,更难得的是作者还建立了技术讨论群,方便大家交流和提高。
——梁斌 penny,北京八友科技总经理、清华大学博士
作为第 1 版的升级版,本书增加了很多前沿的爬虫相关技术。从爬虫入门到分布式抓取,本书详细介绍了爬虫技术的各个要点,并针对不同场景提出了不同的解决方案。另外,书中的实战案例也在第 1 版的基础上做了重构升级,能帮助读者更好地学习爬虫技术。本书内容通俗易懂,干货满满,强烈推荐给大家!
——宋睿华,中国人民大学高瓴人工智能学院长聘副教授
作者简介
崔庆才
微软(中国)软件工程师,北京航空航天大学硕士,主要研究网络爬虫、Web 开发、机器学习等方向。
目录信息
1.1 HTTP基本原理 1
1.2 Web 网页基础 12
1.3 爬虫的基本原理 19
1.4 Session和Cookie 21
1.5 代理的基本原理 24
1.6 多线程和多进程的基本原理 26
第2章 基本库的使用 29
2.1 urllib的使用 29
2.2 requests的使用 47
2.3 正则表达式 63
2.4 httpx的使用 73
2.5 基础爬虫案例实战 78
第3章 网页数据的解析提取 90
3.1 XPath的使用 90
3.2 Beautiful Soup的使用 99
3.3 pyquery的使用 113
3.4 parsel 的使用 124
第4章 数据的存储 128
4.1 TXT 文本文件存储 128
4.2 JSON 文件存储 130
4.3 CSV 文件存储 134
4.4 MySQL 存储 138
4.5 MongoDB 文档存储 144
4.6 Redis缓存存储 151
4.7 Elasticsearch 搜索引擎存储 159
4.8 RabbitMQ 的使用 166
第5章 Ajax 数据爬取 174
5.1 什么是 Ajax 174
5.2 Ajax分析方法 176
5.3 Ajax 分析与爬取实战 179
第6章 异步爬虫 191
6.1 协程的基本原理 191
6.2 aiohttp的使用 201
6.3 aiohttp 异步爬取实战 207
第7章 JavaScript 动态渲染页面爬取 212
7.1 Selenium 的使用 212
7.2 Splash 的使用 226
7.3 Pyppeteer 的使用 242
7.4 Playwright 的使用 257
7.5 Selenium 爬取实战 269
7.6 Pyppeteer 爬取实战 276
7.7 CSS 位置偏移反爬案例分析与爬取实战 282
7.8 字体反爬案例分析与爬取实战 287
第8章 验证码的识别 293
8.1 使用 OCR 技术识别图形验证码 293
8.2 使用 OpenCV 识别滑动验证码的缺口 298
8.3 使用深度学习识别图形验证码 304
8.4 使用深度学习识别滑动验证码的缺口 309
8.5 使用打码平台识别验证码 316
8.6 手机验证码的自动化处理 324
第9章 代理的使用 331
9.1 代理的设置 331
9.2 代理池的维护 340
9.3 付费代理的使用 351
9.4 ADSL 拨号代理的搭建方法 357
9.5 代理反爬案例爬取实战 365
第 10章 模拟登录 373
10.1 模拟登录的基本原理 373
10.2 基于Session和Cookie的模拟登录爬取实战 376
10.3 基于JWT的模拟登录爬取实战 381
10.4 大规模账号池的搭建 385
第 11章 JavaScript 逆向爬虫 397
11.1 网站加密和混淆技术简介 397
11.2 浏览器调试常用技巧 413
11.3 JavaScript Hook 的使用 430
11.4 无限 debugger 的原理与绕过 440
11.5 使用 Python 模拟执行 JavaScript 445
11.6 使用 Node.js 模拟执行 JavaScript 451
11.7 浏览器环境下 JavaScript 的模拟执行 454
11.8 AST 技术简介 460
11.9 使用 AST 技术还原混淆代码 472
11.10 特殊混淆案例的还原 480
11.11 WebAssembly 案例分析和爬取实战 490
11.12 JavaScript 逆向技巧总结 498
11.13 JavaScript 逆向爬取实战 505
第 12章 App 数据的爬取 530
12.1 Charles 抓包工具的使用 530
12.2 mitmproxy 抓包工具的使用 538
12.3 mitmdump 实时抓包处理 544
12.4 Appium 的使用 551
12.5 基于 Appium 的 App 爬取实战 562
12.6 Airtest 的使用 568
12.7 基于 Airtest 的 App 爬取实战 585
12.8 手机群控爬取实战 591
12.9 云手机的使用 594
第 13章 Android 逆向 603
13.1 jadx 的使用 603
13.2 JEB 的使用 615
13.3 Xposed 框架的使用 624
13.4 基于 Xposed 的爬取实战案例 635
13.5 Frida 的使用 643
13.6 SSL Pining 问题的解决方案 650
13.7 Android 脱壳技术简介与实战 657
13.8 利用 IDA Pro 静态分析和动态调试 so 文件 664
13.9 基于 Frida-RPC 模拟执行 so 文件 680
13.10 基于 AndServer-RPC 模拟执行 so 文件 685
13.11 基于 unidbg 模拟执行 so 文件 692
第 14章 页面智能解析 700
14.1 页面智能解析简介 700
14.2 详情页智能解析算法简介 707
14.3 详情页智能解析算法的实现 714
14.4 列表页智能解析算法简介 722
14.5 列表页智能解析算法的实现 727
14.6 如何智能分辨列表页和详情页 735
第 15章 Scrapy框架的使用 739
15.1 Scrapy框架介绍 739
15.2 Scrapy入门 743
15.3 Selector 的使用 754
15.4 Spider 的使用 759
15.5 Downloader Middleware的使用 766
15.6 Spider Middleware的使用 775
15.7 Item Pipeline的使用 781
15.8 Extension的使用 792
15.9 Scrapy 对接 Selenium 795
15.10 Scrapy 对接 Splash 801
15.11 Scrapy 对接 Pyppeteer 806
15.12 Scrapy 规则化爬虫 813
15.13 Scrapy 实战 827
第 16章 分布式爬虫 840
16.1 分布式爬虫理念 840
16.2 Scrapy-Redis原理和源码解析 842
16.3 基于Scrapy-Redis的分布式爬虫实现 847
16.4 基于Bloom Filter进行大规模去重 851
16.5 基于RabbitMQ的分布式爬虫 859
第 17章 爬虫的管理和部署 862
17.1 Scrapyd和ScrapydAPI的使用 862
17.2 Scrapyd-Client 的使用 867
17.3 Gerapy 爬虫管理框架的使用 869
17.4 将Scrapy 项目打包成 Docker 镜像 873
17.5 Docker Compose 的使用 878
17.6 Kubernetes的使用 880
17.7 用 Kubernetes 部署和管理 Scrapy 爬虫 888
17.8 Scrapy 分布式爬虫的数据统计方案 899
17.9 基于Prometheus和Grafana的分布式爬虫监控方案 904
附录 爬虫与法律 917
· · · · · · (收起)
读后感
刚学爬虫的时候,网上都推荐用这本书。看了几章之后无疾而终。转去看官方文档。再次翻开这本书,看的人直冒冷汗。 除了前几章各种库的安装部分可能是作者自己写的。剩下内容都是网上博文按部就班,或者三流英语水平的官方文档翻译。 每章避重就轻,把文档用谷歌翻译一遍。其实...
几年前,我刚刚入门编程,会了一点python的基础语法之后,第一时间就想写个爬虫应用,当时在知乎上看了好几篇关于爬虫的教学文章,最后发现了崔庆才崔大的《一起学爬虫》专栏(应该是18年初,那时候还没出书),一阅便不可收拾... 崔大的文章可以说是爬虫小白的入门佳作了,从...
刚学爬虫的时候,网上都推荐用这本书。看了几章之后无疾而终。转去看官方文档。再次翻开这本书,看的人直冒冷汗。 除了前几章各种库的安装部分可能是作者自己写的。剩下内容都是网上博文按部就班,或者三流英语水平的官方文档翻译。 每章避重就轻,把文档用谷歌翻译一遍。其实...
咳咳,我来了。回想自己的编程经历,简单来说是从2018年我读研的时候,偶然在网上搜索到了一个“崔庆才|静谧”,点进去了这个博主的博客,我发现了一个新大陆! 没错,这是我觉得这几年来自己最幸运的事之一,因为我学的别的专业,在当时没有基础,编程对我来说遥不可及,所以...
看了高评分才买了这书。但真的写的很差,没用的内容啰嗦很多,开始说要讲更实用的方法时怎么都讲不清楚还自相矛盾,就是一带而过。不知道是不是作者也不知道怎么理解,只是从别处抄了过来。以后再也不能买在读学生写的书了,太浪费时间了。而且现在感觉爬虫不应该看书,应该从...
用户评价
对于Web技术演变的热点追踪,这本书也做得非常出色,体现了“实战”与时俱进的态度。例如,书中对新兴的Web技术,如WebAssembly(WASM)渲染的页面抓取挑战给出了理论分析和初步的应对思路,这在很多老旧的爬虫教材中是完全看不到的。同时,它对API接口的逆向工程分析也做了细致入微的讲解,不再局限于抓取HTML源码,而是教你如何通过Chrome开发者工具的“网络”面板,精准锁定数据源的XHR/Fetch请求,并模拟这些请求来获取最纯净的JSON数据,避免了复杂的DOM解析,大大提高了抓取效率和稳定性。这种由表及里的深入挖掘能力,是判断一本爬虫书籍是否“过硬”的关键指标。作者没有停留在表面的现象描述,而是引导读者去理解底层网络通信的原理,使得读者在面对新的加密算法或请求头变化时,也能迅速找到突破口。
这本书的另一个亮点在于其对爬虫项目工程化的深入剖析,这对于希望将个人小项目转化为团队协作或长期维护项目的开发者来说,是无价之宝。它不仅仅是一本技术手册,更像是一份项目管理的蓝图。作者着重介绍了如何使用Docker容器化整个爬虫环境,这极大地简化了部署和环境一致性的问题。我过去在不同机器上部署爬虫时经常遇到库版本冲突,但自从学习了书中关于Dockerfile的编写方法后,这个问题迎刃而解。此外,书中还探讨了爬虫的监控和日志系统建设。如何设置定时任务、如何记录每一次爬取任务的成功率、失败原因,以及如何设计一个简单的告警机制,这些实用的工程实践被描述得井井有条。它强调了“可维护性”的重要性,不再是写完代码就扔那里,而是要建立起一套健壮的错误处理和报告机制。读完这些章节,我开始反思自己以往那种“能跑就行”的粗放式开发习惯,转而追求更加规范化和可持续的开发流程。
不得不提的是,本书在数据清洗和存储方面的处理也极为专业和细致。很多教程只教你怎么把数据抓下来,然后就草草收场了,但《实战》这本书明显更注重“实战”二字的后半段价值。它花了相当大的篇幅讲解如何利用Pandas进行复杂的数据预处理,比如如何处理缺失值、进行数据类型转换,以及最耗时的重复数据去重工作。对于结构化数据,书中提供了详尽的SQLAlchemy ORM使用指南,演示了如何将爬取到的信息优雅地存入MySQL或PostgreSQL数据库,并设计合理的索引以优化后续的查询性能。更贴心的是,对于非结构化数据,比如图片或视频的批量下载与管理,作者也给出了基于多线程或异步IO的高效实现方案,确保在抓取速度不受影响的前提下,数据入库的完整性和一致性。我过去在处理大量非标准格式文本时总是束手无策,但通过书中关于正则表达式的高级应用和自然语言处理(NLP)库的初步集成介绍,我发现原来数据提取和转换可以如此精细和自动化。这种对数据全生命周期的关注,体现了作者深厚的工程经验。
更令人称赞的是,本书的排版、案例的质量以及理论与实践的平衡把握得恰到好处。虽然内容涉及大量复杂的库和框架,但作者的行文风格非常注重逻辑性和可读性。每当引入一个新概念时,都会先用一个简洁的场景将问题抛出,然后循序渐进地展示解决方案,而不是一股脑地堆砌API文档。代码块的格式清晰,注释精准,完全支持复制粘贴后即刻运行。这种对读者学习体验的尊重,使得原本枯燥的技术学习过程变得相对轻松愉快。特别是书中那些精选的、贴近真实工作场景的综合项目案例,它们将前面学到的所有知识点串联起来,形成了一个完整的项目闭环。这不仅巩固了知识,更培养了读者将零散技能整合为系统性解决方案的能力,这对于任何想以此为业的人来说,都是最宝贵的财富。
这本新版的《Python3网络爬虫开发实战》真是让人眼前一亮,内容深度和广度都有了显著提升。我印象最深的是它对反爬虫机制的讲解,简直是实战教科书。以前爬取一些网站时总是会遇到验证码、IP封锁或者复杂的JavaScript渲染,看得我焦头烂额。但这本书没有停留在基础的`requests`和`BeautifulSoup`层面,而是深入探讨了如何应对这些挑战。比如,它详尽地介绍了使用Selenium配合无头浏览器(如Chrome Headless)进行动态内容抓取的技术细节,代码示例清晰易懂,即使是初学者也能很快上手。更厉害的是,书中对代理IP池的构建、维护以及轮换策略进行了系统性的梳理,这对于需要大规模、高并发抓取的项目至关重要。作者在讲解这些高级技巧时,总能结合最新的行业动态和实际案例,让读者感觉学到的不是过时的知识点,而是能立刻投入生产环境的真本事。特别是关于分布式爬虫的架构设计,它不仅提到了Scrapy-Redis的使用,还对如何利用消息队列(如RabbitMQ或Kafka)来解耦爬取任务和数据处理流程给出了非常具有前瞻性的指导。读完这部分,我感觉自己的爬虫项目一下子从“能跑起来”升级到了“稳定高效”的水平。
祝大家早日学完爬豆瓣!
快速看完还行😂只是不太习惯教科书,本科开始都是野路子自学:遇山开路,遇水搭桥。
前面的感觉有些流水账,后面的部分干货很多!而且还有配套网站,读完收获很大!
1、知识点的更新 第二版覆盖了目前从业必备的 Js 逆向和 App 逆向的知识点,囊括爬虫基础,进阶逆向以及工程化内容 3年前的第一版大部分是工程化的内容,三年爬虫技术发展可以用一年一个版本,加密一年比一年难的地步,第二版把这三年用到的逆向基础知识都搞上了,入门问题不大。冲! 2、永不过时的练习网站 购买第一版的读者头疼的地方就是学了知识不知道去那练习,很多网站的反爬策略已经过时,第二版就没有这个烦恼,作者已经对练习网站做了二次升级(自动扩容应对高并发),这个想法点赞,这样不管啥时候买的书都可以练习 3、权威大佬推荐 这个不用说了吧,获得龟叔推荐的 Python 中文书,大佬buff 加成
基本上是把github上的内容照搬过来了 论文参考了其中一部分抓取方法