
具体描述
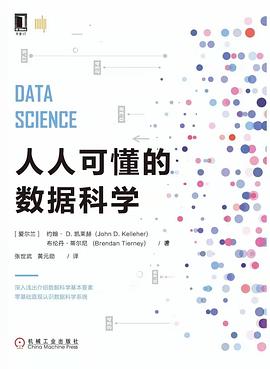
数据科学的主要目标就是通过数据分析来改进决策,它与数据挖掘、机器学习等领域紧密相关,但范围更广。本书简要介绍了该领域的发展、基础知识,并阐释了数据科学项目的各个阶段。书中既考虑数据基础架构和集成多个数据源数据所面临的挑战,又介绍机器学习基础并探讨如何应用机器学习专业技术解决现实问题。还综述了伦理和法律问题、数据法规的发展以及保护隐私的计算方法。最后探讨了数据科学的未来影响,并给出数据科学项目成功的原则。
作者简介
约翰· D.凯莱赫(John D. Kelleher) 布伦丹·蒂尔尼(Brendan Tierney) 著:约翰· D.凯莱赫(John D. Kelleher) 是都柏林理工学院计算机科学学院的教授以及信息、通信和娱乐研究所的学术负责人。他的研究得到了ADAPT中心的支持,该中心由爱尔兰科学基金会(Grant 13 / RC / 2106)资助,同时也接受欧洲区域发展基金的资助。 他还是《Fundamentals of Machine Learning for Predictive Data Analytics》的作者之一。
布伦丹·蒂尔尼(Brendan Tierney)是都柏林理工学院计算机科学学院的讲师,同时也是Oracle ACE 主任,还著有多本基于Oracle技术的数据挖掘类著作。
目录信息
前言
致谢
作者简介
第1章 什么是数据科学 …… 1
1.1 数据科学简史 …… 5
1.1.1 数据收集简史 …… 5
1.1.2 数据分析简史 …… 9
1.1.3 数据科学的产生与发展 …… 14
1.2 数据科学用于何处 …… 20
1.2.1 销售和营销中的数据科学 …… 21
1.2.2 数据科学在政府中的应用 …… 22
1.2.3 数据科学在竞技体育中的应用 …… 23
1.3 为什么是现在 …… 25
1.4 关于数据科学的神话 …… 28
第2章 什么是数据,什么是数据集 …… 31
2.1 关于数据的观点 …… 38
2.2 数据可以积累,而智慧不能 …… 43
2.3 CRISP-DM …… 45
第3章 数据科学生态系统 …… 54
3.1 将算法迁移至数据 …… 61
3.1.1 传统数据库与现代的传统数据库 …… 64
3.1.2 大数据架构 …… 67
3.1.3 混合数据库世界 …… 69
3.2 数据准备和集成 …… 72
第4章 机器学习 …… 77
4.1 有监督学习与无监督学习 …… 78
4.2 学习预测模型 …… 83
4.2.1 相关性不等同于因果,但它有时非常有用 …… 84
4.2.2 线性回归 …… 90
4.2.3 神经网络与深度学习 …… 96
4.2.4 决策树 …… 108
4.3 数据科学中的偏差 …… 114
4.4 评估模型:泛化而不是记忆 …… 116
4.5 摘要 …… 119
第5章 标准的数据科学任务 …… 121
5.1 谁是我们的目标客户(聚类) …… 122
5.2 这是欺诈吗(异常值检测) …… 128
5.3 你要配份炸薯条吗(关联规则挖掘) …… 131
5.4 流失还是不流失,这是一个问题(分类) …… 136
5.5 它价值几何(回归) …… 141
第6章 隐私与道德 …… 143
6.1 商业利益与个人隐私 …… 145
6.1.1 数据科学的道德启示:画像与歧视 …… 148
6.1.2 数据科学的道德含义:创建一个全景监狱 …… 154
6.2 隐私保护 …… 157
6.2.1 保护隐私的计算方法 …… 159
6.2.2 规范数据使用和保护隐私的法律框架 …… 161
6.3 通往道德的数据科学之路 …… 164
第7章 未来趋势与成功准则 …… 172
7.1 医疗数据科学 …… 172
7.2 智慧城市 …… 174
7.3 数据科学项目准则:为什么会成功或失败 …… 177
7.4 终极思考 …… 185
术语表 …… 188
延伸阅读 …… 201
参考文献 …… 203
· · · · · · (收起)
读后感
用户评价
这本书的价值真的体现在它对“为什么”的深度挖掘上,而不是简单地罗列“怎么做”。市面上很多教程都倾向于堆砌代码片段和高深的数学公式,让人看完后虽然能跑通程序,但对背后的逻辑仍然一头雾水,感觉像是在操作一个黑箱。然而,这本书的作者显然站在了更高的维度来审视数据科学的本质。在讲解“模型过拟合”时,作者没有直接给出正则化的公式,而是先通过一个形象的比喻——一个试图完美记住所有历史考题的学生,却在面对新题时束手无策——来解释了泛化能力的重要性。这种叙事性的解释方式,让抽象的概念瞬间变得具象化和可感。我尤其欣赏作者在关键节点设置的“思考题”,这些问题不是简单的选择题,而是需要读者停下来,结合前文的知识点进行实际推演的开放性提问。正是这些主动的思考环节,将知识点从被动接收转化为了主动建构,让学习过程充满了探索的乐趣。对于想真正理解数据科学而不是停留在表面调包侠阶段的人来说,这种对底层逻辑的执着探究,是这本书最宝贵的财富。
坦白说,我最初购买这本书时,是抱着一种“试一试”的心态,因为我之前购买的其他数据科学入门书籍大多虎头蛇尾,或者在实践环节戛然而止。但这本书的配套资源和实践引导设计得非常用心。作者似乎预料到了读者在实际操作中可能遇到的所有“坑”。每一个重要的算法讲解结束后,都会紧接着提供一个由简到繁的案例分析路径。更难得的是,它没有把所有的数据集都限定在那些光鲜亮丽的金融或电商案例中,反而穿插了一些社会学、环境监测等方面的数据集,拓宽了我们对数据应用场景的认知边界。例如,它展示了如何利用简单的线性回归分析城市绿化覆盖率与居民健康指数的关系,这种贴近民生的话题,极大地激发了我的兴趣和动手欲望。看完书中的代码示例,我立刻尝试着去用自己掌握的工具复现和修改,发现代码的注释清晰到几乎不需要再查阅其他文档,这种无缝衔接的学习体验,是衡量一本技术书籍是否“好用”的关键标准。它真正做到了理论指导实践,而不是理论孤芳自赏。
这本书的后半部分,关于模型部署和伦理讨论的部分,更是让我眼前一亮,因为它跳出了纯粹的技术范畴,进入了更具前瞻性的探讨。通常,很多入门书籍在模型训练一结束就戛然而止,仿佛数据科学的任务就此完成。但作者却花了相当的篇幅来讨论“数据偏见”和“算法公平性”的问题,这在当前强调负责任AI的时代背景下显得尤为重要。书中并没有给出简单的对错判断,而是列举了多个真实的案例,引导读者思考:当我们用数据训练模型时,我们是在复制历史的偏见,还是在创造一个更公正的未来?这种对社会责任和职业道德的强调,极大地提升了这本书的格局。它让我意识到,数据科学家不仅仅是代码的编写者,更是影响社会决策的重要角色。这种人文关怀与技术硬核的完美结合,让这本书不再是一本单纯的工具书,而更像是一部面向未来数据从业者的“行动指南”。它不仅教会了我“如何做”,更重要的是,它让我开始思考“应该怎么做”以及“为什么这么做”。
阅读体验上,这本书给我带来了一种久违的“被尊重”的感觉。很多技术书籍的作者似乎默认读者已经拥有了扎实的数学和编程背景,以至于在术语的使用上毫不留情。但《人人可懂的数据科学》则完全反其道而行之,它展现出一种对零基础读者的极度包容和耐心。作者在引入每一个专业术语,比如“最大似然估计”、“主成分分析”时,都会先用一两段话用最通俗的语言进行“去魅”,把那些高冷的概念拉下神坛。比如,解释“偏差-方差权衡”时,作者巧妙地将它比喻为我们做人生决策时,是选择一个简单但可能略有偏离的方案,还是选择一个复杂但力求完美的方案,但最终发现这个方案在面对新情况时非常脆弱。这种类比的构建,使得晦涩的数学概念被成功地“翻译”成了日常的逻辑判断。这种细腻的关怀,让那些本就对数据科学心生畏惧的读者,可以卸下心理包袱,更专注于知识本身的吸收,而不是被外围的专业壁垒所阻挡。
这本书的封面设计简约大气,米白色的底色配上深蓝色的书名和作者信息,给人的第一感觉是专业且平易近人。我原本以为数据科学这种技术含量高的领域,读起来会像啃硬骨头一样枯燥乏味,但是翻开目录后,发现作者的编排思路非常清晰。从最基础的数据收集、清洗,到核心的统计学原理,再到机器学习的模型构建,每一步都安排得井井有条,就像是为初学者量身定制的导航图。特别是关于“特征工程”那一章节的阐述,那种抽丝剥茧的讲解方式,让我这个对编程一窍不通的人也能大致领会其中的奥妙。它并没有一上来就抛出复杂的公式,而是先用生活中的例子来打比方,比如用投票结果来解释概率分布,用天气预报来类比回归分析。这种由浅入深、润物细无声的教学方法,极大地缓解了我对复杂算法的恐惧感。读完前几章,我感觉自己不再是站在数据科学的知识海洋之外的旁观者,而是真正踏入了这片领域,对后续的学习充满了期待和信心。这本书的排版也很舒服,留白恰到 দূরত্ব,阅读体验极佳,长时间阅读也不会感到视觉疲劳,这点对于需要大量时间沉浸学习的读者来说,无疑是一个巨大的加分项。
边读边向身边人推荐,全面但又篇幅很小,详略得当。第七章的数据科学成功准则,简直字字印证了当前工作的现状。好书让人激动啊!
边读边向身边人推荐,全面但又篇幅很小,详略得当。第七章的数据科学成功准则,简直字字印证了当前工作的现状。好书让人激动啊!
边读边向身边人推荐,全面但又篇幅很小,详略得当。第七章的数据科学成功准则,简直字字印证了当前工作的现状。好书让人激动啊!
作为小白看完很有收获,译者大大辛苦啦
Low A-