
Fundamentals of Biostatistics pdf epub mobi txt 电子书 下载 2026
- 统计
- 数据科学
- 生物统计
- Biostatistics
- Statistics
- Health Sciences
- Epidemiology
- Research Methods
- Data Analysis
- Probability
- Medical Statistics
- Public Health
- Quantitative Methods

具体描述
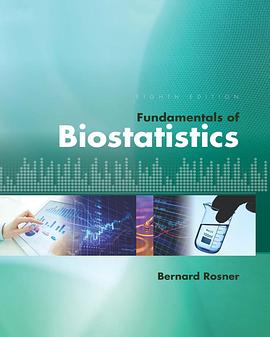
FUNDAMENTALS OF BIOSTATISTICS leads you through the methods, techniques, and computations of statistics necessary for success in the medical field. Every new concept is developed systematically through completely worked out examples from current medical research problems.
作者简介
Bernard Rosner is Professor in the Department of Medicine, Harvard Medical School, and the Department of Biostatistics at the Harvard School of Public Health. Dr. Rosner's research activities currently include longitudinal data analysis, analysis of clustered continuous, binary and ordinal data, methods for the adjustment of regression models for measurement error, and modeling of cancer incidence data.
目录信息
读后感
由浅入深,逻辑清晰,内容全面 ,比国内很多统计教材,水平不知道要高到哪里去! 涵盖了一般的描述性统计,包括正态分布,泊松分布,二项分布。统计推断,单样本推断,两个样本推断(参数检验), 非参数检验。还有分类数据,时间序列的检验,如fisher test, Log rank test.几...
评分由浅入深,逻辑清晰,内容全面 ,比国内很多统计教材,水平不知道要高到哪里去! 涵盖了一般的描述性统计,包括正态分布,泊松分布,二项分布。统计推断,单样本推断,两个样本推断(参数检验), 非参数检验。还有分类数据,时间序列的检验,如fisher test, Log rank test.几...
评分由浅入深,逻辑清晰,内容全面 ,比国内很多统计教材,水平不知道要高到哪里去! 涵盖了一般的描述性统计,包括正态分布,泊松分布,二项分布。统计推断,单样本推断,两个样本推断(参数检验), 非参数检验。还有分类数据,时间序列的检验,如fisher test, Log rank test.几...
评分由浅入深,逻辑清晰,内容全面 ,比国内很多统计教材,水平不知道要高到哪里去! 涵盖了一般的描述性统计,包括正态分布,泊松分布,二项分布。统计推断,单样本推断,两个样本推断(参数检验), 非参数检验。还有分类数据,时间序列的检验,如fisher test, Log rank test.几...
评分由浅入深,逻辑清晰,内容全面 ,比国内很多统计教材,水平不知道要高到哪里去! 涵盖了一般的描述性统计,包括正态分布,泊松分布,二项分布。统计推断,单样本推断,两个样本推断(参数检验), 非参数检验。还有分类数据,时间序列的检验,如fisher test, Log rank test.几...
用户评价
初次翻开这本书,我的第一印象是它的“务实”与“坦诚”。市面上许多同类教材总是试图将内容包装得过于平易近人,结果反而丢失了核心的严谨性;而这本书则反其道而行之,它毫不避讳统计学本身的复杂性,但同时又提供了足够清晰的指引,让人感觉作者是站在读者的角度,诚恳地引导我们穿越迷雾。书中对数据分布的讲解尤为出色,它没有停留在教科书式的正态分布介绍上,而是细致地比较了不同分布形态对后续分析方法的制约和影响,特别是对那些在生物医学研究中常见的非正态数据,提供了非常实用的处理思路。阅读过程中,我发现自己开始重新审视过去处理数据的一些习惯,认识到许多快捷方法背后的统计学风险。作者的笔触中透露着一种资深研究人员特有的洞察力,他们深知在真实世界中,数据很少是完美的“教科书案例”,因此书中融入的那些关于数据清洗、异常值处理的讨论,比任何理论推导都来得珍贵和实在。
评分这本关于生物统计学基础的书,读起来就像是深入了一个全新的、充满挑战却又极其迷人的知识领域。作者的叙述方式非常注重逻辑的严谨性,每一个概念的引入都像是精心设计的建筑蓝图,层层递进,让人不得不佩服其深厚的学术功底。我特别欣赏书中对核心统计学原理的阐述,它不仅仅是简单地罗列公式和定义,而是试图去挖掘这些工具背后的思想根源。例如,在讨论假设检验时,书中并未直接跳到P值,而是花了大篇幅去解释“零假设”的哲学意义以及我们如何通过数据“试错”来逼近真相,这种深度的探讨对于初学者来说无疑是一剂强心针,它让那些原本冰冷抽象的数学概念拥有了鲜活的生命力。此外,书中对实际生物学案例的引用也恰到好处,总能将理论知识与现实问题巧妙地结合起来,使得学习过程充满了探索的乐趣,而不是枯燥的计算练习。可以说,这是一本需要耐心啃读,但回报丰厚的著作,它不仅仅教授了“如何做统计”,更重要的是教会了读者“如何像一个统计学家一样思考”——那种审慎、严谨且充满批判性的思维模式。
评分我必须承认,这本书的数学部分确实具有一定的挑战性,但这种挑战是建设性的,而非挫败性的。它没有回避微积分和线性代数的介入,而是将必要的数学工具嵌入到统计概念的推导之中,目的似乎是让读者真正理解公式是如何“诞生”的,而不是机械地记忆。对于我这种偏文科背景的读者来说,起初确实有些吃力,但坚持下去后发现,一旦跨过了最初的几章,后续的理解速度会陡然加快。它像是一个精心布置的攀岩墙,初期的抓点很小,需要精准的发力,但一旦找到了节奏,向上攀升的过程就变得无比畅快。书中在探讨非参数检验时,那种优雅的论证方式,体现了作者对统计学各个分支的全面掌控力。它教会我们,当数据不听话时,我们依然有许多强大且合乎逻辑的工具来应对,这极大地增强了我在实际研究中处理复杂数据的信心。
评分这本书最让我感到惊喜的一点,是它对于“结果解释”的着墨之重。在很多统计学书籍中,重点往往停留在计算和得出结果的那一刻,但真正的科学价值恰恰在于如何将那些数字“翻译”成有意义的生物学结论。这本书的后半部分,花费了大量篇幅来讨论如何构建一个严谨的结论陈述,如何识别统计显著性与实际生物学重要性之间的微妙差异,以及如何透明地报告分析过程。它甚至探讨了在同行评审中,统计结果可能被质疑的常见陷阱。这种超越技术层面的指导,让这本书的价值远超一本标准的教科书。它更像是一位经验丰富的导师在耳边低语,告诫你科研的陷阱与坦途。读完之后,我感到自己不仅掌握了一套分析工具,更重要的是,建立起了一套更加成熟和负责任的科研伦理框架,这对于任何严肃的科学工作者而言,都是无可替代的收获。
评分这本书的结构设计简直是一门艺术,它像一条蜿蜒的河流,从源头的基本概念(如描述性统计)开始,逐渐汇集成信息量巨大的支流(如回归分析和方差分析),最终汇入广阔的海洋(更高级的推断方法)。令人称奇的是,尽管内容的广度和深度都达到了相当的水平,但整体的阅读节奏却出人意料地流畅。这主要归功于作者对过渡部分的精妙处理——每一个章节的结尾都会留下一个悬念或提出一个亟待解决的问题,从而自然地将读者的注意力引向下一部分。我尤其欣赏它对“模型假设”的强调。在很多统计书中,假设验证往往被简化为“套用公式”,但在这里,作者反复告诫我们,模型的有效性完全建立在假设的成立与否之上。这种对前提条件的执着,让这本书不仅仅是一本工具手册,更像是一份对科学探究精神的宣言。对于希望在学术研究中走得更远的人来说,这种对基础的坚守是至关重要的。
评分常读常新。还没完全学会。
评分常读常新。还没完全学会。
评分常读常新。还没完全学会。
评分常读常新。还没完全学会。
评分常读常新。还没完全学会。
相关图书







本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈图书下载中心 版权所有