
具体描述
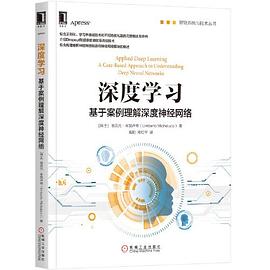
本书探讨深度学习中的高级主题,例如优化算法、超参数调整、Dropout和误差分析,并讨论如何解决在训练深度神经网络时遇到的典型问题。书中首先介绍单一神经元网络的激活函数(ReLu、sigmoid和Swish),然后介绍如何使用TensorFlow进行线性和逻辑回归,以及如何选择正确的代价函数,之后讨论具有多个层和神经元的更复杂的神经网络结构,并探讨权重的随机初始化问题。本书用一整章对神经网络误差分析进行全面概述,给出如何解决来自不同分布的方差、偏差、过拟合和数据集问题的例子。
本书还讨论在不使用任何Python库(NumPy除外)的情况下,如何从零开始完全实现逻辑回归,以便用诸如TensorFlow这样的库进行快速和有效的实验。本书包括每种方法的案例研究,以便将所有理论信息付诸实践。你还将学到Python代码的优化技巧(例如,使用NumPy对循环进行向量化)。
作者简介
翁贝托•米凯卢奇(Umberto Michelucci)
目前在瑞士领先的医疗保险公司从事创新和人工智能(AI)工作。他领导与人工智能、新技术、机器学习以及大学的研究合作相关的多项战略计划。此前,他曾担任多个大型医疗保健项目的数据科学家和首席建模师,并在编程和算法设计方面拥有丰富的实践经验。他管理过商务智能和数据仓库项目,使数据驱动的解决方案能够在复杂的生产环境中实施。最近,Umberto 对神经网络进行了广泛的研究,并应用深度学习来解决与保险、客户行为(如客户流失)和传感器科学相关的一些问题。他曾在意大利、美国和德国学习理论物理,并担任研究员,还在英国接受过高等教育。他经常在会议上发表科学成果,并在同行评审的期刊上发表研究论文。
目录信息
前言
审校者简介
致谢
第1章 计算图和TensorFlow1
1.1 如何构建Python环境1
1.1.1 创建环境3
1.1.2 安装TensorFlow7
1.1.3 Jupyter记事本8
1.2 TensorFlow基本介绍10
1.2.1 计算图10
1.2.2 张量12
1.2.3 创建和运行计算图13
1.2.4 包含tf.constant的计算图13
1.2.5 包含tf.Variable的计算图14
1.2.6 包含tf. placeholder的计算图15
1.2.7 运行和计算的区别18
1.2.8 节点之间的依赖关系18
1.2.9 创建和关闭会话的技巧19
第2章 单一神经元21
2.1 神经元结构21
2.1.1 矩阵表示法23
2.1.2 Python实现技巧:循环和NumPy24
2.1.3 激活函数25
2.1.4 代价函数和梯度下降:学习率的特点32
2.1.5 学习率的应用示例34
2.1.6 TensorFlow中的线性回归示例38
2.2 逻辑回归示例47
2.2.1 代价函数47
2.2.2 激活函数48
2.2.3 数据集48
2.2.4 TensorFlow实现51
2.3 参考文献54
第3章 前馈神经网络56
3.1 网络架构57
3.1.1 神经元的输出59
3.1.2 矩阵维度小结59
3.1.3 示例:三层网络的方程59
3.1.4 全连接网络中的超参数60
3.2 用于多元分类的softmax函数60
3.3 过拟合简要介绍61
3.3.1 过拟合示例61
3.3.2 基本误差分析66
3.4 Zalando数据集68
3.5 使用TensorFlow构建模型71
3.5.1 网络架构71
3.5.2 softmax函数的标签转换:独热编码73
3.5.3 TensorFlow模型74
3.6 梯度下降变体77
3.6.1 批量梯度下降77
3.6.2 随机梯度下降78
3.6.3 小批量梯度下降79
3.6.4 各种变体比较80
3.7 错误预测示例84
3.8 权重初始化84
3.9 有效添加多个层87
3.10 增加隐藏层的优点89
3.11 比较不同网络89
3.12 选择正确网络的技巧92
第4章 训练神经网络93
4.1 动态学习率衰减93
4.1.1 迭代还是周期94
4.1.2 阶梯式衰减95
4.1.3 步长衰减96
4.1.4 逆时衰减98
4.1.5 指数衰减100
4.1.6 自然指数衰减101
4.1.7 TensorFlow实现105
4.1.8 将方法应用于Zalando数据集108
4.2 常用优化器109
4.2.1 指数加权平均109
4.2.2 Momentum112
4.2.3 RMSProp115
4.2.4 Adam117
4.2.5 应该使用哪种优化器117
4.3 自己开发的优化器示例118
第5章 正则化123
5.1 复杂网络和过拟合123
5.2 什么是正则化127
5.3 ?p范数128
5.4 ?2正则化128
5.4.1 ?2正则化原理128
5.4.2 TensorFlow实现129
5.5 ?1正则化136
5.5.1 ?1正则化原理与TensorFlow实现137
5.5.2 权重真的趋于零吗137
5.6 Dropout140
5.7 Early Stopping143
5.8 其他方法144
第6章 指标分析145
6.1 人工水平表现和贝叶斯误差146
6.2 关于人工水平表现的故事148
6.3 MNIST中的人工水平表现149
6.4 偏差150
6.5 指标分析图151
6.6 训练集过拟合151
6.7 测试集152
6.8 如何拆分数据集153
6.9 不平衡类分布:会发生什么157
6.10 精确率、召回率和F1指标161
6.11 不同分布的数据集164
6.12 k折交叉验证170
6.13 手动指标分析示例177
第7章 超参数调优183
7.1 黑盒优化183
7.2 黑盒函数注意事项184
7.3 超参数调优问题185
7.4 黑盒问题示例186
7.5 网格搜索186
7.6 随机搜索190
7.7 粗到细优化192
7.8 贝叶斯优化195
7.8.1 Nadaraya-Watson回归195
7.8.2 高斯过程195
7.8.3 平稳过程196
7.8.4 用高斯过程预测196
7.8.5 采集函数200
7.8.6 上置信界(UCB)201
7.8.7 示例201
7.9 对数尺度采样207
7.10 使用Zalando数据集的超参数调优208
7.11 径向基函数注意事项214
第8章 卷积神经网络和循环神经网络216
8.1 卷积核和过滤器216
8.2 卷积217
8.3 卷积运算示例223
8.4 池化227
8.5 构建CNN块230
8.5.1 卷积层230
8.5.2 池化层231
8.5.3 各层的叠加231
8.5.4 CNN示例232
8.6 RNN介绍237
8.6.1 符号237
8.6.2 RNN的基本原理238
8.6.3 循环神经网络名称的由来239
8.6.4 学会统计239
第9章 研究项目244
9.1 问题描述244
9.2 数学模型246
9.3 回归问题246
9.4 数据准备250
9.5 模型训练258
第10章 从零开始进行逻辑回归261
10.1 逻辑回归的数学背景262
10.2 Python实现264
10.3 模型测试266
10.3.1 数据集准备267
10.3.2 运行测试268
10.4 结论268
· · · · · · (收起)
读后感
用户评价
我对这类技术书籍的评价标准之一,就是看它在引入前沿概念时,是否能清晰地勾勒出技术演进的历史脉络。深度学习的发展充满了波折和突破,从早期的沉寂到如今的蓬勃发展,每一步的跨越都不是偶然的。我希望这本书能在叙事中展现出这种“历史的必然性”——比如,为什么卷积网络(CNN)在图像处理领域会取得压倒性的优势?它的核心创新点究竟在哪里,是池化层带来的平移不变性,还是局部感受野的权重共享机制?如果作者能将这些核心思想用生动的语言和清晰的示意图结合起来,形成一种连贯的叙事流,那么即使是相对抽象的架构,也能在读者脑海中形成清晰的图像。我个人对它如何处理不同层次的抽象表示很有兴趣,毕竟深度学习的精髓就在于“学习特征的特征”,如果能看到这种特征层次的逐步提炼过程,将会非常有启发性。
这本书的最终价值,很大程度上取决于它对“案例”的处理深度和广度。技术书籍最怕的就是只谈理论而不落实例子,或者案例陈旧、缺乏代表性。深度学习的强大在于它解决实际问题的能力,所以,我非常关注它选择了哪些领域作为突破口来展示自己的能力。比如,在自然语言处理(NLP)的部分,它会侧重于机器翻译的Seq2Seq模型,还是会更深入地探讨预训练模型(如BERT或GPT系列)的内部工作机制?不同的案例选择,体现了作者对当前领域热点和未来趋势的判断。我希望这些案例不仅仅是简单的“输入-输出”展示,而是能深入到模型设计者是如何根据特定场景的需求,对通用架构进行裁剪、修改和优化的过程。如果这本书能像一个经验丰富的工程师在分享项目经验,剖析成功和失败的原因,而不是仅仅堆砌技术名词,那么它将远超一本普通参考书的价值,成为一本真正有指导意义的读物。
翻阅的过程中,我发现这本书在讲解算法实现时,似乎采取了一种偏向理论推导而非代码实战的路线,这对我来说是一个需要权衡的地方。我理解,一本好的理论书籍需要坚实的数学基础作为支撑,但深度学习又是一个高度依赖工程实现的领域。如果它能提供一种“伪代码”式的流程描述,或者至少清晰地标出关键的计算步骤和数据流向,那么对理解算法的执行过程会大有裨益。例如,在讨论循环神经网络(RNN)的变体,如LSTM或GRU时,结构图固然重要,但那些门控机制的数学表达和信息如何在细胞状态中流动、更新的细节,才是真正考验读者理解力的部分。我期待看到作者如何平衡数学的严谨性和读者的可操作性,如果能提供一些关键部分的数学推导的“精简版”,既保留核心思想又避免了冗长,那会是一个非常成功的折中方案。
这本书的封面设计倒是挺抓人眼球的,那种深邃的蓝色调,配上一些科技感的线条和复杂的网络结构图,一眼就能看出它想表达的主题。我本来对深度学习这个领域就有点好奇,想找一本能稍微入门,又不过于肤浅的书来啃啃。拿到手里掂了掂分量,感觉内容应该不薄,希望能有足够多的篇幅来解释那些复杂的概念,而不是走马观花。从目录上看,结构划分得还算清晰,从基础概念到一些具体的应用场景都有涉及,这让我对它构建知识体系的方式抱有一些期待。希望它能像一个经验丰富的向导,把我从完全不懂的门外汉,一步步引向一个能理解这个领域核心思想的阶段。尤其是那些理论推导的部分,如果能用更直观、更容易被非数学专业背景的读者接受的方式来阐述,那就太棒了。毕竟,深度学习的魅力在于它强大的实践能力,如果能把理论和实际操作的桥梁搭得更稳固一些,这本书的价值就体现出来了。我比较关注它在介绍某些经典模型时,会不会加入一些作者个人的见解或者实战中的“坑”,这些“过来人”的经验往往比教科书上的标准描述来得更实在、更有用。
说实话,这本书的排版风格让我有一种在阅读一本严谨的学术专著的感觉,字体选择和行距都比较紧凑,这对于需要长时间专注阅读的读者来说,无疑是一个挑战。我花了点时间习惯这种略显密集的视觉体验,但同时也体会到了一种“干货满满”的扎实感。我特别留意了它对早期神经网络模型,比如感知机和多层感知机(MLP)的阐述,看它如何处理激活函数的引入和反向传播算法的细节。我希望它不是简单地罗列公式,而是能深入剖析这些数学工具背后的直觉意义——为什么选择特定的激活函数会影响模型的收敛速度和表达能力?为什么梯度下降法在面对高维非凸优化问题时会显得力不从心?如果这本书能在这类基础问题的“为什么”上多下功夫,而不是仅仅停留在“是什么”的层面,那么它在我心中的地位就会大大提升。毕竟,理解了底层逻辑,再去学习更新、更复杂的模型时,才能做到举一反三,而不是生搬硬套。
大致翻阅了一下确实不错,可以看出作者确实有着深厚的功底,有非常深厚的实践经验,讲解也是深入浅出,墙裂推荐!也期待作者的下一本书
原理解析的一本书,很喜欢这种书,了解机制的感觉很爽,需要慢慢仔细读。
内容很实在,看了两天,确实比之前看过的深度学习讲得详细很多,而且多了很多案例图和代码例子!! 最重要的是,对我这种公式盲来说真的很有帮助!!顶一个!!
书籍印刷的挺好,看着舒服,我这种喜欢纸质阅读的人很喜欢。书的内容很好,这几本都是喜欢的,看了一些,没看到内容错误,推荐。
书籍印刷的挺好,看着舒服,我这种喜欢纸质阅读的人很喜欢。书的内容很好,这几本都是喜欢的,看了一些,没看到内容错误,推荐。