
具体描述
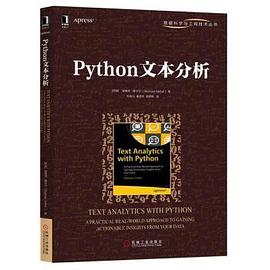
本书遵循结构化和综合性的方法,介绍了文本和语言语法、结构和语义的基础概念和高级概念。从自然语言和Python的基础开始,进而学习先进的分析理念和机器学习概念。全面提供了自然语言处理(NLP)和文本分析的主要概念和技术。包含了丰富的真实案例实现技术,例如构建分类新闻文章的文本分类系统,使用主题建模和文本摘要分析app或游戏评论,进行热门电影概要的聚类分析和电影评论的情感分析。介绍了基于Python和流行NLP开源库和文本分析实用工具,如自然语言工具包(nltk)、gensim、scikit-learn、spaCy和Pattern。
作者简介
迪潘简·撒卡尔(Dipanjan Sarkar)Intel 数据科学家。他的主要研究领域是数据分析、商业智能、应用开发以及大型智能系统构建。他专注于数据分析实践领域已经有四年多了,通过约翰霍普金斯大学的网络公开课程获得了数据科学专业认证,并且还出版了几本关于R语言和机器学习的书。
目录信息
译者序
前言
第1章自然语言基础
1.1自然语言
1.1.1什么是自然语言
1.1.2语言哲学
1.1.3语言习得和用法
1.2语言学
1.3语言句法和结构
1.3.1词
1.3.2短语
1.3.3从句
1.3.4语法
1.3.5语序类型学
1.4语言语义
1.4.1词汇语义关系
1.4.2语义网络和模型
1.4.3语义表示
1.5文本语料库
1.5.1文本语料库标注及使用
1.5.2热门的语料库
1.5.3访问文本语料库
1.6自然语言处理
1.6.1机器翻译
1.6.2语音识别系统
1.6.3问答系统
1.6.4语境识别与消解
1.6.5文本摘要
1.6.6文本分类
1.7文本分析
1.8小结
第2章Python语言回顾
2.1了解Python
2.1.1Python之禅
2.1.2应用:何时使用Python
2.1.3缺点:何时不用Python
2.1.4Python实现和版本
2.2安装和设置
2.2.1用哪个Python版本
2.2.2用哪个操作系统
2.2.3集成开发环境
2.2.4环境设置
2.2.5虚拟环境
2.3Python句法和结构
2.4数据结构和类型
2.4.1数值类型
2.4.2字符串
2.4.3列表
2.4.4集合
2.4.5字典
2.4.6元组
2.4.7文件
2.4.8杂项
2.5控制代码流
2.5.1条件结构
2.5.2循环结构
2.5.3处理异常
2.6函数编程
2.6.1函数
2.6.2递归函数
2.6.3匿名函数
2.6.4迭代器
2.6.5分析器
2.6.6生成器
2.6.7itertools和functools模块
2.7类
2.8使用文本
2.8.1字符串文字
2.8.2字符串操作和方法
2.9文本分析框架
2.10小结
第3章处理和理解文本
3.1文本切分
3.1.1句子切分
3.1.2词语切分
3.2文本规范化
3.2.1文本清洗
3.2.2文本切分
3.2.3删除特殊字符
3.2.4扩展缩写词
3.2.5大小写转换
3.2.6删除停用词
3.2.7词语校正
3.2.8词干提取
3.2.9词形还原
3.3理解文本句法和结构
3.3.1安装必要的依赖项
3.3.2机器学习重要概念
3.3.3词性标注
3.3.4浅层分析
3.3.5基于依存关系的分析
3.3.6基于成分结构的分析
3.4小结
第4章文本分类
4.1什么是文本分类
4.2自动文本分类
4.3文本分类的蓝图
4.4文本规范化处理
4.5特征提取
4.5.1词袋模型
4.5.2TFIDF模型
4.5.3高级词向量模型
4.6分类算法
4.6.1多项式朴素贝叶斯
4.6.2支持向量机
4.7评估分类模型
4.8建立一个多类分类系统
4.9应用
4.10小结
第5章文本摘要
5.1文本摘要和信息提取
5.2重要概念
5.2.1文档
5.2.2文本规范化
5.2.3特征提取
5.2.4特征矩阵
5.2.5奇异值分解
5.3文本规范化
5.4特征提取
5.5关键短语提取
5.5.1搭配
5.5.2基于权重标签的短语提取
5.6主题建模
5.6.1隐含语义索引
5.6.2隐含Dirichlet分布
5.6.3非负矩阵分解
5.6.4从产品评论中提取主题
5.7自动文档摘要
5.7.1隐含语义分析
5.7.2TextRank算法
5.7.3生成产品说明摘要
5.8小结
第6章文本相似度和聚类
6.1重要概念
6.1.1信息检索
6.1.2特征工程
6.1.3相似度测量
6.1.4无监督的机器学习算法
6.2文本规范化
6.3特征提取
6.4文本相似度
6.5词项相似度分析
6.5.1汉明距离
6.5.2曼哈顿距离
6.5.3欧几里得距离
6.5.4莱文斯坦编辑距离
6.5.5余弦距离和相似度
6.6文档相似度分析
6.6.1余弦相似度
6.6.2海灵格-巴塔恰亚距离
6.6.3Okapi BM25排名
6.7文档聚类
6.8最佳影片聚类分析
6.8.1kmeans聚类
6.8.2近邻传播聚类
6.8.3沃德凝聚层次聚类
6.9小结
第7章语义与情感分析
7.1语义分析
7.2探索WordNet
7.2.1理解同义词集
7.2.2分析词汇的语义关系
7.3词义消歧
7.4命名实体识别
7.5分析语义表征
7.5.1命题逻辑
7.5.2一阶逻辑
7.6情感分析
7.7IMDb电影评论的情感分析
7.7.1安装依赖程序包
7.7.2准备数据集
7.7.3有监督的机器学习技术
7.7.4无监督的词典技术
7.7.5模型性能比较
7.8小结
· · · · · · (收起)
读后感
用户评价
这本书的排版和装帧质量也值得一提。在阅读技术书籍时,阅读体验本身就是影响学习效率的一个重要因素。这本书的字体选择非常舒适,行间距和段落划分都恰到好处,即使长时间阅读也不会产生强烈的视觉疲劳。更值得称赞的是,那些复杂的流程图和算法结构图,绘制得极其清晰和美观。很多技术图表往往是信息密度过高,让人一看就头疼,但这本则不然,它似乎懂得如何用最少的元素传达最大的信息量。我发现自己在查阅或回顾某个特定算法步骤时,只需要看一眼对应的图示,就能迅速在脑海中重构出整个逻辑链条。这种对细节的关注,无疑体现了出版方和作者对读者体验的极致追求,使得学习过程本身也成为了一种享受,而非煎熬。
我花了好几天时间沉浸在这本书的章节中,最让我印象深刻的是它对特定工具和库的介绍部分。很多同类的书籍往往只是简单地罗列一下函数和参数,写得干巴巴的,让人读起来昏昏欲睡。但这本书的处理方式完全不同,它似乎更侧重于“为什么”要使用这个工具,以及在实际项目中,这个工具能解决哪些痛点。举例来说,当它介绍到某种文本预处理技术时,不仅仅是告诉你如何应用,还会深入剖析不同应用场景下,选择这个技术相对于其他备选方案的优势和局限性。这种深度的对比分析,极大地提升了我的批判性思维能力。我感觉自己不再是一个被动接受知识的容器,而是一个正在进行项目决策的工程师。书中提供的代码示例都经过了精心的打磨,逻辑清晰,注释详尽,即便是对于我这个在编程上有些“老手”的读者来说,也感到受益匪浅,很多原本只是模糊概念的地方,在代码运行起来后,瞬间就变得清晰透彻了。
读完关于情感分析的那几章内容后,我有一种豁然开朗的感觉。在此之前,我对“情感”的量化一直持怀疑态度,总觉得机器能理解的无非是些表层的词汇匹配,离人类复杂的情感世界相去甚远。但这本书用一系列严谨的实验和模型构建过程,向我展示了如何通过精细化的特征工程和先进的机器学习方法,去捕捉文本中那些微妙的语气和倾向性。书中讨论了从简单的基于词典的方法到复杂的深度学习模型的演变路径,并配有详尽的图表来解释不同模型的内部工作原理。更重要的是,它没有回避这些方法的弱点,比如如何处理反讽和双关语,这些都是真实世界数据中常见的“陷阱”。作者坦诚地指出了现有方法的局限,并提出了未来可以探索的方向,这使得整本书的论述显得非常成熟和全面,避免了那种“万能解药”式的浮夸。
这本书的结尾部分,着重探讨了文本分析在更宏大的人工智能图景中的定位,这部分内容让我深思了很久。它没有像一些入门书籍那样,在最后草草收场,而是将我们带到了一个更高远的视野。作者不仅仅是在教授“如何做”,更是在引导我们思考“为什么做”以及“未来去向何方”。它讨论了可解释性AI在文本模型中的重要性,以及伦理规范对数据采集和模型部署的影响。这使得这本书的价值远远超出了单纯的技术手册范畴,它更像是一份行业前瞻报告。对于那些希望将文本分析技术应用于实际业务,并对其长期发展有所规划的专业人士来说,这种前瞻性的洞察是无价的。它提供了一张地图,让我们不仅知道眼前的路怎么走,也对远方的地貌有了大致的了解,非常鼓舞人心。
这本书的封面设计得非常吸引人,那种深邃的蓝色背景搭配着简洁的白色字体,立刻让人感受到一股专业与深沉的气息。我原本是抱着一种既期待又忐忑的心情翻开它的,毕竟“文本分析”这个领域听起来就充满了复杂的算法和晦涩的理论。然而,令我惊喜的是,它的开篇并没有直接抛出那些令人望而生畏的数学公式或者抽象的概念。相反,作者非常巧妙地从一个非常贴近日常生活的例子入手,比如如何分析社交媒体上的用户评论来判断产品口碑,一下子就把理论和实践的距离拉近了。这种循序渐进的引导方式,让初学者也能很快抓住重点,建立起对整个领域的基本认知框架。那种感觉就像是,你站在一座高山的脚下,本以为要进行一场艰苦卓绝的攀登,结果发现,第一步的路已经铺设得如此平坦而引人入胜。我特别欣赏作者在讲解基础概念时,那种不厌其烦的细致,仿佛生怕你漏掉任何一个微小的知识点。这种对读者的尊重和关怀,在技术类书籍中是相当难得的。
机器学习懂的不多,这本书对我来讲还可以,比较详细
机器学习懂的不多,这本书对我来讲还可以,比较详细
机器学习懂的不多,这本书对我来讲还可以,比较详细
机器学习懂的不多,这本书对我来讲还可以,比较详细
机器学习懂的不多,这本书对我来讲还可以,比较详细