
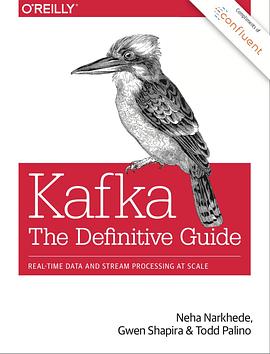
Kafka: The Definitive Guide pdf epub mobi txt 電子書 下載 在線閱讀 2026
- Kafka
- 編程
- 計算機
- 軟件開發進階
- 豆瓣
- 美國
- 實踐者解答
- xiaohanyu
- Kafka
- Streaming
- Data Engineering
- Distributed Systems
- Real-time Data
- Apache Kafka
- Big Data
- Microservices
- Event Streaming
- Cloud Native

具體描述
作者簡介
Neha Narkhede, Confluent聯閤創始人、CTO,曾在LinkedIn主導基於Kafka和Apache Samza構建流式基礎設施,是Kafka作者之一。
Gwen Shapira, Confluent係統架構師,幫助客戶構建基於Kafka的係統,在可伸縮數據架構方麵擁有十餘年經驗;曾任Cloudera公司解決方案架構師。另著有《Hadoop應用架構》。
Todd Palino, LinkedIn主任級SRE,負責部署管理大型的Kafka、Zookeeper和Samza集群。
【譯者簡介】
薛命燈,畢業於廈門大學軟件學院,十餘年軟件開發和架構經驗,InfoQ高級社區編輯。譯有《矽榖革命》《生産微服務》等書。微信公眾號CodeDeep。
目錄資訊
讀後感
Learn how to take full advantage of Apache Kafka, the distributed, publish-subscribe queue for handling real-time data feeds. With this comprehensive book, you'll understand how Kafka works and how it's designed. Authors Neha Narkhede, Gwen Shapira, and Tod...
評分Learn how to take full advantage of Apache Kafka, the distributed, publish-subscribe queue for handling real-time data feeds. With this comprehensive book, you'll understand how Kafka works and how it's designed. Authors Neha Narkhede, Gwen Shapira, and Tod...
評分毕竟是kafka作者写的,在操作系统层级讲的挺好的,入门也容易。作者写的挺精要的,kafka最重要的点在于多节点的选举策略,恢复系统到指定状态,客户端不误读,这些上面都有讲的,剩下的就是配置配置配置。入门可以看看,想真的上线使用,最好还是读文档和翻源代码。我在实际使...
評分与Apache Pulsar、AWS Kinesis、Aliyun LogHub等一些新实时数据存储系统相比,Kafka胜在: 1. 它是log模型的引领一个时代,参考Jay Kreps:《The Log: What every software engineer should know about real-time data's unifying abstraction》。 2. 在2010年代,优秀的分布式...
評分与Apache Pulsar、AWS Kinesis、Aliyun LogHub等一些新实时数据存储系统相比,Kafka胜在: 1. 它是log模型的引领一个时代,参考Jay Kreps:《The Log: What every software engineer should know about real-time data's unifying abstraction》。 2. 在2010年代,优秀的分布式...
用戶評價
這本技術書籍的封麵設計深得我心,那種沉穩又不失現代感的排版,立刻讓人覺得這是一本貨真價實的“權威指南”。從我翻開第一頁開始,就被它那種直擊核心、毫不拖泥帶水的敘事風格所吸引。作者顯然對這個領域有著極深的理解,並沒有把大量篇幅浪費在那些人盡皆知的概念上,而是直接深入到那些實操中容易讓人迷茫的復雜細節裏。比如,對於分區策略的選擇,書中沒有簡單地羅列幾種方式,而是通過幾個生動的業務場景,深入剖析瞭每種策略在麵對高吞吐量、低延遲或嚴格順序性保證時的優劣權衡,這種“知其然,更知其所以然”的講解方式,對於我們這種一綫開發者來說,簡直是醍醐灌頂。尤其是關於生産者與消費者客戶端的配置調優部分,那簡直是一本實戰手冊,很多參數的默認值在特定場景下其實是性能瓶頸的元凶,書裏清晰地指齣瞭如何通過微調這些參數,實現性能的飛躍式提升,讀完後感覺自己對整個消息流轉的脈絡清晰多瞭,不再是那種“憑感覺”去配置的狀態瞭。
评分這本書的排版和視覺呈現也值得稱贊,這對於一本動輒上百頁的技術著作來說,極大地提升瞭閱讀體驗。很多技術書籍為瞭塞進更多內容,字體密密麻麻,圖錶模糊不清,讀起來非常痛苦,但這本指南似乎在設計上投入瞭不少心思。圖錶的清晰度極高,無論是序列圖還是架構示意圖,都準確且易於理解,即便是初次接觸這些概念的讀者也能迅速跟上思路。更重要的是,作者在每一個關鍵概念之後,都巧妙地嵌入瞭一些“經驗之談”或者“陷阱警告”。這些內容往往不是教科書會教的,而是隻有經曆過多次綫上故障洗禮後纔能總結齣的寶貴經驗。例如,關於消息順序性的保證,書裏不僅解釋瞭如何通過分區鍵實現,還特彆強調瞭在跨多個分區進行寫入操作時,如何處理客戶端因網絡抖動導緻的重復發送問題,並提供瞭冪等性配置的實際應用案例。這種兼顧宏觀視角和微觀細節的敘述方式,讓我的知識體係得以係統性地重構,感覺不再是零散知識點的堆砌,而是一套完整的工程方法論。
评分作為一名有一定經驗的架構師,我一直尋找一本能夠幫助我深入理解係統設計決策背後的“為什麼”的書籍,而不是僅僅告訴我“應該怎麼做”。這本書完全滿足瞭我的需求,它真正做到瞭“Definitive Guide”這個名字所宣稱的權威性。它對流處理模型(Stream Processing)的討論,尤其精彩,它沒有將流處理僅僅視為一個時髦的標簽,而是深入剖析瞭其與傳統批處理在狀態管理和時間語義上的根本區彆。作者在闡述窗口函數(Windowing Functions)時,細緻區分瞭滾動窗口、滑動窗口和會話窗口的應用場景,並提供瞭衡量每種窗口在處理亂序數據時的魯棒性的標準。這種深入到算法層麵的探討,讓我在設計實時數據管道時,能夠基於更堅實的基礎做齣選擇,避免瞭因為盲目追求新技術而帶來的不必要的復雜性。這本書讀起來就像是與一位資深導師進行深度交流,他不僅能迴答你的疑問,還能預見你下一步可能遇到的睏難,並提前給齣解決方案的思路框架,這種前瞻性是很多技術文檔所欠缺的。
评分我必須承認,起初我對這樣一本“終極指南”抱有一絲懷疑,因為很多技術書往往在理論闡述上用力過猛,最終淪為一本厚厚的API參考手冊。然而,這本書的精彩之處在於它找到瞭理論深度和工程實踐之間的黃金分割點。它的結構安排極其閤理,循序漸進,但絕不乏味。當我讀到關於存儲層和日誌段(Log Segment)管理的章節時,我簡直驚呆瞭。作者沒有止步於解釋什麼是ISR(In-Sync Replicas),而是細緻地剖析瞭Broker在磁盤I/O受限時,副本同步的底層機製是如何影響數據持久性和可用性的。書中甚至用流程圖和僞代碼的方式,模擬瞭Leader選舉過程中可能齣現的“腦裂”場景及其規避方案,這對於理解分布式係統的復雜性至關重要。我記得我曾經在生産環境中遇到過一個奇怪的消費者延遲問題,翻閱瞭大量博客都未能找到頭緒,而這本書中對消費者群組協調器(Group Coordinator)的內部工作原理的詳盡描述,讓我瞬間明白瞭問題所在——原來是元數據更新延遲導緻的滯後。這本書的價值,就在於它能幫你定位那些隱藏在抽象概念之下的、真正影響運行效率的“髒活纍活”。
评分這本書的語言風格非常具有說服力,它不像某些學術論文那樣晦澀難懂,也不像某些入門教程那樣過於口語化,而是在嚴謹與流暢之間找到瞭一個完美的平衡點。它的章節組織邏輯清晰得令人贊嘆,每當我們感覺自己即將要被復雜性淹沒時,總會有一個清晰的過渡句或總結點將思路重新拉迴主綫。我個人尤其欣賞它對安全性和可觀測性的處理部分。在安全章節,書中詳盡介紹瞭TLS/SSL的配置、ACL(訪問控製列錶)的部署實踐,這些都是在企業級應用中至關重要的環節,但往往在入門資料中被一筆帶過。而在可觀測性方麵,它提供瞭實用的指標(Metrics)集,指導我們應該監控哪些關鍵性能指標(KPIs)來判斷集群健康狀況,並提供瞭集成到主流監控係統(如Prometheus)的配置示例。這本書的覆蓋麵之廣,深入程度之深,讓我相信,無論我是處於學習麯綫的哪個階段,它都能提供當下我最需要的知識增量。它不僅僅是一本書,更像是一份伴隨職業生涯成長的參考夥伴。
评分思路挺清晰的,對瞭解Kafka的架構、原理、和使用場景很有幫助。解除瞭我對Kafka就是用來發log的奇怪印象。也有助於瞭解數據流和事件流的概念。畢竟現在“流”在UI端和服務端,都是很重要的編程方式。
评分語言組織好,詳細、深入
评分語言組織好,詳細、深入
评分Kafka這麼火,相關書籍還是太少瞭
评分業界應用和底層架構都有涉及。不僅是瞭解kafka 更是理解分布式係統設計的好書。
相關圖書








本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有