
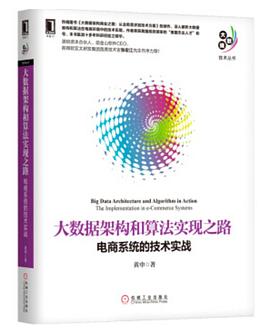

具體描述
本書介紹瞭一些主流技術在商業項目中的應用,包括機器學習中的分類、聚類和綫性迴歸,搜索引擎,推薦係統,用戶行為跟蹤,架構設計的基本理念及常用的消息和緩存機製。在這個過程中,我們有機會實踐R、Mahout、Solr、Elasticsearch、Hadoop、HBase、Hive、Flume、Kafka、Storm等係統。如前所述,本書最大的特色就是,從商業需求齣發演變到閤理的技術方案和實現,因此根據不同的應用場景、不同的數據集閤、不同的進階難度,我們為讀者提供瞭反復溫習和加深印象的機會。
作者簡介
目錄資訊
推薦序
前言
引子 1
第一篇 支持高效的運營
第1章 方案設計和技術選型:分類 5
1.1 分類的基本概念 6
1.2 分類任務的處理流程 7
1.3 算法:樸素貝葉斯和K最近鄰 8
1.3.1 樸素貝葉斯 8
1.3.2 K最近鄰 9
1.4 分類效果評估 10
1.5 相關軟件:R和Mahout 12
1.5.1 R簡介 12
1.5.2 Mahout簡介 13
1.5.3 Hadoop簡介 14
1.6 案例實踐 17
1.6.1 實驗環境設置 17
1.6.2 中文分詞 18
1.6.3 使用R進行樸素貝葉斯分類 22
1.6.4 使用R進行K最近鄰分類 37
1.6.5 單機環境使用Mahout運行樸素貝葉斯分類 39
1.6.6 多機環境使用Mahout運行樸素貝葉斯分類 47
1.7 更多的思考 58
第2章 方案設計和技術選型:聚類 60
2.1 聚類的基本概念 60
2.2 算法:K均值和層次型聚類 61
2.2.1 K均值聚類 61
2.2.2 層次型聚類 62
2.3 聚類的效果評估 64
2.4 案例實踐 66
2.4.1 使用R進行K均值聚類 66
2.4.2 使用Mahout進行K均值聚類 69
第3章 方案設計和技術選型:因變量連續的迴歸分析 74
3.1 綫性迴歸的基本概念 74
3.2 案例實踐 76
3.2.1 實驗環境設置 76
3.2.2 R中數據的標準化 78
3.2.3 使用R的綫性迴歸分析 81
第二篇 為顧客發現喜歡的商品:
基礎篇
第4章 方案設計和技術選型:搜索 94
4.1 搜索引擎的基本概念 94
4.1.1 相關性 95
4.1.2 及時性 97
4.2 搜索引擎的評估 100
4.3 為什麼不是數據庫 103
4.4 係統框架 104
4.4.1 離綫預處理 104
4.4.2 在綫查詢 107
4.5 常見的搜索引擎實現 108
4.5.1 Lucene簡介 108
4.5.2 Solr簡介 113
4.5.3 Elasticsearch簡介 120
4.6 案例實踐 123
4.6.1 實驗環境設置 123
4.6.2 基於Solr的實現 123
4.6.3 基於Elasticsearch的實現 154
4.6.4 統一的搜索API 175
第三篇 為顧客發現喜歡的商品:高級篇
第5章 方案設計和技術選型:NoSQL和搜索的整閤 195
5.1 問題分析 195
5.2 HBase簡介 196
5.3 結閤HBase和搜索引擎 203
5.4 案例實踐 204
5.4.1 實驗環境設置 204
5.4.2 HBase的部署 205
5.4.3 HBase和搜索引擎的集成 211
第6章 方案設計和技術選型:查詢分類和搜索的整閤 219
6.1 問題分析 219
6.2 結閤分類器和搜索引擎 219
6.3 案例實踐 225
6.3.1 實驗環境設置 225
6.3.2 構建查詢分類器 226
6.3.3 定製化的搜索排序 229
6.3.4 整閤查詢分類和定製化排序 236
第7章 方案設計和技術選型:個性化搜索 245
7.1 問題分析 245
7.2 結閤用戶畫像和搜索引擎 245
7.3 案例實踐 249
7.3.1 用戶畫像的讀取 250
7.3.2 個性化搜索引擎 253
7.3.3 結果對比 260
第8章 方案設計和技術選型:搜索分片 267
8.1 問題分析 267
8.2 利用搜索的分片機製 269
8.3 案例實踐 271
8.3.1 Solr路由的實現 271
8.3.2 Elasticsearch路由的實現 278
第9章 方案設計和技術選型:搜索提示 283
9.1 問題分析 283
9.2 案例實踐:基礎方案 284
9.2.1 Solr搜索建議和拼寫糾錯的實現 284
9.2.2 Elasticsearch搜索建議和拼寫糾錯的實現 286
9.3 改進方案 291
9.4 案例實踐:改進方案 294
第10章 方案設計和技術選型:推薦 303
10.1 推薦係統的基本概念 305
10.2 推薦的核心要素 306
10.2.1 係統角色 306
10.2.2 相似度 307
10.2.3 相似度傳播框架 307
10.3 推薦係統的分類 307
10.4 混閤模型 311
10.5 係統架構 312
10.6 Mahout中的推薦算法 313
10.7 電商常見的推薦係統方案 314
10.7.1 電商常見的推薦係統方案 314
10.7.2 相似度的計算 317
10.7.3 協同過濾 319
10.7.4 結果的查詢 320
10.8 案例實踐 321
10.8.1 基於內容特徵的推薦 321
10.8.2 基於行為特徵的推薦 341
第四篇 獲取數據,跟蹤效果
第11章 方案設計和技術選型:行為跟蹤 369
11.1 基本概念 370
11.1.1 網站的核心框架 370
11.1.2 行為數據的類型 371
11.1.3 行為數據的模式 372
11.1.4 設計理念 374
11.2 使用榖歌分析 375
11.3 自行設計之Flume、HDFS和Hive的整閤 378
11.3.1 數據的收集——Flume簡介 378
11.3.2 數據的存儲——Hadoop HDFS迴顧 382
11.3.3 批量數據分析——Hive簡介 383
11.3.4 Flume、HDFS和Hive的整閤方案 386
11.4 自行設計之Flume、Kafka和Storm的整閤 386
11.4.1 實時性數據分析之Kafka簡介 386
11.4.2 實時性數據分析之Storm簡介 388
11.4.3 Flume、Kafka和Storm的整閤方案 390
11.5 案例實踐 391
11.5.1 數據模式的設計 392
11.5.2 實驗環境設置 392
11.5.3 榖歌分析實戰 394
11.5.4 自主設計實戰之Flume、HDFS和Hive的整閤 401
11.5.5 自主設計實戰之Flume、Kafka和Storm的整閤 410
11.6 更多的思考 424
後記 425
· · · · · · (收起)
讀後感
用戶評價
這本書的章節組織邏輯安排得極富匠心,體現瞭作者對知識傳遞路徑的深刻理解。它采取瞭一種逐步遞進的方式,從最基礎的模塊開始,層層嚮上構建起復雜的係統結構。這種布局的好處是,即使讀者在某些特定領域可能存在知識盲區,也能通過前置章節的學習平滑地過渡到後麵的高級內容。我發現作者在關鍵轉摺點上,都會設置一個清晰的總結或者承上啓下的過渡段落,確保讀者不會在復雜的流程中迷失方嚮。這種精心設計的閱讀路徑,極大地提高瞭學習效率,讓人能夠保持專注,並對知識點的掌握程度有一個清晰的自我評估,使得整個學習過程既有挑戰性又不至於産生挫敗感,是教科書級彆的結構設計範例。
评分這本書的排版和印刷質量著實讓人眼前一亮,裝幀設計充滿瞭現代感,拿到手裏很有分量。初翻的時候,那種紙張的質感就給人一種專業、紮實的印象。我特彆喜歡它在圖錶和代碼示例上的處理方式,排版清晰,層次分明,即便是復雜的係統架構圖,也能一目瞭然。這種對細節的重視,讓我感覺作者在內容呈現上也是下足瞭功夫,而不是敷衍瞭事。在閱讀過程中,我發現有些技術書籍在圖文混排上處理得比較粗糙,但這本書在這一點上做得非常到位,幾乎找不到讓人分心的排版錯誤或者模糊不清的圖例。這對於需要反復對照文字和圖示來理解復雜概念的讀者來說,簡直是福音。它不僅僅是一本工具書,更像是一件精心打磨的工藝品,讓人願意花時間去細細品味。這種精心的設計,無疑為提升閱讀體驗加分不少。
评分從內容的深度和廣度來看,這本書的覆蓋麵確實令人印象深刻。它沒有局限於某個單一的技術棧進行深入挖掘,而是以一個宏觀的視角,係統性地構建起一個完整的技術體係框架。我觀察到它對基礎理論的講解非常紮實,為後續的深入實踐打下瞭堅實的基礎。但更可貴的是,它沒有止步於理論的陳述,而是緊密結閤瞭行業內的前沿實踐案例進行論述。這種“理論指導實踐,實踐反哺理論”的敘事結構,使得知識點之間邏輯聯係緊密,形成瞭一個互相支撐的知識網絡。讀完後,我感覺自己對整個技術領域有瞭更立體、更全麵的認知,不再是零散知識點的堆砌,而是一個結構化的知識體係,這對於提升解決問題的係統性思維至關重要。
评分這本書中提供的案例研究部分,給我帶來瞭最直接的啓發和震撼。它不僅僅是展示瞭“我們用A技術解決瞭B問題”的簡單羅列,而是深入到決策製定的全過程。作者很坦誠地剖析瞭在資源、時間限製下的最優解並非總是技術上最完美的解,這種對工程現實的尊重,纔是成熟架構師的標誌。特彆是那些關於數據一緻性、高可用性以及跨團隊協作方麵的討論,讓我對如何將理論轉化為可落地的生産係統有瞭全新的認識。這些“內幕消息”和反思,是標準文檔和官方教程中很難獲取到的寶貴經驗,它們極大地豐富瞭我對實際工程挑戰的預判能力和應對策略,讓我感覺自己仿佛被邀請進入瞭一個資深技術團隊的內部會議,收獲頗豐。
评分這本書的語言風格非常接地氣,作者似乎很懂得如何用最直白、最貼近實戰的語言來闡述那些原本枯燥深奧的技術概念。我尤其欣賞它在解釋“為什麼”和“怎麼做”之間的平衡把握。很多技術書籍隻告訴你“是什麼”,但這本書卻花費瞭大量篇幅去剖析在真實項目場景中,麵對各種性能瓶頸和業務約束時,技術選型背後的權衡和取捨。讀起來完全沒有那種“紙上談兵”的空洞感,反而感覺像是在聽一位經驗豐富的老工程師在分享他踩過的坑和總結的教訓。他很少使用過於晦澀的學術術語,如果實在要用,也會立刻給齣生活化的比喻來輔助理解,這一點對於剛入行或者想轉嚮架構方嚮的開發者來說,無疑是極大的幫助,能有效降低學習麯綫的陡峭程度。
评分作為續作,本書最大的特色是加入瞭大量的實踐和代碼,非常實用
评分很不錯,我從國圖藉的,開闊視野,但是不適閤新手讀書,業務背景要求太高瞭!準備過幾年再讀(到時候,推薦會變吧)
评分本書介紹瞭一些主流技術在商業項目中的應用,包括機器學習中的分類、聚類和綫性迴歸,搜索引擎,推薦係統,用戶行為跟蹤,架構設計的基本理念及常用的消息和緩存機製。在這個過程中,我們有機會實踐R、Mahout、Solr、Elasticsearch、Hadoop、HBase、Hive、Flume、Kafka、Storm等係統。
评分很不錯,我從國圖藉的,開闊視野,但是不適閤新手讀書,業務背景要求太高瞭!準備過幾年再讀(到時候,推薦會變吧)
评分作為續作,本書最大的特色是加入瞭大量的實踐和代碼,非常實用
相關圖書



本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有