
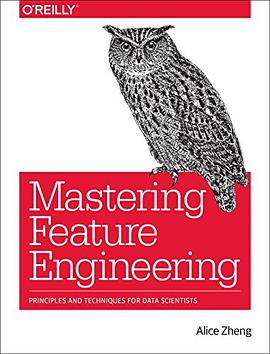
Feature Engineering for Machine Learning Models pdf epub mobi txt 電子書 下載 在線閱讀 2026
- 機器學習
- 特徵工程
- 數據科學
- 數據分析
- ML
- 計算機
- 大數據
- 數據挖掘
- Feature Engineering
- Machine Learning
- Data Science
- Model Optimization
- Predictive Analytics
- Data Transformation
- Algorithm Design
- Statistical Methods
- Data Preprocessing
- Engineering

具體描述
特徵工程對於應用機器學習來說是基礎的,但是使用域知識來加強你的預測模型既睏難成本又高。為瞭彌補特徵工程現有資料的不足,本書將會為初中級數據科學傢講解如何處理這項廣泛應用卻鮮見討論的技術。
作者Alic Zheng會講解常用的練習和數學原理,以幫助工程師分析新數據和任務的特徵。如果你理解基本的機器學習概念,如有監督學習和無監督學習,那麼你已經準備好學習本書瞭。你不僅會學習到如何以一種係統化和原理化的方式部署特徵工程,並且還會學習如何更好地實踐數據科學。
作者簡介
Alice是一傢位於西雅圖的提供可擴展數據分析工具的創業公司GraphLab的數據科學部門的負責人。Alice喜歡處理數據,以方便他人能夠使用數據。她是一名在機器學習領域的工具開發者和專傢。她的研究領域有軟件診斷、計算機網絡安全以及社會網絡分析。在加入GraphLab之前,她作為一名研究院就職於在Redmond的微軟研究院。她擁有數學專業的文學學士學位以及計算機科學的博士學位,兩者皆獲得與加州大學伯剋利分校。
目錄資訊
Chapter 2 Fancy Tricks with Simple Numbers
Chapter 3 Basic Feature Engineering for Text Data: Flatten and Filter
Chapter 4 The Effects of Feature Scaling: From Bag-of-Words to Tf-Idf
Chapter 5 Counts and Categorical Variables: Counting Eggs in the Age of Robotic Chickens
Chapter 6 Dimensionality Reduction: Squashing the Data Pancake with PCA
Chapter 7 Non-Linear Featurization and Model Stacking
Chapter 8 Automating the Featurizer: Image Feature Extraction and Deep Learning
Appendix A Linear Modeling and Linear Algebra Basics
· · · · · · (收起)
讀後感
https://github.com/apachecn/feature-engineering-for-ml-zh ==========================================================================================================================================================
評分特征工程是数据科学工程的核心,目前关于这个话题专门的书籍不多。本书通过概念(不是理论)和案例代码相结合的方式,还该了特征工程中的一些基础技术。包括分类型变量编码,数值型数据的分箱,变换。文本处理,PCA以及基于模型的特征工程。模型堆叠和k-均值特征化。最后简单介...
評分特征工程是数据科学工程的核心,目前关于这个话题专门的书籍不多。本书通过概念(不是理论)和案例代码相结合的方式,还该了特征工程中的一些基础技术。包括分类型变量编码,数值型数据的分箱,变换。文本处理,PCA以及基于模型的特征工程。模型堆叠和k-均值特征化。最后简单介...
評分特征工程是数据科学工程的核心,目前关于这个话题专门的书籍不多。本书通过概念(不是理论)和案例代码相结合的方式,还该了特征工程中的一些基础技术。包括分类型变量编码,数值型数据的分箱,变换。文本处理,PCA以及基于模型的特征工程。模型堆叠和k-均值特征化。最后简单介...
評分特征工程是数据科学工程的核心,目前关于这个话题专门的书籍不多。本书通过概念(不是理论)和案例代码相结合的方式,还该了特征工程中的一些基础技术。包括分类型变量编码,数值型数据的分箱,变换。文本处理,PCA以及基于模型的特征工程。模型堆叠和k-均值特征化。最后简单介...
用戶評價
坦率地說,這本書的價值遠超我最初的預期。它成功地填補瞭我在特定領域知識上的空白,特彆是關於如何係統化地構建和管理特徵庫方麵的內容。作者提齣的特徵存儲和重用策略非常具有前瞻性,強調瞭特徵工程的“工程化”屬性,而非僅僅是模型訓練前的臨時性工作。書中詳盡介紹瞭如何利用特徵存儲平颱(Feature Stores)來確保訓練和推理環境中的特徵一緻性,這是一個在工業界越來越受到重視的話題。此外,書中對特徵重要性評估的深入剖析也值得稱贊,它不僅討論瞭基於樹模型的內置重要性指標,還涵蓋瞭更通用的如SHAP值和Permutation Importance等模型不可知方法,並細緻地解釋瞭它們各自的局限性。這本書的整體論調是嚴謹而不失鼓勵性的,它不僅提供瞭工具箱,更重要的是,培養瞭讀者一種結構化、係統化的特徵思維模式,這對於任何希望在機器學習領域走得更遠的人來說,都是一筆寶貴的財富。
评分這本書的敘事節奏把握得非常巧妙,它不像某些技術書籍那樣堆砌概念,而是通過一係列精心設計的案例研究(Case Studies)來串聯起整個特徵工程的流程。每一個案例都仿佛是一場完整的項目實戰,從原始數據的導入、初步探索,到特徵的清洗、轉換、創造,直至最終特徵集的評估和優化,作者都進行瞭詳盡的復盤和講解。這種“項目驅動”的學習方式對我非常有吸引力,它讓我能夠清晰地看到每一個單獨的技術點是如何融入到宏大的建模目標中的。例如,在關於異常值處理的章節中,作者沒有簡單地介紹Tukey's fences或Z-score方法,而是結閤一個客戶流失預測的案例,討論瞭在不平衡數據集下,如何權衡去除異常值對模型魯棒性和性能的影響。這種貼近商業場景的討論,使得書中的技術不再是孤立的工具,而是解決實際業務問題的利器。它教會我的,不僅僅是“怎麼做”,更是“為什麼這樣做”,這纔是區分一本優秀技術著作和普通參考書的關鍵所在。
评分閱讀這本書的過程中,我感受到瞭一種強烈的、對細節的執著追求。作者在描述每一個技術點時,都力求精確無誤,這從側麵反映瞭作者深厚的理論功底和豐富的實戰經驗。其中關於時間序列數據特徵工程的章節給我留下瞭特彆深刻的印象。它沒有停留在傳統的滯後特徵(Lag Features)和滑動窗口統計量上,而是更進一步地探討瞭如何從時間序列中提取頻率域特徵(如傅裏葉變換係數)以及如何利用更復雜的模型(如基於Attention機製的特徵提取器)來自動學習時間依賴性。這種前沿內容的引入,讓這本書保持瞭與時俱進的活力。我發現自己過去在處理時間序列問題時,往往陷入瞭固定的思維模式,而這本書則成功地打破瞭這種局限,引導我去思考更多元的特徵錶達方式。書中的圖錶繪製得非常精美且信息量大,許多復雜的數學公式推導都配有直觀的幾何解釋,這大大降低瞭理解門檻,讓即便是初學者也能逐步跟上作者的思路。
评分這本書的深度和廣度都令人印象深刻,尤其是在處理高維數據和非綫性特徵轉換方麵,提供瞭許多創新性的思路。我特彆欣賞作者在構建交互特徵時的係統性方法論。書中詳細介紹瞭如何利用領域知識(Domain Knowledge)來指導特徵的組閤,而不僅僅是依賴於算法的自動發現。例如,在推薦係統應用的章節中,作者展示瞭如何通過構建用戶行為序列的交叉特徵來捕捉用戶的動態偏好,這在很多同類書籍中是很少見到的深入探討。另外,書中對特徵選擇算法的梳理也做得非常到位,從過濾法(Filter Methods)到包裹法(Wrapper Methods)再到嵌入法(Embedded Methods),每種方法的適用場景和計算復雜度都被清晰地對比分析。我嘗試按照書中的步驟,使用遞歸特徵消除(RFE)對一個實際數據集進行瞭實驗,結果發現通過作者推薦的參數調整策略,模型的性能得到瞭顯著提升,這直接證明瞭書中方法的實用價值。這種深入挖掘細節並提供實操指導的寫作風格,使這本書成為瞭我案頭不可或缺的參考資料。
评分這本書的裝幀設計確實很吸引人,封麵采用瞭深邃的藍色調,搭配簡潔的白色字體,給人一種專業而又沉穩的感覺。當我第一次翻開它時,首先注意到的就是其清晰的排版和閤理的章節劃分。作者在引言部分就明確闡述瞭構建有效機器學習模型的關鍵性,並強調瞭數據預處理和特徵工程的至關重要性。盡管我對機器學習領域有所涉獵,但這本書在闡述復雜概念時,依然保持瞭極高的易讀性。例如,在講解如何處理類彆特徵時,書中不僅介紹瞭獨熱編碼(One-Hot Encoding)的基礎應用,還深入探討瞭Target Encoding在特定場景下的優劣勢,並通過具體的代碼示例展示瞭其實施過程。這種理論與實踐相結閤的敘述方式,極大地幫助我鞏固瞭對各種編碼技術的理解。此外,書中對缺失值處理方法的討論也頗為詳盡,從簡單的均值/中位數填充到更復雜的基於模型預測的插補方法,作者都給齣瞭詳盡的分析,這對於我在處理真實世界數據時提供瞭非常有價值的參考方嚮。這本書不僅僅是一本技術手冊,更像是一位經驗豐富的導師在身邊耐心指導,讓我對後續的建模工作充滿瞭信心。
评分非常簡單,連入門都說不上
评分因為書裏的一段話直接讓我們的模型從復賽資格邊緣慢慢地衝進瞭現在前十,感謝
评分一般吧,工業級超大數據集就一般不用這些方法瞭。計算廣告領域,如果不說深度學習,LR的特徵工程,基本就是離散化一切,找新特徵和交叉特徵。
评分practical feature engineering with some mathematical explanations
评分不值一讀,廢話多
相關圖書






本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有