
具体描述
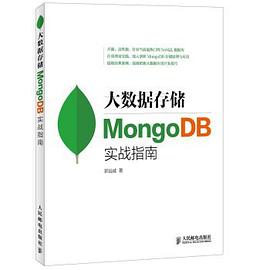
MongoDB是一种面向文档的分布式数据库,可扩展,表结构自由,并且支持丰富的查询语句和数据类型。时至今日,MongoDB以其灵活的数据存储方式逐渐成为IT行业非常流行的一种非关系型数据库(NoSql)。
《大数据存储MongoDB实战指南》从学习与实践者的视角出发,本着通俗精简、注重实践、突出精髓的原则,精准剖析了MongoDB的诸多概念和要点。全书共分4个部分,分别从基础知识、深入理解MongoDB、监控与管理MongoDB和应用实践几个维度详细地介绍了MongoDB的特点及应用实例。
《大数据存储MongoDB实战指南》适合有海量数据存储需求的人员、数据库管理开发人员、数据挖掘与分析人员以及各类基于数据库的应用开发人员。读者将从书中获得诸多实用的知识和开发技巧。
作者简介
郭远威,高级软件工程师,现任职于华为公司,擅长大数据存储相关工作。自幼好学、勤专研,熟悉大数据存储,精通MySql、Oracle、MongoDB等数据库;曾开发云计算存储平台、内存数据库等产品,管理、迁移过海外大型电信运营商的数据库系统;热爱开源技术,对最新技术保持高度关注。
目录信息
第1章大数据与云计算
1.1什么是大数据
1.2什么是云计算
1.3大数据与云计算
1.4什么是MongoDB
1.5大数据与MongoDB
1.6MongoDB特点
1.7安装MongoDB
1.8几个重要的进程介绍
1.8.1mongod进程
1.8.2mongo进程
1.8.3其他进程
1.9适合哪些业务
1.10小结
第2章查询语言系统
2.1查询选择器
2.2查询投射
2.3数组操作
2.4小结
第3章索引与查询优化
3.1索引
3.1.1单字段索引
3.1.2复合索引
3.1.3数组的多键索引
3.1.4索引管理
3.2查询优化
3.3小结
第4章增改删操作
4.1插入语句
4.2修改语句
4.3删除语句
4.4小结
第二部分深入理解MongoDB
第5章Journaling日志功能
5.1两个重要的存储视图
5.2Journaling工作原理
5.3小结
第6章聚集分析
6.1管道模式进行聚集
6.2MapReduce模式聚集
6.3简单聚集函数
6.4小结
第7章复制集
7.1复制集概述
7.2复制集工作机制
7.2.1数据同步
7.2.2故障转移
7.2.3写关注
7.2.4读参考
7.3小结
第8章分片集群
8.1分片部署架构
8.2分片工作机制
8.2.1使集合分片
8.2.2集群平衡器
8.2.3集群的写与读
8.2.4片键选择策略
8.3小结
第9章分布式文件存储系统
9.1小文件存储
9.2GridFS文件存储
9.3小结
第三部分监控与管理MongoDB
第10章管理与监控
10.1数据的导入导出
10.2备份与恢复
10.2.1单节点dump备份与恢复
10.2.2集群dump备份恢复策略
10.3监控
10.3.1数据库角度监控命令
10.3.2操作系统角度监控命令
10.3.3Web控制台监控
10.4小结
第11章权限控制
11.1权限控制API
11.1.1针对所有数据库的角色
11.1.2针对单个数据库的角色
11.2复制集与集群的权限控制
11.3小结
第四部分应用实践
第12章PHP驱动接口
12.1开发环境安装
12.2驱动介绍
12.3单实例上的增删改查
12.4几个重要的类、方法与参数
12.5复制集上的操作
12.6分片集群上的操作
12.7分布式小文件存取操作
12.8分布式大文件存取操作
12.9小结
第13章案例:高度可定制化的电商平台
13.1功能需求
13.2数据库表设计
13.3编写MongoDB_driver类
13.4CodeIgniter框架
13.4.1基本介绍
13.4.2下载与安装
13.4.3执行原理
13.4.4代码示范
13.5Bootstrap框架
13.6前台界面原型图
附录常见问题
· · · · · · (收起)
读后感
作者对复制集和集群部分写的比较清晰透彻,对于解决数据冗余备份和大数据的存储获取提供了一种较好的解决方案。PHP驱动代码方面对我比较有价值,可以直接参考并用在实际项目中,缩减了项目开发的难度和时间; 书中还有一章讲到了与关系数据库Mysql的比较也比较经典,使有关系数...
看内容感觉该书作者花了一番心血,实例均验证通过。理论部门描述的简洁清晰,与官方文档结合起来理解会更有帮助。该书侧重理论,内容结构很清楚,结合实践部分稍显薄弱,但对于刚开始学习或使用MongoDB的朋友,这本书作为入门书籍还是相当不错的。
看内容感觉该书作者花了一番心血,实例均验证通过。理论部门描述的简洁清晰,与官方文档结合起来理解会更有帮助。该书侧重理论,内容结构很清楚,结合实践部分稍显薄弱,但对于刚开始学习或使用MongoDB的朋友,这本书作为入门书籍还是相当不错的。
一直想找一本有关MongoDB的实用性书籍,看了这本书的又是与现在很火的大数据相结合,就心动了。 很想入手仔细学习。看到其他书友对于学习完本书之后的心得,对于mongoDB有了更深层次的理解,更是深刻感受到了作者所倾注的心血,更加心动了。
用户评价
对于我这种需要维护线上稳定运行系统的运维人员来说,系统的健壮性和可观测性是第一位的。《大数据存储MongoDB实战指南》中关于**监控、备份与恢复**的章节,可以说是为我量身定做的。它没有停留在部署一个基础的Replica Set,而是深入讲解了如何利用MongoDB自带的工具集,如`mongotop`、`mongostat`以及更高级的**性能分析器(Profiler)**进行深度的慢查询定位。最让我觉得物超所值的是,书中详细描绘了一套企业级的备份策略。它不仅覆盖了`mongodump`/`mongorestore`的常规用法,还重点讲解了**使用LVM快照结合物理备份**的方案,以最小化对在线业务的影响。此外,在灾难恢复的场景模拟中,它清晰地指出了在不同备份点恢复数据时,如何保证数据一致性的校验步骤,这比我在任何官方文档中找到的零散信息都要系统和可靠。读完后,我对我们现有的备份流程进行了彻底的审查和强化,心里踏实多了。
这本书的语言风格非常务实,没有过多华丽的辞藻,直奔主题,仿佛一位经验丰富的老前辈在手把手地带新人。我最欣赏的是它对**GridFS**的使用场景和局限性的探讨。很多教程将GridFS描绘成一个万能的文件存储方案,但《大数据存储MongoDB实战指南》却非常清醒地指出了,对于超大文件的频繁更新或小文件的海量存储,GridFS的性能和管理成本可能并不如专门的对象存储服务。作者通过一个媒体资产管理系统的案例,对比了直接存储在文档中、使用GridFS以及外挂S3的优缺点,这为我们在技术选型时提供了极其宝贵的参考意见。这种不偏不倚、基于数据和场景分析的建议,体现了作者深厚的实战积累。它教给我的不是如何使用一个工具,而是**如何基于业务需求,智慧地选择和组合技术栈**,这才是真正意义上的“实战指南”。
我之前对MongoDB一直持有一种观望态度,总觉得它在处理复杂事务和数据完整性方面不如关系型数据库来得让人安心。然而,读完这本《大数据存储MongoDB实战指南》中关于**多文档事务(Multi-Document Transactions)和文档设计**的部分后,我的顾虑大大减少了。《实战指南》并没有回避MongoDB在ACID特性上的历史局限性,而是非常坦诚地介绍了从早期无事务支持到引入多文档事务的演进过程,并详细阐述了在WiredTiger存储引擎下的事务隔离级别和锁机制。更重要的是,它引导读者思考,在文档数据库的范式下,**如何通过合理的数据冗余和嵌入式设计(Embedding)来最大化读取性能,从而减少对跨文档事务的依赖**。书中有一段关于“反范式化是性能的必要妥协”的论述,我深表赞同。它不是教你如何生搬硬套SQL的规范,而是教你如何根据MongoDB的存储特性,设计出既能满足业务逻辑,又能充分利用其高性能特性的数据模型。这种理念层面的引导,对于构建现代数据架构至关重要。
对于一个经验相对丰富的后端工程师来说,我最看重的技术书籍是那种能提供“为什么”和“怎么做”的完整闭环,而不是停留在“是什么”的表面描述。《大数据存储MongoDB实战指南》在这方面表现得相当出色。我尤其欣赏它对**聚合框架(Aggregation Framework)的实战应用**章节。很多资料只是列举了$match、$group、$project这些操作符的用法,但这本书却构建了一个完整的、复杂的、跨多个集合的报表生成场景,手把手地演示了如何利用管道(Pipeline)实现传统SQL中需要JOIN才能完成的复杂统计分析。作者似乎深谙处理大数据量下聚合操作的性能陷阱,文中穿插了大量关于**内存限制、临时文件生成以及优化管道顺序**的实操技巧。比如,它强调了应该尽可能早地使用$match来缩小数据范围,这虽然是基本原则,但书中通过一个包含上亿文档的日志数据集的实际运行时间对比,直观地展示了遵循这一原则带来的数量级性能提升。这种基于真实世界复杂数据和高负载环境的案例驱动,远比枯燥的API手册来得更有说服力。
这本《大数据存储MongoDB实战指南》真是让我这个刚踏入NoSQL世界的新手感到醍醐灌顶,尤其是它对MongoDB的架构设计和性能调优部分的讲解,简直是教科书级别的细致。我之前尝试过用MongoDB搭建一些高并发的读写服务,总是遇到各种莫名其妙的慢查询和连接池问题,翻遍了官方文档和网上零散的博客,总感觉抓不住重点。这本书不同,它没有过多地纠缠于MongoDB的历史沿革或者与其他数据库的泛泛对比,而是直接切入实战的痛点。比如,书中关于**分片键(Shard Key)的选择策略**,用好几个实际案例分析了不同业务场景下,选择热点分片键可能导致的写入性能雪崩,以及如何通过预先设计和动态重平衡来规避风险。更让我受益匪浅的是,它对**W(Write Concern)和 R(Read Concern)的深度解析**,清晰地阐述了它们如何在一致性、可用性和性能之间进行权衡,我终于明白了为什么在某些对数据实时性要求不那么苛刻的场景下,适当调高这些参数能带来显著的吞吐量提升,这绝对不是那种简单告诉你“把W设为majority”就完事的肤浅介绍,而是深入到了副本集选举和日志写入机制的底层逻辑。读完这部分,我立刻回去优化了手头的项目,效果立竿见影。
太敷衍了,内容很少,贴了很多代码。
感觉比较水的一本书。前三分一介绍了一下怎么用 mongodb,中间三分一介绍了一下 mongodb 的一些实现思想,后三分一给你撸一个 PHP 的电商例子还给不全代码。 开开眼界还是挺可以的,如果务实一点起名叫《MongoDB 实践笔记》的话。
比较浅显,有个感性认识
一直没读过国人的技术类书籍,jd凑单买了,写的实在太简单,还不如官方文档,这种东西也能出书了
比较浅显,有个感性认识