
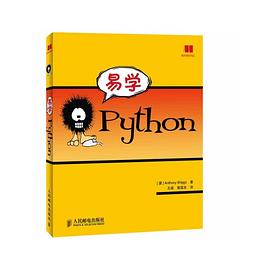

具体描述
《易学python》采用简洁、有趣、易学的方式对python编程语言进行了讲解,其风格与通篇介绍编程特性、罗列语言功能的大多数编程图书不同,而是引导读者带着好奇,带着问题去学习、掌握python编程语言,继而编写真实而有用的程序。
《易学python》总共分为3部分,共12章,第1部分介绍了为何使用python来编程。从第2部分起,通过编写hunt the wumpus游戏带领读者认识并解决编程中的一些实际问题。例如,如何管理复杂的程序,确保其清晰易懂;如何在程序中使用python标准库,以节省编程时间,同时让程序更容易理解;如何对编写好的程序进行测试;如何进行面向对象的程序设计。第3部分则使用框架对书中的程序进行完善,让读者对python的强大功能有一个更深入的认识。本书最后还提供了一些python资源,供读者深入学习python时参考。
无论您是零基础的python初学人员,还是具有其他语言编程经验,但是想从事python开发的人员,《易学python》都将带领您踏上有趣的python学习之路
作者简介
目录信息
1.1 学习编程 2
1.1.1 告诉计算机做什么 2
1.1.2 编程是创意 4
1.1.3 编程是设计 4
1.2 是什么让python如此杰出 5
1.2.1 python简单易学 5
1.2.2 python是真正的语言 5
1.2.3 python“开箱即用” 6
1.2.4 python社区规模庞大 6
1.3 在windows系统上安装python 7
1.3.1 安装python 7
1.3.2 在windows系统上运行python程序 9
1.3.3 从命令行运行python程序 11
1.4 linux 14
1.4.1 在linux系统上安装python 14
1.4.2 linux gui 14
1.4.3 linux命令行 16
1.5 macintosh 16
.1.5.1 更新shell配置文件 17
1.5.2 设置默认应用程序 17
1.6 排除故障 18
1.6.1 语法错误 18
1.6.2 文件扩展名不对(windows) 19
1.6.3 python的安装位置不对(linux) 19
1.7 文本编辑器和ide 19
1.8 总结 20
第2章 hunt the wumpus 21
2.1 程序是什么 22
2.1.1 在屏幕上显示 23
2.1.2 使用变量存储信息 23
2.1.3 询问玩家想做什么 24
2.1.4 做出决策 24
2.1.5 循环 25
2.1.6 函数 26
2.2 您的第一个程序 27
2.2.1 hunt the wumpus的第一个版本 27
2.2.2 调试 29
2.3 捣鼓程序 29
2.3.1 调整洞穴数量 30
2.3.2 更友好的wumpus 30
2.3.3 多个wumpus 30
2.4 创建洞穴 31
2.4.1 列表 31
2.4.2 for循环 33
2.4.3 构造洞穴网络 33
2.5 修复微妙的错误 35
2.5.1 问题 36
2.5.2 解决方案 36
2.5.3 打造连通的洞穴网络 36
2.6 使用函数让代码更整洁 39
2.6.1 函数的基本知识 39
2.6.2 变量作用域 40
2.6.3 共享状态 41
2.7 使用函数组织游戏hunt the wumpus 42
2.7.1 与洞穴交互 42
2.7.2 创建洞穴 43
2.7.3 与玩家交互 44
2.7.4 程序的其他部分 45
2.8 弓和箭 47
2.9 进一步美化 49
2.10 接下来如何做 51
2.10.1 蝙蝠和深渊 52
2.10.2 让wumpus移动 52
2.10.3 不同的洞穴网络 52
2.11 总结 52
第3章 与外部交互 53
3.1 开箱即用:python库 54
3.1.1 python标准库 54
3.1.2 其他库 54
3.1.3 使用库 55
3.1.4 库到底是什么 55
3.2 另一种提问方式 58
3.2.1 使用命令行参数 58
3.2.2 使用模块sys 58
3.3 读写文件 59
3.3.1 路径和目录(我的文件在哪里) 59
3.3.2 路径 61
3.3.3 打开文件 61
3.4 比较文件 63
3.4.1 采集文件的指纹 63
3.4.2 将文件的指纹存储到字典中 64
3.5 综合应用 65
3.6 测试程序 68
3.7 改进脚本 70
3.7.1 按顺序排列结果 70
3.7.2 比较目录 72
3.8 接下来如何做 73
3.9 总结 73
第4章 组织有序 74
4.1 规范程序 74
4.2 如何确定程序是正确的 75
4.2.1 手工测试太烦 75
4.2.2 功能测试 76
4.2.3 单元测试:让计算机去做 76
4.2.4 测试驱动的开发 76
4.3 编写程序 77
4.4 整合程序 80
4.4.1 测试用户界面 80
4.4.2 用输入做什么 81
4.4.3 执行命令 82
4.4.4 运行程序 85
4.5 状况评估 85
4.5.1 接下来做什么 86
4.5.2 我既繁忙又重要 88
4.5.3 列表解析 89
4.5.4 发现bug 92
4.6 存储待办事项清单 95
4.7 编辑和删除 98
4.7.1 修复一个小问题 99
4.7.2 删除待办事项 101
4.7.3 编辑待办事项 103
4.8 接下来如何做 106
4.8.1 帮助命令 106
4.8.2 撤销 106
4.8.3 不同的界面 107
4.8.4 时间管理和估算 107
4.8.5 研究一个单元测试框架 107
4.9 总结 107
第5章 面向业务的编程 109
5.1 让程序相互交流 110
5.1.1 csv来救场 110
5.1.2 其他格式 111
5.2 准备工作 112
5.2.1 安装beautiful soup 112
5.2.2 安装firefox和firebug 113
5.2.3 查看网页 113
5.3 使用python下载网页 115
5.3.1 提取想要的数据 116
5.3.2 进一步提取数据 117
5.3.3 网页抓取的注意事项 119
5.4 写入csv文件 119
5.5 通过电子邮件发送csv文件 121
5.5.1 电子邮件的结构 121
5.5.2 创建电子邮件 122
5.5.3 发送电子邮件 123
5.5.4 其他电子邮件模块 124
5.6 一个简单脚本——哪些地方可能出问题 125
5.6.1 未连接到网络 126
5.6.2 数据无效 126
5.6.3 数据出乎意料 126
5.6.4 无法写入数据 126
5.6.5 无法访问邮件服务器 126
5.6.6 您不必修复这些问题 127
5.7 如何处理有问题的脚本 127
5.7.1 交流 127
5.7.2 对故障的承受力 127
5.7.3 一开始就做好 128
5.7.4 失败要赶早,还要大张旗鼓 128
5.7.5 双保险 128
5.7.6 压力测试和性能测试 129
5.7.7 以后再试 129
5.8 异常 131
5.8.1 为何使用异常 131
5.8.2 程序崩溃是什么意思 131
5.8.3 捕获异常 134
5.8.4 模块traceback 135
5.9 接下来如何做 136
5.10 总结 136
第6章 类与面向对象编程 137
6.1 类是什么 137
6.1.1 类包含数据 138
6.1.2 类是类型 138
6.1.3 类的工作原理 138
6.1.4 您的第一个类 138
6.2 面向对象设计 140
6.3 玩家输入 143
6.4 财宝 146
6.4.1 方法该放在什么地方 146
6.4.2 寻宝 147
6.4.3 捡宝 148
6.5 在洞穴迷宫中漫步 151
6.6 怪物出没 156
6.6.1 创建怪物 156
6.6.2 一些面向对象的技巧 157
6.6.3 组合起来 158
6.7 危险与刺激 161
6.8 接下来如何做 163
6.8.1 增加怪物和财宝 164
6.8.2 扩展格斗方式和物品 164
6.8.3 添加更多冒险元素 164
6.8.4 尝试动词和名词 164
6.8.5 研究类的高级功能 164
6.9 总结 164
第7章 高级技术 166
7.1 面向对象 166
7.1.1 混合类 166
7.1.2 super()及注意事项 169
7.2 定制类 169
7.2.1 __getattr__ 170
7.2.2 __setattr__ 170
7.2.3 __getattribute__ 172
7.2.4 特性(property) 173
7.2.5 模拟其他类型 175
7.3 生成器和迭代器 177
7.3.1 迭代器 177
7.3.2 生成器 179
7.3.3 生成器表达式 180
7.4 使用迭代器 180
7.4.1 读文件 181
7.4.2 处理日志行 183
7.4.3 提取字段 184
7.5 函数式编程 188
7.5.1 副作用 188
7.5.2 map和filter 188
7.5.3 传递和返回函数 189
7.6 接下来如何做 191
7.7 总结 191
第8章 django 192
8.1 使用django编写web应用 193
8.1.1 安装django 193
8.1.2 设置django 193
8.2 编写应用 197
8.2.1 最简单的待办事项清单 197
8.2.2 使用模板 198
8.3 使用模型 201
8.3.1 设置数据库 201
8.3.2 创建模型 201
8.3.3 django模块admin 203
8.3.4 添加管理界面 204
8.4 使用数据 206
8.4.1 使用模型 206
8.4.2 设计url 208
8.4.3 提交表单 210
8.4.4 处理待办事项 213
8.5 最后的优化 216
8.6 接下来如何做 217
8.7 总结 217
第9章 使用pyglet开发游戏 218
9.1 安装pyglet 218
9.2 起步 220
9.3 简单的宇宙飞船 222
9.3.1 让事情发生 224
9.3.2 回到学校:牛顿第一定律及矢量 226
9.4 引力 229
9.4.1 计算引力 229
9.4.2 小心行星 232
9.5 不能缺了枪炮 234
9.6 邪恶的外星人 237
9.7 接下来如何做 242
9.7.1 添加新元素 242
9.7.2 改成别的类型 242
9.7.3 重构 243
9.7.4 获取反馈 243
9.8 总结 243
第10章 twisted网络编程 244
10.1 安装twisted 244
10.2 第一个应用程序 245
10.3 mud初步 249
10.4 让游戏更有趣 254
10.4.1 可恨的怪物 254
10.4.2 回到聊天服务器 256
10.5 要求玩家登录 260
10.5.1 探索不熟悉的代码 260
10.5.2 整合 261
10.5.3 编写自定义状态机 265
10.6 保存玩家状态 269
10.7 接下来如何做 273
10.8 总结 273
第11章 再谈django 274
11.1 身份验证 274
11.1.1 登录 275
11.1.2 添加用户 277
11.2 只列出当前用户的待办事项 278
11.2.1 修复数据库 279
11.2.2 言归正传 282
11.2.3 滴水不漏 283
11.2.4 更新接口 284
11.3 测试 285
11.3.1 单元测试 285
11.3.2 功能测试 287
11.3.3 运行测试 288
11.4 图像和样式 289
11.4.1 使用django提供媒体内容 289
11.4.2 由另一个服务器提供媒体 291
11.4.3 最后一步 292
11.5 接下来如何做 292
11.6 总结 293
第12章 接下来如何做 294
12.1 再阅读一些代码 294
12.1.1 python标准库 295
12.1.2 python秘诀 295
12.1.3 开源项目 295
12.1.4 加入python社区 295
12.1.5 加入邮件列表 295
12.1.6 寻找当地用户组 296
12.1.7 给开源项目帮忙 296
12.2 解决自己遇到的问题 296
12.3 其他python库 297
12.3.1 代码剖析 297
12.3.2 日志 297
12.3.3 子进程和多任务 297
12.3.4 更复杂的分析 297
12.3.5 pil和图像处理 298
12.3.6 xml、elementtree和json 298
12.4 总结 298
· · · · · · (收起)
读后感
用户评价
我对这本书的另一个深刻印象是它对“实战”的重视程度。很多编程书籍可能停留在理论层面,教你语法和概念,但这本书却非常注重将所学知识应用到实际项目中。在讲解完基础知识后,作者会带领读者一步一步地完成几个实际的小项目,比如一个简单的计算器,一个猜数字游戏,甚至是一个小型的数据分析脚本。这些项目的设计都非常贴合初学者的能力范围,但又能够充分展示Python语言的强大之处。在完成这些项目时,作者会详细地解释每一个代码块的作用,以及它们是如何协同工作的。更重要的是,他会鼓励读者去尝试修改代码,添加新的功能,或者优化现有的代码。这种“边学边做”的学习模式,让我能够快速地将理论知识转化为实际操作能力,也让我对Python产生了更深的兴趣。我发现在完成第一个小项目的时候,我真的有一种成就感,那种从零开始构建一个能运行的东西的感觉,是书本上任何文字描述都无法比拟的。
评分这本书的语言风格非常友好和亲切,读起来一点都不觉得枯燥。作者在写作过程中,似乎总能找到一种恰到好处的幽默感,让原本可能有些沉闷的编程知识变得生动有趣。我尤其喜欢他在解释一些容易混淆的概念时,会用一些非常巧妙的比喻。比如,在讲解“可变对象”和“不可变对象”的区别时,作者用了一个“储蓄罐”的比喻,将不可变对象比作储蓄罐里的钱,你只能增加或减少,但无法改变钱本身的价值;而可变对象则像是银行账户,你可以随时增加存款、减少存款,甚至修改存款的用途。这种生动的比喻,让我一下子就明白了它们之间的核心差异,并且在未来的编程中,能够根据对象的特性来选择合适的操作。这种寓教于乐的方式,真的让我觉得学习Python是一件快乐的事情。
评分这本书的排版和设计真是让人眼前一亮,封面色彩搭配和谐,字体选择也相当考究,传递出一种既有学术深度又不失亲和力的感觉。翻开书页,纸张的触感也很好,不是那种廉价的光面纸,而是带有淡淡的纹理,阅读起来不会反光,长时间看也不会觉得眼睛疲劳。目录的设计也清晰明了,每个章节的标题都言简意赅,让人能够快速找到自己感兴趣的内容。而且,每章之间过渡自然,逻辑性很强,不是那种零散的知识点堆砌,而是像一条清晰的河流,带着读者一步步深入Python的世界。我尤其喜欢书中穿插的一些小插画和图示,它们不是那种花哨的装饰,而是真正起到了辅助理解的作用,将一些抽象的概念形象化,让学习过程变得更加生动有趣。例如,在讲解列表和元组的区别时,作者用了一个非常贴切的比喻,让我瞬间就明白了它们的核心差异,这种“润物细无声”的教学方式,比枯燥的文字解释要高效得多。此外,书籍的装订也很牢固,我经常需要将书摊平在桌面上,或者在咖啡馆里抱着阅读,这本书的装订质量让我觉得很放心,不用担心书页脱落的问题。总的来说,这本书在外观和内涵上都做到了很好的平衡,是一本值得细细品味的佳作。
评分从我个人的学习体验来看,这本书的作者非常擅长引导读者思考。在讲解完某个知识点后,他不会立刻给出答案,而是会先抛出一个问题,鼓励读者自己去尝试解决,然后再给出详细的解答和分析。这种“先思考,后学习”的方式,让我能够主动地参与到学习过程中,而不是被动地接受信息。比如,在讲解“函数参数”的时候,作者会先问读者:“如果一个函数需要处理很多相似的操作,有没有更简洁的方法?”引导读者去思考函数的可重用性,然后才引入参数的概念。这种互动式的学习方式,让我觉得学习过程更加投入,也更容易记住知识点。而且,书中还会分享一些作者在实际编程中遇到的问题和解决方案,这些“过来人”的经验对于我来说是非常宝贵的,能够帮助我少走很多弯路,也让我对编程有了更实际的认识。
评分阅读这本书的过程,就像是在与一位耐心且知识渊博的朋友交流。我特别喜欢作者在阐述一些更复杂的概念时,会采用多种不同的角度去解释,确保读者能够从某个角度理解。例如,在讲解函数的时候,作者不仅解释了函数的定义和调用,还花了大量篇幅去说明函数的“封装”和“复用”的意义,以及为什么在大型项目中函数是必不可少的。他会用一个现实生活中的例子,比如“烤蛋糕”,来比喻函数的作用——你只需要把材料交给烤箱(函数),它就能帮你完成整个过程,而不需要知道烤箱内部的每一个细节。这种类比非常生动,让人一下子就能抓住核心思想。而且,书中对每一个代码示例的解释都非常详尽,不仅仅是告诉读者“这样做”,还会解释“为什么这样做”,以及这样做的潜在影响。有时候,我还会发现作者在代码后面留下一些“思考题”或者“挑战”,这些小练习虽然不强制完成,但却能极大地激发我的探索欲,让我主动去思考如何改进代码,或者如何用不同的方式实现同一个功能。这种寓教于乐的学习方式,让我在不知不觉中就掌握了更多的编程技巧。
评分这本书给我的感觉是,作者对Python的理解非常深刻,并且能够用最简洁、最易懂的方式表达出来。我尤其欣赏作者在讲解“数据结构”部分时,对于列表、元组、字典、集合这些不同数据类型的区分和应用场景的讲解。他不仅仅是列出它们的特点,还会通过大量的实例来展示它们各自的优势和劣势。例如,在讲解字典的时候,作者用了一个“学生信息管理”的例子,展示了如何用字典来存储学生的姓名、年龄、成绩等信息,并且可以通过姓名快速查找对应的成绩,这种高效的查找方式让我印象深刻。而且,书中还提到了一些关于数据结构优化的小技巧,虽然只是点到为止,但已经足够激发我对更深入学习的兴趣。让我觉得这本书的价值不仅仅在于教授知识,更在于能够点燃我对编程的热情,让我愿意主动去探索更广阔的编程世界。
评分这本书的附录内容也做得非常用心,不仅仅是简单的术语解释,还包含了一些进阶的学习资源推荐,以及一些常用的Python库的简要介绍。我尤其喜欢作者在附录中整理的“常见问题解答”部分,里面收录了许多我在学习过程中可能遇到的疑问,并且都给出了清晰的解答。比如,关于“Python的版本选择”、“如何安装第三方库”、“如何配置开发环境”等问题,都得到了详细的说明。这对于我这样想要深入学习的读者来说,是非常有价值的。而且,作者还提供了一些他在实际工作中经常使用的库的推荐,比如用于数据分析的 `pandas` 和 `numpy`,用于Web开发的 `Flask` 等,并简单介绍了它们的主要用途。这让我对Python的生态系统有了初步的了解,也为我今后的进一步学习指明了方向。
评分这本书在“面向对象编程”这一块的处理,我觉得是所有我读过的Python入门书籍中最出色的。很多书籍在讲到类和对象的时候,都会写得非常抽象,让人云里雾里。但这本书的作者却用了一个非常生动的“动物园”的比喻,来讲解类和对象的概念。他把“动物园”看作一个大类,而里面的“狮子”、“老虎”、“熊猫”则是这个大类下的子类,每个子类又有自己的特有属性(比如颜色、叫声)和行为(比如奔跑、吼叫)。这样一来,类、对象、继承、封装这些概念就变得非常形象,也容易理解。而且,作者在讲解如何创建类和对象时,都会给出非常具体的代码示例,并且会一步步地解释每一个属性和方法的含义。让我觉得,原来“面向对象”并没有那么难以理解,关键在于找到一个好的切入点。
评分我一直觉得学习编程最大的障碍就是那些晦涩难懂的概念和术语,很多入门教程一开始就抛出大量的专业词汇,让人望而却步。但这本书在这方面做得非常出色,它就像一位经验丰富的向导,循序渐进地引导你认识Python的每一个重要组成部分。作者在解释每一个新概念时,都习惯性地先从一个非常基础的、生活化的例子入手,然后逐渐引申到代码的实际应用。比如,在介绍变量的时候,作者并没有直接讲“变量是存储数据的容器”,而是用“给数据起名字”这样通俗易懂的方式来类比,让人一下子就明白了变量的本质。而且,书中每介绍完一个小的知识点,都会立刻配上相应的代码示例,并且这些示例都非常简洁、清晰,可以直接复制粘贴运行,这对于初学者来说,能够极大地增强学习的信心和动力。我尤其欣赏作者在处理错误信息时的耐心,当代码出现问题时,他会详细地分析错误原因,并给出可能的解决方案,而不是简单地说“这里错了”。这种细致入微的讲解,让我觉得作者真的站在初学者的角度去思考问题,设身处地地为我们考虑,将编程学习的门槛降到了最低。
评分这本书在章节安排上非常有条理,每一部分都是一个循序渐进的台阶。我尤其喜欢作者在处理“循环”和“条件判断”这些基础但至关重要的概念时,花费了大量的篇幅去讲解。他不仅仅是给出 `if`、`else`、`for`、`while` 这些关键字,还会深入剖析它们的逻辑结构,以及在实际编程中如何灵活运用。例如,在讲解 `for` 循环的时候,作者会通过遍历列表、字符串,甚至字典的不同场景来展示它的强大能力。而且,书中对“嵌套循环”的解释也非常到位,用了一个“日历”的例子,来形象地展示如何用嵌套循环来生成每天的日期,这让我一下子就理解了嵌套循环的威力。此外,作者还非常注重培养读者的“调试”能力,在书中会模拟一些常见的编程错误,并指导读者如何通过打印变量值、单步执行等方式来找出问题的根源。这种教学方法,让我觉得不仅仅是在学习Python的语法,更是在学习一种解决问题的思维方式,这对于我未来的编程学习道路非常有益。
评分这本书每一章章末总结总是给我一种感觉:只要这章学好了,就很牛逼了。然而从来没有完整的看懂过一章
评分很有意思的Python入门书
评分很有意思的Python入门书
评分这本书每一章章末总结总是给我一种感觉:只要这章学好了,就很牛逼了。然而从来没有完整的看懂过一章
评分翻译是拿机器直接翻译的吧。
相关图书








本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈图书下载中心 版权所有