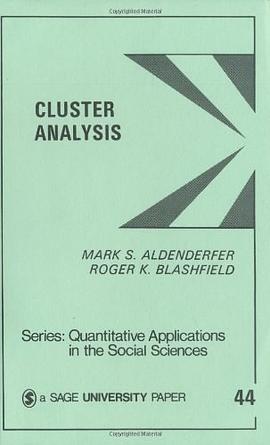
Although clustering -- the classifying of objects into meaningful sets -- is an important procedure, cluster analysis as a multivariate statistical procedure is poorly understood. This volume is an introduction to cluster analysis for professionals, as well as for advanced undergraduate and graduate students with little or no background in the subject. Reaching across disciplines, Aldenderfer and Blashfield pull together the newest information on cluster analysis -- providing the reader with a pragmatic guide to its current uses, statistical techniques, validation methods, and compatible software programmes.
《聚类分析:模式识别与数据挖掘的基石》 引言 在浩瀚的数据海洋中,隐藏着无数有价值的洞察与规律。然而,原始数据的杂乱无章往往令人望而却步,无法直接揭示其内在的结构与关联。此时,一种强大的数据分析工具应运而生,它能够帮助我们从看似无序的数据中提炼出有序的模式,发现潜在的群体,并进一步理解数据背后的逻辑。这便是“聚类分析”,它不仅是统计学与计算机科学领域的重要分支,更是数据挖掘、机器学习、模式识别等诸多前沿学科的基石。 本书《聚类分析:模式识别与数据挖掘的基石》旨在系统、深入地剖析聚类分析的理论体系、算法实现、应用场景以及前沿发展。本书的目标读者涵盖了对数据科学、人工智能、统计学、信息科学等领域感兴趣的研究人员、学生、数据分析师、工程师以及任何希望提升自身数据处理与洞察能力的专业人士。我们将从基础概念出发,逐步引导读者深入理解各种聚类方法的工作原理,掌握如何选择最适合特定问题的聚类算法,并学会如何有效地评估聚类结果的质量。 第一部分:聚类分析基础理论 本部分将为读者构建扎实的聚类分析理论基础。我们将首先阐述聚类分析的核心概念,包括什么是聚类、聚类的目标以及聚类在数据分析流程中的定位。在此基础上,我们将详细介绍用于衡量数据点之间相似性或差异性的各种度量标准。这包括但不限于: 距离度量: 欧氏距离(Euclidean Distance): 最常用的度量,适用于连续型变量,计算公式为 $sqrt{sum_{i=1}^n (x_i - y_i)^2}$。我们将探讨其适用范围与局限性,例如对尺度敏感的问题。 曼哈顿距离(Manhattan Distance / City Block Distance): 计算公式为 $sum_{i=1}^n |x_i - y_i|$。它在某些情况下比欧氏距离更鲁棒,特别是在存在异常值时。 切比雪夫距离(Chebyshev Distance): 计算公式为 $max_i |x_i - y_i|$。它关注数据点在任何一个维度上的最大差异。 闵可夫斯基距离(Minkowski Distance): 欧氏距离和曼哈顿距离的泛化,公式为 $(sum_{i=1}^n |x_i - y_i|^p)^{1/p}$。我们将讨论不同 $p$ 值所对应的距离度量及其特性。 相似性度量: 皮尔逊相关系数(Pearson Correlation Coefficient): 用于衡量两个连续变量之间的线性相关性,其值在 -1 到 1 之间。 余弦相似度(Cosine Similarity): 常用于文本数据或高维稀疏数据,衡量向量之间的角度,其值在 -1 到 1 之间(或 0 到 1,取决于是否处理负值)。 Jaccard 相似系数(Jaccard Index): 用于衡量集合之间的相似性,常用于二元数据或离散数据,计算公式为 $|A cap B| / |A cup B|$。 在理解了度量标准后,我们将深入探讨聚类分析的目标函数。聚类算法的核心任务往往是通过优化一个特定的目标函数来寻找最佳的聚类划分。常见的聚类目标函数包括: 最小化类内距离(Intra-cluster Distance): 目标是使同一簇内的点尽可能彼此靠近。 最大化类间距离(Inter-cluster Distance): 目标是使不同簇之间的点尽可能彼此远离。 优化组合度量: 许多算法的目标函数是类内距离与类间距离的某种组合,例如最大化类间距离与类内距离之比。 最后,本部分将概述聚类分析的分类。根据其算法机制和输出形式,聚类方法可以大致分为以下几类: 划分式聚类(Partitioning Clustering): 将数据集划分为若干个互不重叠的子集(簇)。 层次式聚类(Hierarchical Clustering): 构建一个嵌套的簇的层次结构,通常以树状图(dendrogram)的形式表示。 基于密度的聚类(Density-based Clustering): 识别具有高密度区域的簇,并能发现任意形状的簇,同时能够识别噪声点。 基于模型的聚类(Model-based Clustering): 假设数据是由一个或多个概率分布模型生成的,并试图找到最能拟合数据的模型。 网格(Grid-based)和模糊(Fuzzy)聚类: 其他重要的聚类范式,分别侧重于空间网格和成员度的模糊性。 第二部分:经典聚类算法详解 本部分将聚焦于一系列在理论研究和实际应用中具有广泛影响力的经典聚类算法。我们将详细介绍它们的工作原理、算法步骤、优缺点以及适用场景。 划分式聚类算法: K-Means 算法: 原理: 迭代地将数据点分配到最近的簇中心(均值),然后更新簇中心。 算法步骤: 初始化 $k$ 个簇中心 -> 分配数据点 -> 更新簇中心 -> 重复直到收敛。 优缺点: 算法简单、效率高,易于实现。但对初始簇中心敏感,易陷入局部最优,只能发现球状簇,对异常值敏感,且需要预先指定簇的数量 $k$。 变种: K-Medoids (PAM) 算法,它使用簇内实际数据点作为簇中心,对异常值更鲁棒。 K-Medoids (PAM) 算法: 原理: 选择 $k$ 个数据点作为簇中心(medoids),然后将每个非中心点分配到距离其最近的 medoid。通过交换 medoid 和非 medoid 来优化聚类目标函数(最小化簇内总距离)。 优缺点: 相较于 K-Means,PAM 对异常值更鲁棒,因为簇中心是实际数据点。但计算复杂度较高。 层次式聚类算法: 凝聚型(Agglomerative)层次聚类: 原理: 从每个数据点自成一簇开始,迭代地合并最相似的两个簇,直到所有数据点都归为一个簇。 链式(Linkage)准则: 单链(Single Linkage): 两个簇之间的距离等于它们最近的点之间的距离。易产生“链式效应”。 全链(Complete Linkage): 两个簇之间的距离等于它们最远的点之间的距离。倾向于发现紧凑的球状簇。 平均链(Average Linkage): 两个簇之间的距离等于它们所有点对之间距离的平均值。 Ward 方差最小化(Ward's Method): 合并两个簇以最小化合并后产生的簇内方差增加量。 优缺点: 不需要预先指定簇的数量,可以获得多层次的聚类结构,易于可视化(通过树状图)。但计算复杂度较高,尤其是在处理大规模数据集时。 分裂型(Divisive)层次聚类: 原理: 从所有数据点归为一个簇开始,迭代地将簇分裂为更小的簇,直到每个数据点自成一簇。 基于密度的聚类算法: DBSCAN (Density-Based Spatial Clustering of Applications with Noise): 原理: 识别高密度区域作为簇,能够发现任意形状的簇,并能够有效识别噪声点。 核心概念: 核心点(Core Point): 邻域内至少有 MinPts 个点的点。 边界点(Border Point): 位于核心点邻域内,但自身不是核心点的点。 噪声点(Noise Point): 既不是核心点也不是边界点的点。 参数: $epsilon$(邻域半径)和 MinPts(邻域内最小点数)。 优缺点: 能够发现任意形状的簇,对噪声点不敏感,不需要预先指定簇的数量。但对参数选择敏感,且在密度不均匀的数据集上表现不佳。 OPTICS (Ordering Points To Identify the Clustering Structure): 原理: DBSCAN 的扩展,通过对点进行排序来解决密度不均匀的问题,并能识别不同密度的簇。 优缺点: 能处理密度变化的数据集,并能为不同密度级别的数据生成聚类。 基于模型的聚类算法: 高斯混合模型(Gaussian Mixture Model, GMM): 原理: 假设数据由多个高斯分布的混合体生成。通过期望最大化(EM)算法来估计每个高斯分布的参数(均值、协方差)以及每个数据点属于各分布的概率。 优缺点: 能够发现椭圆形簇,并提供数据点属于各个簇的概率(软聚类)。但假设数据服从高斯分布,对初始参数敏感。 第三部分:聚类结果的评估与选择 仅仅执行聚类算法并不能保证获得有意义的结果。如何评估聚类结果的质量,并选择最优的聚类方案,是聚类分析中至关重要的一环。本部分将介绍多种评估方法。 内部评估指标(Internal Evaluation Metrics): 轮廓系数(Silhouette Coefficient): 衡量一个点与其自身簇的紧密度以及与最近邻簇的分离度。值越接近 1 表示聚类效果越好。 Davies-Bouldin 指数(Davies-Bouldin Index): 衡量簇内离散度和簇间分离度之比的平均值。值越小表示聚类效果越好。 Calinski-Harabasz 指数(Calinski-Harabasz Index / Variance Ratio Criterion): 衡量簇间方差与簇内方差之比。值越大表示聚类效果越好。 外部评估指标(External Evaluation Metrics): 当存在“真实标签”时使用,用于衡量聚类结果与真实标签的一致性。 调整兰德指数(Adjusted Rand Index, ARI): 衡量两个聚类划分的相似度,考虑了随机性。值越接近 1 表示一致性越高。 互信息(Mutual Information, MI)及其调整版本(Adjusted Mutual Information, AMI): 衡量两个聚类划分共享的信息量。 Fowlkes-Mallows 指数(Fowlkes-Mallows Index): 衡量两个聚类划分的相似度。 如何选择簇的数量 $k$: 肘部法则(Elbow Method): 绘制不同 $k$ 值下的类内平方和(Within-Cluster Sum of Squares, WCSS),选择 WCSS 下降速率趋于平缓的点(“肘部”)。 轮廓系数最大化: 选择轮廓系数最大的 $k$ 值。 业务需求驱动: 实际应用中的业务目标往往是决定簇数量的关键因素。 第四部分:聚类分析的应用领域与进阶 聚类分析作为一种通用的数据分析工具,在众多领域都有着广泛的应用。本部分将展示聚类分析如何在不同场景下发挥价值,并介绍一些进阶的概念与技术。 应用领域: 市场细分(Market Segmentation): 根据消费者的行为、偏好等将客户划分为不同的群体,以便进行精准营销。 图像分割(Image Segmentation): 将图像划分为不同的区域,以便进行对象识别或图像处理。 文档聚类(Document Clustering): 将相似主题的文档归类,便于信息检索和管理。 生物信息学(Bioinformatics): 基因表达数据分析、蛋白质功能分类等。 异常检测(Anomaly Detection): 将正常数据点聚类,将远离任何簇的点识别为异常。 推荐系统(Recommender Systems): 根据用户的兴趣相似性进行分组,推荐内容。 社交网络分析(Social Network Analysis): 识别社群、用户群体等。 地理空间数据分析(Geospatial Data Analysis): 识别犯罪热点、污染区域等。 进阶主题: 高维数据聚类(Clustering High-Dimensional Data): 挑战与策略,如子空间聚类、降维技术(PCA, t-SNE)在聚类前的应用。 大数据的聚类(Clustering Big Data): 针对海量数据的分布式聚类算法(如 MapReduce 框架下的 K-Means),近似聚类方法。 增量聚类(Incremental Clustering): 在数据不断增加时,无需重新处理整个数据集,即可更新聚类模型。 半监督聚类(Semi-supervised Clustering): 结合少量有标签信息来指导聚类过程。 聚类结果的可视化(Visualization of Clustering Results): 利用散点图、树状图、热力图等技术直观展示聚类结构。 结论 《聚类分析:模式识别与数据挖掘的基石》一书,从理论到实践,系统地涵盖了聚类分析的方方面面。本书不仅是对现有聚类方法的梳理与总结,更旨在启发读者在面对复杂数据时,能够运用恰当的聚类工具,洞察数据之美,挖掘价值之蕴。掌握聚类分析,意味着掌握了理解数据结构、发现隐藏模式、做出明智决策的关键能力。希望本书能够成为您在数据科学探索之旅中的得力助手,引领您在数据驱动的时代,取得更辉煌的成就。