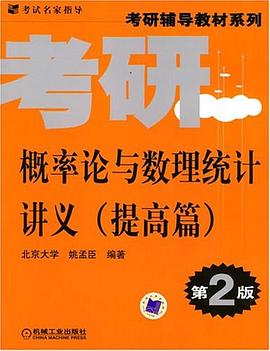
《概率论与数理统计讲义(提高篇)》是工学类、经济和管理学类硕士研究生入学考试科目“概率论与数理统计”的应试指导书,它是作者多年来在全国各地考研辅导班(提高班)的讲稿基础上整理而成的。
《概率论与数理统计讲义(提高篇)》作者多年在全国各地考研辅导班(提高班)上讲课,具有丰富的教学经验,深知考生的疑难与困惑,因而《概率论与数理统计讲义(提高篇)》能紧扣考试大纲,贴切考试实践,在每一讲编制了知识网络图和考核要求,有针对性地对重点、难点内容进行多侧面、多角度的剖析,同时对考核要点提出问题请考生思考,对典型例题用多种解法进行讲解,以开拓学生思路,从而迅速提高考生在做习题以及实际应用方面分析、解决问题的能力。
《概率论与数理统计讲义(提高篇)》可作为工学类、经济和管理类硕士研究生入学考试数学一、三、四“概率论与数理统计”考研辅导班(提高班)的辅导用书或教学参考书,也可作为理工类、经济管理类的本科生及数学工作者的学习用书或参考书。
《统计智慧:从数据到洞察的科学之旅》 序言 在信息爆炸的时代,数据无处不在,它们以惊人的速度生成、积累,并以前所未有的方式影响着我们的决策。从科学研究的严谨论证,到商业领域的市场洞察,再到日常生活的个性化推荐,统计学的力量渗透到各个角落。然而,面对海量的数据,我们需要的不仅仅是收集和整理,更重要的是理解它们背后的规律,从中提炼出有价值的信息,最终转化为指导行动的智慧。《统计智慧:从数据到洞察的科学之旅》正是为了引领读者踏上这场探索数据奥秘、解锁智慧的旅程而创作。 本书并非一本枯燥的理论堆砌,而是一次引人入胜的思维训练。它旨在帮助读者构建一套坚实的统计学思维框架,理解数据是如何被“阅读”和“解读”的,以及如何利用统计工具来审慎地评估不确定性,做出更明智的判断。我们将一同深入探索统计学的核心概念,学习如何从看似杂乱无章的数据中发现模式、揭示趋势,并最终构建模型来预测未来。 第一章:数据的语言——量化世界的基石 在任何科学探索的起点,都离不开对“数据”的理解。本章将从最基础的概念出发,揭示数据在我们认识世界中所扮演的角色。我们将探讨数据的分类:是离散的计数,还是连续的测量?是定性的描述,还是定量的指标?理解数据的本质,是后续所有统计分析的前提。 变量的类型:我们将区分定性变量(如性别、颜色)和定量变量(如身高、温度)。定量变量又可细分为离散变量(可计数,如班级人数)和连续变量(可测量,如长度、时间)。这种区分对于选择合适的统计方法至关重要。 数据的尺度:我们还会了解数据的测量尺度,包括定类尺度(分类)、定序尺度(排序)、定距尺度(等距但无绝对零点,如温度)和定比尺度(等距且有绝对零点,如身高、体重)。不同的尺度决定了我们能进行的数学运算和统计推断的范围。 数据来源与收集:数据的质量直接影响分析结果的可靠性。本章将简要介绍数据产生的不同途径,以及在数据收集过程中可能遇到的偏差和陷阱,强调严谨的数据收集过程是建立信任的基础。 第二章:数据的画像——描绘与概览 仅仅拥有数据是远远不够的,我们需要学会如何“看懂”数据。本章将聚焦于描述性统计,教会读者如何用简洁的语言和直观的图形来描绘数据的整体特征。这就像为数据绘制一张肖像,让我们能够快速掌握其核心样貌。 集中趋势的度量:我们将深入理解均值、中位数和众数。均值作为最常用的平均值,在何时适用,何时又可能被极端值误导?中位数如何作为不受极端值影响的稳健指标?众数又在描述分类数据时发挥怎样的作用? 离散程度的度量:数据的分散程度同样重要。我们将学习方差和标准差,它们如何量化数据相对于均值的散布情况?我们会探讨极差和四分位数间距,它们能提供哪些关于数据分布范围的信息? 图形化展示:直观的图形是理解数据的利器。本书将介绍直方图、箱线图、散点图等常用图表。如何根据数据类型选择合适的图表?如何从图表中解读数据的分布形态、对称性、偏度以及是否存在异常值? 数据分布的形态:我们将开始接触不同类型的数据分布,例如正态分布的“钟形曲线”。理解数据的分布特征,是进行后续推断性统计的基础。 第三章:不确定性的度量——概率的尺度 现实世界充满了不确定性。概率论正是研究这种不确定性规律的学科。本章将带领读者走进概率的世界,学习如何量化随机事件发生的可能性,并建立起理解随机现象的语言。 概率的基本概念:我们将定义随机事件、样本空间和概率。事件的并集、交集、互斥事件等概念将帮助我们理解事件之间的关系。 条件概率与独立性:在已知某些信息的情况下,事件发生的概率会发生变化吗?我们将学习条件概率,以及如何判断两个事件是否相互独立。这对于理解因果关系和进行预测至关重要。 随机变量与概率分布:我们将引入随机变量的概念,它是将随机事件的结果数值化的工具。我们将探讨离散型随机变量的概率质量函数(PMF)和连续型随机变量的概率密度函数(PDF),以及它们的累积分布函数(CDF)。 重要的离散分布:我们将介绍几个重要的离散概率分布,如二项分布(描述固定次数独立试验中成功的次数)、泊松分布(描述在固定时间或空间内发生的事件数量)。 重要的连续分布:我们将重点讲解正态分布,它是自然界和许多统计模型的基础。此外,我们还会触及均匀分布、指数分布等。 第四章:从样本到整体——统计推断的桥梁 我们通常无法获得关于整体(总体)的全部信息,只能通过抽取样本来推测总体。统计推断的核心任务就是利用有限的样本信息,对未知但固定的总体参数做出合理的推断。本章将构建这座连接样本与整体的桥梁。 抽样的艺术:随机抽样是统计推断的基石。我们将讨论简单随机抽样、分层抽样、整群抽样等常用抽样方法,并理解它们如何影响推断的有效性。 点估计的精度:如何利用样本统计量(如样本均值)来估计总体参数(如总体均值)?我们将探讨估计量的性质,如无偏性、有效性,并学习如何计算估计量的标准误差。 区间估计的审慎:单一点估计往往不够,我们需要一个范围来表示我们对总体参数的信心。我们将学习置信区间的概念,理解置信水平的含义,并掌握如何构建均值、比例的置信区间。置信区间提供了对未知总体参数的一个“可能范围”。 假设检验的逻辑:当我们需要对关于总体的某个断言(假设)进行验证时,就需要用到假设检验。我们将学习零假设和备择假设的设定,以及如何通过样本数据来做出拒绝或不拒绝零假设的决策。P值的概念及其解读将是本章的重点,它帮助我们量化检验结果的证据强度。 第五章:关系的力量——探索变量间的联系 在现实世界中,变量很少孤立存在,它们之间常常存在着千丝万缕的联系。本章将聚焦于探索变量之间的关系,学习如何量化和描述这种联系,从而更深入地理解数据背后的机制。 相关性:并非因果:我们将学习相关系数,如皮尔逊相关系数,它如何衡量两个定量变量之间的线性关系强度和方向。我们会强调相关性不等于因果性,避免从相关性推断出错误的因果关系。 回归分析:预测与解释:回归分析是量化和描述变量之间关系的最有力工具之一。我们将从最简单的简单线性回归开始,学习如何建立一个模型来预测一个变量(因变量)如何随另一个变量(自变量)的变化而变化。 模型构建与评估:我们将学习如何拟合回归直线,理解回归系数的含义,并学习如何评估回归模型的拟合优度,如决定系数R²。还会讨论残差分析,以检验模型的假设条件。 多重回归的扩展:现实中的关系往往更为复杂,涉及多个自变量。我们将简要介绍多重线性回归,展示如何同时考虑多个因素对因变量的影响。 第六章:比较的艺术——差异的意义 在科学研究和实际应用中,我们常常需要比较不同组别、不同处理或不同时间点的数据,以判断它们之间是否存在统计学上的显著差异。本章将教会我们如何进行严谨的比较。 t检验:小样本的利器:我们将学习独立样本t检验和配对样本t检验,它们用于比较两组均值是否存在显著差异。理解t统计量和自由度的意义,以及如何根据P值做出判断。 方差分析(ANOVA):多组比较的通用框架:当需要比较三个或更多组的均值时,ANOVA便显得尤为重要。我们将学习单因素方差分析的基本原理,理解F统计量是如何度量组间变异与组内变异的比例的。 非参数检验的补充:在数据不满足参数检验的假设时,非参数检验提供了另一种选择。我们将简要介绍一些常用的非参数检验,如秩和检验,以拓宽比较的工具箱。 第七章:模型的世界——构建与验证 在本章中,我们将进一步深化对统计模型的理解,学习如何构建更复杂、更具解释力的模型,并理解模型验证的重要性。 广义线性模型(GLM)的初步接触:对于非正态分布的因变量(如计数数据、二元数据),传统的线性回归模型可能不再适用。我们将初步介绍广义线性模型(GLM)的思想,它通过链接函数和指数族分布来扩展线性模型的适用范围,例如逻辑回归在分类问题中的应用。 模型选择与正则化:在构建多变量模型时,如何选择最合适的变量组合?我们将讨论一些模型选择的原则和方法,例如逐步回归。同时,我们还会简要提及正则化技术(如Lasso、Ridge),它们在防止过拟合和选择重要变量方面发挥着关键作用。 交叉验证:评估模型的泛化能力:如何确保我们构建的模型不仅在训练数据上表现良好,也能在未见过的新数据上具有良好的预测能力?交叉验证技术将是本章的重点,它帮助我们更客观地评估模型的泛化能力。 模型诊断与改进:模型构建并非一劳永逸,对模型的诊断和持续改进是科学研究的重要环节。我们将回顾模型诊断的关键方面,并讨论如何根据诊断结果来改进模型。 第八章:数据的未来——预测与决策 统计学的最终目标往往是为了指导未来的行动。本章将聚焦于利用已建立的模型来做出预测,并在不确定性的环境中进行明智的决策。 预测区间与置信区间的区别:在进行预测时,我们不仅需要估计未来值的期望值,还需要评估预测的不确定性。我们将区分预测区间和置信区间,理解它们各自的含义和用途。 时间序列分析简介:当数据具有时间依赖性时,我们可能需要专门的时间序列分析方法。本章将初步介绍时间序列的概念,如趋势、季节性和周期性,以及一些简单的预测模型,如移动平均模型。 贝叶斯统计的视角:在传统统计学(频率学派)之外,贝叶斯统计提供了另一种理解概率和进行推断的视角。我们将简要介绍贝叶斯推断的基本思想,即如何利用先验信息和观测数据来更新信念,做出更优的决策。 统计思维在决策中的应用:本章将结合前几章的知识,讨论统计学思维如何在风险评估、假设检验、模型选择等各个环节中,为复杂决策提供有力的支持。 结语 《统计智慧:从数据到洞察的科学之旅》的旅程至此告一段落。我们相信,通过对本书内容的学习和实践,读者不仅能够掌握统计学的基本理论和方法,更重要的是能够培养一种基于数据的审慎思维模式,学会用科学的眼光去审视世界,在不确定性中发现确定性,在纷繁的数据中提炼出宝贵的洞察。统计学不是终点,而是通往更深层理解和更明智决策的起点。愿这本书能成为您在数据时代探索未知、解锁智慧的得力伙伴。