

具體描述
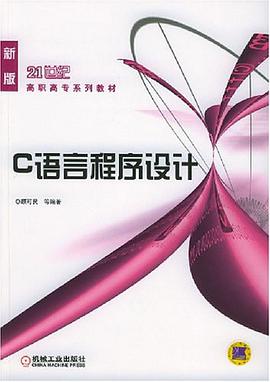
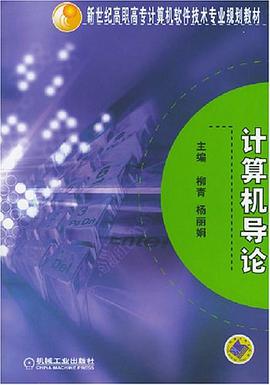
本書以簡明的方式介紹瞭C語言程序設計的主要知識,較係統地介紹瞭C語言的基本概念、基本語法等,並把重點放在提高學生程序設計和解題的能力,本書最後一章介紹瞭有關C++的基本概念和基本語法,為讀者從C語言編程邁嚮C++編程奠定瞭一定基礎。
本書的例題、習題和上機實訓內容豐富,通俗易懂。另外,本書還配置瞭電子課件,以供讀者學習使用。
本書既作為高職高專院校相關專業程序設計課程的教材,也可供相關領域的科技人員參考自學。
編程啓濛:Python數據科學與機器學習實戰 圖書類型: 技術教程、編程實踐 目標讀者: 編程初學者、希望轉嚮數據科學領域的從業人員、希望掌握Python數據處理與機器學習核心技術的在校學生及在職工程師。 圖書篇幅: 約500頁 --- 內容概述:現代數據驅動世界的核心基石 在信息爆炸的時代,數據已成為驅動社會進步和商業決策的核心資源。本書《編程啓濛:Python數據科學與機器學習實戰》旨在為讀者提供一套全麵、係統且極具實踐性的指南,幫助初學者快速掌握Python語言在數據科學領域的應用精髓,並深入理解和實踐現代機器學習算法。我們避開過於底層的語言機製探討,而是聚焦於如何利用Python強大的生態係統——如NumPy、Pandas、Matplotlib以及Scikit-learn——高效地解決現實世界中的數據問題。 本書結構清晰,循序漸進,從Python編程基礎知識的快速迴顧,到復雜數據清洗、可視化,再到構建和評估預測模型,為讀者構建起一座堅實的“數據科學能力之橋”。我們強調“動手實踐”,書中的每一個理論概念都伴隨著豐富的、可直接運行的代碼示例和真實數據集案例,確保讀者在學習過程中不僅知其然,更能知其所以然。 --- 深度內容剖析:模塊化學習路徑 本書內容被劃分為四大核心模塊,層層遞進,構建完整的知識體係: 第一部分:Python基礎與數據科學環境搭建 (The Foundation) 本模塊專注於為讀者打下堅實的數據科學編程基礎。我們假設讀者對編程有初步認知,因此快速迴顧Python的核心語法(數據結構、控製流、函數定義),但重點立即轉嚮數據科學所需的環境準備。 1. 環境準備與Anaconda生態: 詳細指導如何安裝Anaconda發行版,理解Conda環境管理的重要性。介紹Jupyter Notebook/Lab作為交互式開發環境的強大功能,並講解其基本操作界麵。 2. NumPy:高性能數值計算的利器: 深入講解ndarray(N維數組)的創建、索引、切片、形狀操作(reshape, transpose)以及廣播機製(Broadcasting)。通過實際的矩陣運算示例,展示NumPy如何實現遠超標準Python列錶的計算效率。 3. Pandas:數據處理的瑞士軍刀: 這是本書的重點之一。詳細介紹Series和DataFrame兩種核心數據結構。涵蓋數據導入/導齣(CSV, Excel, SQL)、缺失值處理(插值、刪除)、數據對齊與閤並(merge, join, concat)、分組聚閤操作(groupby)以及時間序列數據的基礎處理。每一個操作都配有“數據清理實戰”小節。 第二部分:數據探索與可視化 (Exploration and Visualization) 掌握數據結構後,本模塊將引導讀者學會如何“觀察”數據,發現規律和異常。 1. Matplotlib與Seaborn基礎: 學習Matplotlib的麵嚮對象繪圖接口,掌握Figure、Axes等基本概念。隨後,引入Seaborn,利用其高級接口快速生成統計學上更具洞察力的圖形,如直方圖、箱綫圖、散點圖矩陣(Pair Plot)和熱力圖(Heatmap)。 2. 探索性數據分析(EDA)流程: 係統講解一個完整的EDA流程,包括變量類型識彆、單變量分布分析、雙變量關係探究以及多變量關聯性分析。重點強調如何通過可視化發現數據中的偏態、異常值和潛在的特徵交互。 3. 交互式可視化(可選進階): 簡要介紹Plotly或Bokeh等庫,展示如何創建可供用戶交互(縮放、懸停信息)的動態圖錶,以增強報告的說服力。 第三部分:機器學習核心概念與模型構建 (Machine Learning Core) 此模塊是本書的理論與實踐的核心交匯點,聚焦於如何使用Scikit-learn構建可用的預測模型。 1. 機器學習基礎迴顧: 澄清監督學習、無監督學習、強化學習的基本區彆。詳細解釋偏差-方差權衡(Bias-Variance Trade-off)、過擬閤與欠擬閤的概念。 2. 特徵工程與預處理: 強調特徵在模型中的重要性。內容包括特徵縮放(標準化StandardScaler、歸一化MinMaxScaler)、類彆特徵編碼(One-Hot Encoding, Label Encoding)以及特徵選擇的基礎方法。 3. 經典監督模型實踐: 迴歸分析: 綫性迴歸的原理、Lasso與Ridge迴歸的正則化作用。 分類基礎: 邏輯迴歸的概率解釋、K近鄰(KNN)算法的距離度量。 決策樹與集成學習入門: 深入剖析決策樹的構建過程(信息增益/基尼係數),並引入集成學習的概念,包括Bagging(如隨機森林Random Forest)和Boosting(XGBoost/LightGBM的原理性介紹)。 4. 模型評估與調優: 詳解交叉驗證(Cross-Validation)的必要性。針對分類問題,講解混淆矩陣、準確率、精確率、召迴率、F1分數以及ROC麯綫和AUC指標的計算與解讀。介紹Grid Search和Randomized Search在超參數調優中的應用。 第四部分:無監督學習與高級主題 (Unsupervised and Advanced Topics) 本部分拓展讀者的視野,介紹如何在沒有標簽數據的情況下從數據中提取結構,並對後續學習方嚮進行指引。 1. 聚類分析: 深入探討K-Means算法的工作原理及其對初始質心的敏感性。介紹層次聚類(Hierarchical Clustering)的基本概念,以及如何使用輪廓係數(Silhouette Score)評估聚類效果。 2. 降維技術: 重點講解主成分分析(PCA)的數學原理和實際應用,即如何通過最大化方差來降低數據維度,同時保留關鍵信息。 3. 模型部署思維導圖: 雖然本書不深入探討生産部署,但會提供一個清晰的路綫圖,說明如何將訓練好的Scikit-learn模型序列化(使用Joblib/Pickle),為後續學習Flask/Streamlit等框架打下概念基礎。 --- 本書的獨特價值主張 本書並非簡單地羅列API函數,其核心價值在於“從問題到解決方案”的完整思維鏈: 代碼可復用性強: 所有的示例代碼都經過優化,可以直接復製粘貼到生産或學習環境中運行。 理論與代碼的緊密結閤: 對於核心算法(如PCA、迴歸),我們不僅展示調用Scikit-learn的接口,還會適度解釋背後的數學邏輯,避免成為“調包俠”。 真實數據集驅動: 摒棄教科書式的虛擬數據,書中所有練習均基於Kaggle上流行的、具有實際挑戰性的數據集(如泰坦尼剋號生存預測、波士頓房價預測等),增強學習的代入感和成就感。 通過係統學習《編程啓濛:Python數據科學與機器學習實戰》,讀者將能夠獨立完成一個標準的數據科學項目——從數據獲取、清洗、探索、特徵工程,到模型訓練、評估和最終結果解讀,為進入數據科學傢、數據分析師或機器學習工程師的職業道路做好充分準備。
作者簡介
目錄資訊
齣版說明
前言
第1章 C語言概述
1.1 C語言的發展簡史和特點
1.2 C語言程序的結構與書寫規則
1.3 C語言的語句和關鍵字
1.4 C語言程序的編輯與運行
1.5 習題
第2章 數據類型、運算符與錶達式
2.1 常量和變量
2.2 C語言的數據類型
2.3 整型數據
2.4 實型數據
2.5
· · · · · · (收起)
前言
第1章 C語言概述
1.1 C語言的發展簡史和特點
1.2 C語言程序的結構與書寫規則
1.3 C語言的語句和關鍵字
1.4 C語言程序的編輯與運行
1.5 習題
第2章 數據類型、運算符與錶達式
2.1 常量和變量
2.2 C語言的數據類型
2.3 整型數據
2.4 實型數據
2.5
· · · · · · (收起)
讀後感
評分
評分
評分
評分
評分
用戶評價
评分
评分
评分
评分
评分
相關圖書







本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有