
具体描述
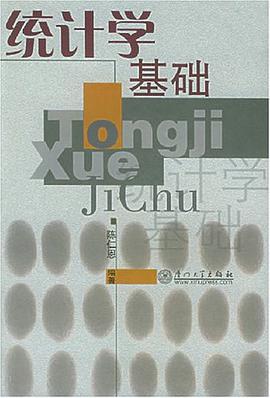
统计是人们认识社会、自然和客观世界的重要方法。统计为宏观的经济调控、微观的经济管理,提供信息、咨询、监督等多功能服务,各行各业的业务活动都离不开统计。经济建设愈发展,统计工作愈需要加强;科学技术愈进步,统计知识的作用也愈广泛。本书概念严谨、体系完整、内容科学、前后连贯、脉胳清楚、简明扼要、通俗易懂、便于自学。本书对于经济管理院校的专科、本科,都是一本合适的教材。本书还可作为社会学、行政学、新闻学等专业学习统计学的选读教材,也可以作为广大经济管理人员、统计干部培训的参考书。
本书内容包括:统计总论、统计调查、统计整理、综合指标、抽样推断、相关分析、指数分析、时间序列分析和统计综合评价方法等,适合高职高专院校经济管理类专业学生使用。
作者简介
陈仁恩,1937年出生,福建福清人。1959年厦门大学经济系统计学专业毕业,留校任教。曾任夏大计统系副主任、《中国经济问题》和 《经济资料译丛》编委、副福建省统计学会常务理事。现为夏大计统系教授、厦门市统计学会副会长。 长期从事基础统计学教学与研究,发表论文数十篇。
目录信息
第一节 统计学的对象和性质
第二节 统计学的方法
第三节 统计学的基本范畴
思考与练习
第二章 统计调查
第一节 统计调查的意义和种类
第二节 统计调查方案
第三节 统计调查方法
思考与练习
第三章 统计整理
第一节 统计整理的意义和方法
第二节 统计分组
第三节 统计分布
第四节 统计表
思考与练习
第四章 综合指标
第一节 总量指标
第二节 相对指标
第三节 平均指标
第四节 变异指标
思考与练习
第五章 抽样推断
第一节 抽样推断的一般问题
第二节 抽样误差
第三节 抽样估计的方法
第四节 假设检验
第五节 抽样组织及其误差
思考与练习
第六章 相关与回归分析
第一节 相关的意义和种类
第二节 相关图表和相关系数
第三节 回归分析
思考与练习
第七章 统计指数
第一节 指数的意义和种类
第二节 综合指数和平均指数
第三节 几种经济指数的编制
第四节 指数体系与因素分析
第五节 指数数列的运用
思考与练习
第八章 时间数列分析
第一节 时间数列的意义和种类
第二节 时间数列的水平分析指标
第三节 时间数列的速度分析指标
第四节 时间数列影响因素测定
思考与练习
第九章 综合评价与综合分析
附录一 调查表格
附录二 随机数表
附录三 正态分布概率表
附录四 t分布的临界值表
附录五 相关系数临界值表
附录六 平均增长速度累计法查对表
习题答案
参考书目
· · · · · · (收起)
读后感
用户评价
这本书的封面设计得很朴素,那种米白色的封皮,摸上去有点粗糙的质感,字体是深蓝色的宋体,给人一种很传统、很踏实的感觉。我本来是抱着试试看的心态买的,毕竟现在市面上讲“基础”的书太多了,很多都流于表面或者把概念复杂化。翻开第一章,我立刻发现这个作者的思路非常清晰,他没有一开始就抛出那些让人头疼的公式,而是用了很多日常生活的例子来引入概率论的概念。比如,他讲到彩票中奖的概率时,会详细分析每一步的决策过程,而不是简单地给一个数字。我记得有一个章节专门讲了“中心极限定理”,通常这是教科书里的重灾区,但这位作者竟然能用一个面包店每天卖出面包数量的波动来解释这个理论,让我一下子就理解了它的实际意义。这种把抽象概念“具象化”的能力,是这本书最吸引我的地方。它不像很多教材那样,只是把知识点堆砌在一起,而是真正地在引导读者去思考统计思维的底层逻辑。读完前几章,我感觉自己对“随机性”的理解都深刻了不少,不再是那种模糊的概念,而是有了一个可以操作的分析框架。
这本书的排版设计可以说是相当“反潮流”了。字体间距有些局促,页边距也窄得可怜,导致整本书看起来信息密度非常大,有时候需要眯着眼睛才能看清那些密密麻麻的符号。不过,一旦你适应了这种排版风格,你会发现它在内容组织上极其高效。特别是它对“方差分析”(ANOVA)的讲解,简直是教科书级别的典范。作者没有把ANOVA写成一个孤立的工具,而是巧妙地把它放在了“模型比较”的大背景下进行阐述。他通过对比“只用平均值”和“使用因子”来解释方差的分解,逻辑链条异常完整。更让我印象深刻的是,书中穿插了许多历史典故,比如谁在什么时候发现了某种统计方法,以及当时的研究背景是什么。这使得这本书不仅仅是一堆公式和算法的集合,更像是一部微缩的统计学发展史,让我对这些方法的产生有了更深的情感连接,理解了它们是如何一步步从经验判断演化成科学工具的。
我买这本书主要是因为工作需要,我所在的行业对数据敏感度要求很高,但我的数学背景并不扎实。我本来担心里面的数学符号和公式会让我望而却步。然而,这本书的叙事方式非常友好,它似乎有一种魔力,能把复杂的数学推导过程“翻译”成日常语言。比如,在讲解回归分析时,作者花了大量的篇幅去解释“最小二乘法”背后的几何直觉,而不是直接给出矩阵代数。他用了一个想象中的“点云”图,然后解释我们是如何找到那条“最贴合”的线的,这个过程描述得生动有趣,甚至带有一丝艺术感。我记得我是在一个周末的下午,坐在阳台上读完那几章的,阳光正好,读到那个地方时,我忍不住停下来喝了口咖啡,感觉自己好像突然打开了一扇通往数据世界的门。这本书的叙述节奏控制得极好,张弛有度,绝不会让人在某个知识点上卡太久,它总能适时地给出“喘息”的机会,让你消化完再继续前进。
说实话,这本书的装帧质量实在不敢恭维,拿到手里感觉挺轻薄的,纸张也偏黄,油墨味儿有点重,翻起来嘎吱作响,简直像是上个世纪八十年代的印刷品。但奇妙的是,内容却让我爱不释手。我最欣赏的是它对统计推断部分的讲解,那种深入骨髓的严谨性。它没有回避那些棘手的问题,比如P值在实际应用中经常被误解的现象,作者专门用了一个小节来“批判性地审视”P值,并且给出了替代的思路,这在很多入门读物中是看不到的。我以前总是在做假设检验的时候感到心虚,总觉得好像哪里没搞明白,但读完这一章后,我对“零假设”和“备择假设”之间的关系有了一种全新的认识。它没有直接告诉我“该怎么做”,而是告诉我“为什么要这么做”,以及“如果不这么做会有什么后果”。这种哲学层面的探讨,让这本书远超了一本单纯的工具书的范畴,更像是一部统计学的“心法秘籍”。尽管书的物理形态不尽人意,但其精神内核的厚重感是压倒性的。
我是在一个朋友的强烈推荐下入手的这本,他告诉我,这本书的价值在于它教会你如何“提出正确的问题”,而不是只教会你“如何计算答案”。我对这一点深表赞同。这本书在描述性统计学部分,几乎没有提供任何现成的计算软件操作指南,这在当下这个“一键出图”的时代显得尤为可贵。它强迫你必须自己动手去思考数据的分布形态,去理解直方图的每一个柱子代表的意义。我记得有一段关于“异常值处理”的讨论,作者没有简单地给出“删除”或“替换”的建议,而是花费了大量篇幅讨论“什么是异常”——是数据采集的错误,还是真实存在的极端事件?这种思辨性的探讨,让我对数据质量的评估有了一个全新的、更负责任的态度。读完这本书,我感觉自己像是从一个“计算员”变成了一个“数据侦探”,不再盲目相信任何数字,而是带着批判的眼光去审视数据背后的故事。
补考
补考
补考
补考
补考