
具体描述
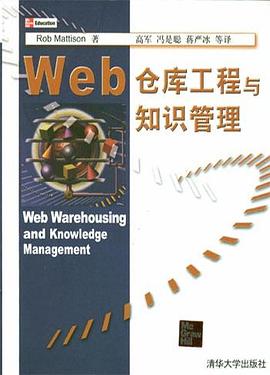
《Web仓库工程与知识管理》是一本独特而直接的问题指南,揭示了采用新方法开发商务系统的关键。它特别为那些正在向新的技术和理论过渡的人编写,揭开Web仓库工程和知识管理的神秘面纱。从本书中您可以学习: Web仓库工程的基本原理——学习Internet、WALS、TCP/IP、PPP、CGI、Java和JDBC,掌握如何使用这些技术轻松解决商务问题。知识管理——热门的新型系统开发方法,确保您的新系统将减少开支和增加利润。 Web仓库工程应用程序——揭示用来实现Web仓库工程的新一代应用程序。详细阐述了如何将Web集成到商务智能解决方案中,以重新激励企业,并挖掘产品的潜能。《Web仓库工程与知识管理》由一流的商务智能市场Web技术应用专家撰写,帮您理解Web商务的新世界,从容应当今充满竞争的商业挑战。这本资源手册为您提供了丰富而客观的背景信息、实践技能、商务透视以及案例研究,以便您用来评估自身系统和探索独特的解决方案。如果您正在参与设计、实现或评估Web仓库工程解决方案,或者您正在应对为21世纪建立协作计算机系统的挑战,《Web仓库工程与知识管理》可以为您提供完整的解决方案。
作者简介
目录信息
第一章 WEB仓库工程与知识管理
第二章 从EDISON到BERNERS-LEE:新技术的吸收过程
第三章 价值链和终止应用程序
第四章 设想、建模和价值建议
第五章 知识网络、知识领居和知识经济
第二部分 WEB仓库工程实践
第六章 传统的数据仓库工程体系结构与技术
第七章 基于WEB的查询和报表
第八章 WEB OLAP
第九章 基于WEB的统计分析和数据挖掘
第十章 基于WEB的图形和地理信息系统
第十一章 文本信息管理系统的介绍
第十二章 文本信息管理系统的体系结构
第十三章 搜索引擎和设施
第十四章 文本挖掘系统
第十五章 多媒体信息管理系统
第三部分 技术基础
第十六章 INTERNET和INTERNET服务
第十七章 WEB组件和通信
第十八章 PPP和CGI:WEB的数据库访问
第十九章 JAVA:WEB编程的可选方法
第二十章 在JAVA中使用JDBC访问数据库
第二十一章 体系结构、性能和管理
· · · · · · (收起)
读后感
用户评价
我对这本书的文学性保持着一种敬意。它摒弃了那种僵硬的说明书式语言,转而采用了一种更具引导性和启发性的叙事风格。文字的节奏把握得恰到好处,时而如疾风骤雨般深入技术细节,时而又像涓涓细流般阐述宏观的管理理念。这种张弛有度的表达方式,极大地降低了技术专有名词带来的阅读门槛。特别是书中穿插的一些历史案例分析,追溯了早期信息管理失败的根源,这些故事性很强的小插曲,不仅丰富了内容,更让抽象的管理原则变得生动可感。它让我意识到,知识管理并非仅仅是IT部门的职责,而是一种贯穿于整个组织文化中的思维习惯。作者成功地将冰冷的技术语汇,注入了对效率和协作的哲学思考,使得这本书不仅适合技术人员,对项目经理和部门主管而言,也极具参考价值,能帮助他们从更深层次理解“信息资产”的真正价值。
这本书的阅读体验,更像是一次对“信息宇宙”的精细化导航训练。我注意到作者在叙述过程中,非常注重工具链的选择与整合。他没有武断地推崇某一种特定的商业软件,而是着重讲解了背后的设计哲学。比如,在谈到版本控制和配置管理时,他深入探讨了为什么Git等分布式系统能够更好地适应现代软件开发中的并行工作模式,以及如何利用其特性来确保知识资产的版本一致性。书中对于不同知识载体(如代码注释、设计文档、会议纪要)的分类处理策略,展现了作者对信息密度和存取效率的深刻理解。我个人认为,最精彩的部分在于如何将这些异构的信息源有机地编织成一个统一的知识网络,书中提供的框架模型具有很高的普适性,即便我的工作环境与作者描述的场景略有不同,其核心逻辑依然能够完美映射。读完后,我立刻动手尝试优化了我个人工作流中的信息收集步骤,效果立竿见影。
这本书的结构布局显示出极高的专业水准。每一章节的过渡都显得自然而然,仿佛是精心绘制的一张路线图,引导读者从基础概念逐步迈向复杂的实践应用。我最欣赏的是作者对于“风险规避”在知识体系构建中的作用的论述。他没有回避现实中知识孤岛、文档过时等常见痛点,而是系统地提出了预防和补救措施。例如,关于“自动化文档生成”的章节,它提供了一系列可操作的脚本思路和工具集成方案,这远远超出了普通理论书籍的范畴,直接触及了实施层面。这种“理论指导实践,实践反哺理论”的良性循环,是这本书最核心的价值所在。读罢全书,我感觉自己获得了一个强大的工具箱,里面装满了不仅是工具,更是使用这些工具的智慧,它让我对如何构建一个可持续、可扩展的知识支撑体系有了全新的、更具系统性的认知和信心。
这本书的装帧设计着实吸引眼球,封面那一抹深邃的蓝色与抽象的几何线条,让人联想到精密的数据结构和浩瀚的知识海洋。初翻阅时,我便被其行文的严谨和逻辑的清晰所折服。它并非那种故作高深的学术著作,而是巧妙地将工程学的系统思维融入到日常的信息组织中。作者似乎对软件开发生命周期有着深刻的洞察,书中对于需求分析、架构设计乃至后期的维护优化,都有着一套行之有效的流程阐述,读起来让人感觉每一步都踏在了坚实的土地上。特别是关于模块化设计的部分,它不仅仅停留在理论层面,而是结合了多个实际案例,详细剖析了如何通过精妙的接口定义来解耦复杂的系统,这对于我这种在实际工作中经常面对“意大利面条式代码”的开发者来说,无异于醍醐灌顶。我尤其欣赏作者对于“可追溯性”的强调,在构建大型信息系统时,能够清晰地记录每一次修改的缘由和影响范围,是保障系统稳定性的基石,这本书在这方面的论述深入且富有启发性,绝非泛泛而谈。
说实话,我对技术书籍的阅读往往抱着一种审慎的态度,很多作品往往在理论上堆砌术语,却缺乏与现实场景的有效连接。然而,这本书在处理“知识管理”这一核心议题时,展现出了一种罕见的务实精神。它没有仅仅停留在传统的文档管理范畴,而是着眼于知识的“流动性”和“生命周期”。书中关于如何构建一个能够自我学习、自我修正的知识库体系的探讨,让我眼前一亮。我感觉作者在设计这一体系时,可能借鉴了某些前沿的AI模型训练思路,强调的是信息的上下文关联和有效利用率,而非单纯的存储容量。其中关于“知识沉淀机制”的描述,非常细致地指导了如何将团队的隐性经验转化为显性的、可复用的资产。这种将“工程化”的精确性与“管理学”的灵活性完美结合的笔法,使得全书的阅读体验非常流畅,像是跟随一位经验丰富的首席架构师在进行一次深入的技术研讨会。