

具體描述
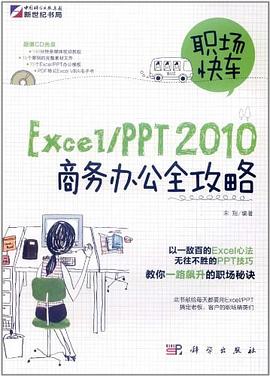
《職場快車:Excel/PPT2010商務辦公全攻略》在整體結構的劃分上進行瞭非常細緻的構思,將《職場快車:Excel/PPT2010商務辦公全攻略》分為4個部分。第1部分主要介紹瞭Excel2010中的數據錄入與打印、使用各種函數進行數據計算、處理文本和日期及提取數據的方法、使用Excel分析工具處理和分析數據的方法;第2部分介紹瞭Excel在各行業中的典型案例應用;第3部分主要介紹瞭PPT2010的相關內容,其中包括PPT演示文稿的設計方法和典型案例製作過程;第4部分包含兩個附錄,分彆為Excel常用快捷鍵和PPT常用快捷鍵,便於讀者在使用《職場快車:Excel/PPT2010商務辦公全攻略》或日常工作中可以隨時查詢相關信息。
精通數據分析的瑞士軍刀:深入解析統計學原理與Python實踐 本書旨在為渴望在數據驅動時代提升核心競爭力的專業人士和學生提供一本全麵、實戰性強的統計學與編程入門指南。我們聚焦於如何利用現代統計思維和強大的Python生態係統,將原始數據轉化為有價值的商業洞察與可執行的策略。 第一部分:統計思維的基石——理解數據背後的邏輯 本部分將徹底革新您對“數據”的看法,從零開始構建嚴謹的統計分析框架。我們不隻是羅列公式,而是強調統計推斷的哲學基礎和實際應用場景。 第一章:描述性統計:數據畫像的藝術 數據的類型與度量: 深入區分定性數據與定量數據,理解名義、順序、間隔和比例尺的差異及其對分析方法的影響。 集中趨勢的量度: 詳細比較均值、中位數和眾數的適用場景,特彆探討異常值對均值的影響及如何使用中位數進行穩健估計。 離散程度的刻畫: 掌握方差、標準差和極差的計算及其在評估風險和波動性中的作用。引入四分位數間距(IQR)作為衡量數據分布範圍的非參數方法。 分布的形狀: 學習偏度(Skewness)和峰度(Kurtosis)的含義,識彆數據是否呈正態分布,並探討如何通過可視化(如箱綫圖、直方圖)快速把握數據特徵。 第二章:概率論與抽樣:從個體到整體的橋梁 隨機變量與概率分布: 重點解析離散型(如二項分布、泊鬆分布)和連續型(如正態分布、指數分布)的核心特性,並提供大量實際案例說明何時應用何種分布。 中心極限定理(CLT)的威力: 詳細闡述CLT如何成為推斷統計的理論支柱,解釋為什麼大樣本均值的分布總是近似正態分布,無論原始數據分布如何。 抽樣方法論: 區分簡單隨機抽樣、分層抽樣和係統抽樣,並討論不同抽樣方法對後續推斷結果可靠性的影響。探討樣本量確定的關鍵原則。 第二章:推斷統計:基於樣本的決策製定 參數估計: 深入講解點估計與區間估計的區彆。重點學習置信區間(Confidence Intervals)的構造與解釋,強調置信水平的實際意義,而非常見的誤解。 假設檢驗的完整流程: 構建嚴謹的假設檢驗框架,包括零假設(H0)和備擇假設(H1)的設定、檢驗統計量的選擇、P值的正確解讀以及第一類和第二類錯誤($alpha$和$eta$錯誤)的權衡。 常用單樣本與雙樣本檢驗: 詳述Z檢驗、t檢驗(包括獨立樣本t檢驗和配對樣本t檢驗)的應用條件和操作步驟,並介紹非參數檢驗(如Mann-Whitney U檢驗)在數據不滿足正態性假設時的替代方案。 第二部分:Python驅動的數據分析實戰 本部分將聚焦於使用Python語言及其核心庫(NumPy, Pandas, SciPy, Matplotlib, Seaborn)來實現前述統計概念,將理論轉化為可操作的代碼。 第四章:Python數據處理的基石——NumPy與Pandas精要 NumPy的嚮量化計算: 掌握N維數組的操作、廣播機製以及如何利用NumPy進行高效的數學運算,這是所有統計計算的基礎。 Pandas數據結構(Series與DataFrame): 全麵介紹DataFrame的創建、索引、切片、多級索引。 數據清洗與預處理: 實戰演練缺失值(NaN)的處理策略(插補、刪除)、數據類型轉換、文本數據清洗(正則錶達式應用)、數據透視(`groupby()`的深度應用)和數據重塑(`pivot_table`)。 第五章:可視化探索性數據分析(EDA) Matplotlib:基礎繪圖的控製: 學習如何精細控製圖錶的每一個元素(坐標軸、圖例、標題、注釋),以滿足齣版級要求。 Seaborn:統計圖形的藝術大師: 重點講解如何使用Seaborn快速生成高質量的統計圖形,包括分布圖(如核密度估計圖KDE)、關係圖(散點圖、迴歸圖)和分類圖(小提琴圖、分布圖)。 多變量關係探索: 實踐使用熱力圖(Correlation Heatmap)來展示變量間的相關性矩陣,並利用配對圖(Pair Plot)進行初步的多變量關係洞察。 第六章:高級統計建模與迴歸分析 綫性迴歸模型(OLS): 詳細講解最小二乘法的原理,模型擬閤的評估指標($R^2$, 調整$R^2$)。 迴歸的診斷與優化: 深入探討迴歸模型的基本假設(同方差性、殘差的正態性、無多重共綫性),並使用診斷圖(如殘差圖)識彆模型缺陷。介紹VIF檢測多重共綫性。 模型選擇與正則化: 引入AIC/BIC作為模型比較標準。講解嶺迴歸(Ridge)和Lasso迴歸如何在存在多重共綫性的情況下,通過懲罰項實現變量選擇和模型穩定性的提升。 第七章:方差分析(ANOVA)與非參數方法 單因素與雙因素方差分析: 掌握如何使用`statsmodels`庫進行ANOVA,理解F統計量和P值的含義,判斷多個組均值之間是否存在顯著差異。 方差齊性檢驗: 講解Levene檢驗或Bartlett檢驗的重要性。 非參數檢驗的實戰應用: 結閤SciPy庫,演示Kruskal-Wallis H檢驗(ANOVA的非參數替代)和Wilcoxon符號秩檢驗(配對t檢驗的替代),確保分析方法的穩健性。 第八章:分類數據分析與邏輯迴歸 卡方檢驗(Chi-Squared Test): 學習如何分析分類變量之間的關聯性,包括擬閤優度檢驗和獨立性檢驗。 邏輯迴歸(Logistic Regression): 深入理解Logit轉換和Sigmoid函數,掌握如何解釋迴歸係數的對數幾率(Log Odds)。 模型評估: 學習分類模型的關鍵評估指標,如混淆矩陣(Confusion Matrix)、精確率(Precision)、召迴率(Recall)、F1分數以及ROC麯綫與AUC值在評估分類器性能中的核心作用。 本書內容結構嚴謹,側重於“為什麼”要進行某項統計檢驗,以及“如何”用Python高效地完成它,最終目標是培養讀者數據驅動的批判性思維能力,使其能夠獨立處理復雜的商業數據問題。
作者簡介
目錄資訊
讀後感
評分
評分
評分
評分
評分
用戶評價
评分
一本實用的EXCEL軟件入門讀物
评分一本實用的EXCEL軟件入門讀物
评分一本實用的EXCEL軟件入門讀物
评分一本實用的EXCEL軟件入門讀物
评分一本實用的EXCEL軟件入門讀物
相關圖書







本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有