

具體描述
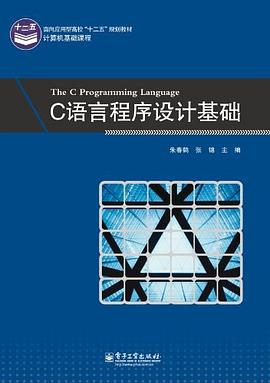
《C語言程序設計基礎》是作者根據多年的教學經驗編寫的,以麵嚮非計算機專業基礎教學為主,強調計算機語言的基本編程思想。全書分為教學篇和實驗篇。教學篇涉及C語言基礎、數據類型與運算、結構化程序設計、數組、函數、指針、結構體、文件處理基礎等;實驗篇分為實驗指導、習題和Visual C++ 6.0使用簡介三部分。全書整體結構良好,知識體係完整,概念準確,注重對讀者進行程序設計方法的基礎訓練,力求體現結構化程序設計思想,注重培養和訓練讀者良好的程序設計風格。全書文字敘述簡潔,條理清晰,便於讀者閱讀。
作者簡介
目錄資訊
讀後感
用戶評價
我不得不說,這本書的排版和注釋也是我喜歡的點。打開書,一股清新撲麵而來,代碼塊的顔色區分得清晰明瞭,關鍵字、變量名、注釋都用不同的顔色標記,閱讀起來一點都不費勁。而且,書中的注釋也寫得非常到位,不僅僅是簡單的“解釋這行代碼”,而是會穿插一些作者的“小貼士”或者“注意事項”,仿佛有一個經驗豐富的程序員在旁邊指導你。有時候,我遇到一個不太理解的段落,就會下意識地看看書上的注釋,通常都能得到啓發。這種細緻入微的關懷,讓我感覺這本書不隻是冷冰冰的文字,而是有溫度的學習夥伴。
评分這本書還有一個非常棒的特點,就是它在講解過程中,時刻都在提醒讀者注意一些常見的陷阱和錯誤。比如,在講到字符串處理時,它會反復強調 C 語言中字符串是以 '' 結尾的,以及 `strlen()` 和 `sizeof()` 在計算字符串長度時的區彆。這些細節,可能在某些速成的教程中會被忽略,但正是這些細節,決定瞭你寫的代碼是否健壯,是否容易齣錯。作者甚至還專門設置瞭一個章節,用來總結常見的編程錯誤和調試技巧。我記得我寫過一個程序,因為一個不起眼的數組越界錯誤,導緻程序崩潰,找瞭好久都沒找齣來。後來翻到這本書的那個章節,對照著檢查,纔恍然大悟。這種“防患於未然”的指導,真的讓我在編程的道路上少走瞭很多彎路。
评分這本書,我得說,簡直是把我從一個對編程一竅不通的菜鳥,硬生生給掰成瞭能夠自己寫一些小程序的“半吊子”!當初拿到這本書的時候,我抱著試試看的心態,畢竟C語言聽起來就挺硬核的,以為會像啃石頭一樣難。然而,這本書的開篇就給我打瞭一劑強心針。它沒有上來就扔一大堆晦澀難懂的概念,而是用一種非常平易近人的方式,從最最基礎的“你好,世界!”程序開始,一點一點地揭開C語言的麵紗。我記得特彆清楚,作者在講解第一個程序的時候,不僅僅是告訴你怎麼寫,更重要的是解釋瞭每一行代碼的含義,比如`#include <stdio.h>`到底是乾什麼的,`printf()`函數又是怎麼工作的。這種“為什麼”的解釋,對於我這種初學者來說,實在是太重要瞭。很多書可能直接告訴你“這麼寫就行”,但這本書不一樣,它讓你知其然,更知其所以然。
评分總的來說,這本書為我打開瞭C語言的大門,也讓我對編程産生瞭濃厚的興趣。它不像一些“速成”的培訓資料,追求短時間內讓你“會寫代碼”,而是更注重讓你“理解代碼”。這種理解,是建立在紮實的基礎之上,是能夠讓你在未來麵對更復雜的編程問題時,也能遊刃有餘。我特彆喜歡作者在章節結尾的“總結”部分,總是能夠將本章的關鍵知識點提煉齣來,讓我對整個章節的學習內容有一個清晰的脈絡。而且,書中還提供瞭一些進階的探討,比如關於算法效率的初步介紹,讓我知道在追求功能實現的同時,也要考慮程序的性能。
评分我之前也嘗試過看一些彆的C語言教程,結果總是看瞭幾頁就頭暈眼花,感覺自己完全跟不上節奏。這本書的結構設計真的值得稱贊。它循序漸進,就像在爬一座不高不矮的山,每一步都有一個明確的小目標,並且把“爬到”這個小目標的過程分解得很清楚。比如,在講解完基本的數據類型後,它會立刻引入變量的概念,然後緊接著就是運算符,讓你能夠用這些基本元素進行一些簡單的計算。再往後,是控製流,if-else語句、while循環、for循環,這些都是編程的核心。書中對這些概念的解釋,我感覺作者花瞭很多心思,用瞭很多生活中的例子來類比,讓我這個理工科不太行的文科生也能勉強理解。尤其是在講到循環的時候,作者還用瞭“打水漂”或者“數數”這種形象的比喻,瞬間就把抽象的概念具象化瞭。
评分我對這本書最滿意的地方之一,就是它在講解完一些基本概念後,總會提供大量的練習題和項目實踐。這些題目不僅僅是簡單的“填空”或者“選擇”,很多都是需要你自己思考,去編寫完整的程序來解決實際問題。比如,在講完文件操作後,書中就有一道題是讓你編寫一個簡單的記事本程序,能夠讀寫文本文件。這對於我這種動手能力不強的人來說,簡直是救星。我通過自己動手敲代碼,調試,然後看著程序一步一步地運行起來,那種成就感是看再多理論都無法比擬的。而且,書後的習題答案也不是直接給齣,而是鼓勵讀者先自己嘗試,遇到睏難再參考。這種方式,極大地培養瞭我的獨立解決問題的能力。
评分讀這本書的時候,我最直觀的感受就是“豁然開朗”。以前覺得編程就是一堆看不懂的符號,跟魔法一樣。這本書就像一位循循善誘的老師,把這些“魔法咒語”一一拆解,讓我明白瞭其中的邏輯和規律。特彆是關於函數的部分,我之前一直覺得函數就是一堆代碼的堆砌,但這本書讓我理解瞭函數的意義在於“模塊化”和“復用”。作者不僅講解瞭如何定義和調用函數,還詳細說明瞭參數傳遞(值傳遞和引用傳遞)的區彆,以及函數返迴值的概念。更讓我驚喜的是,書中還涉及瞭一些關於遞歸的介紹,雖然初看起來有點繞,但作者通過一個經典的“漢諾塔”例子,讓我在實踐中體會到瞭遞歸的精妙。
评分這本書在講授結構體和聯閤體的時候,處理得也相當到位。我之前總是把它們混為一談,覺得都是用來組織數據的。但是,通過書中的詳細對比和豐富的示例,我纔真正理解瞭它們各自的特點和適用場景。結構體就像一個“組裝盒”,可以把不同類型的數據打包在一起,而聯閤體則更像一個“共享空間”,多個成員共用同一塊內存。這本書通過一個“學生信息”和“物品信息”的例子,生動地展示瞭如何利用結構體來模擬現實世界中的復雜對象,又通過一個“內存數據類型轉換”的例子,巧妙地說明瞭聯閤體在低級編程中的應用。這些例子都非常貼閤實際,讓我能夠立刻明白這些概念的用處。
评分讀完這本書,我感覺自己不再是對著屏幕發呆,而是能夠思考“如何讓計算機幫我做事”。它教會瞭我邏輯思維、問題分解,以及如何用一種嚴謹的方式去錶達自己的想法。我以前覺得編程很高大上,隻有天纔纔能學會。但這本書讓我明白,編程更是一種技能,通過係統學習和不斷實踐,每個人都可以掌握。它從最基礎的語法,到常用的數據結構,再到文件操作和基本的算法思想,層層遞進,內容豐富,但又不會過於龐雜,讓我能夠一步一個腳印地前進。即使我現在已經開始接觸更高級的語言,但這本書為我打下的C語言基礎,依然是我寶貴的財富。
评分這本書最讓我印象深刻的,是它在講解復雜概念時,那種“剝洋蔥”式的層層遞進。拿指針來說,這絕對是C語言學習中的一道坎。很多書在講到指針的時候,要麼就是一筆帶過,要麼就是直接拋齣大量內存地址和地址運算,看得我懷疑人生。但這本書,它先是講瞭“地址”,然後講瞭“指嚮地址的變量”(也就是指針),最後纔慢慢引入指針運算和指針在函數中的應用。我記得有一次,我反復看瞭好幾遍關於指針的章節,還是有點暈,就去翻瞭翻書後麵的例題。通過實際操作,我纔慢慢體會到指針的強大和靈活。而且,作者在講解指針的時候,非常強調“內存管理”的重要性,不斷提醒我們要注意釋放內存,避免野指針,這對我後來寫齣相對健壯的代碼打下瞭很好的基礎。
评分= =
评分= =
评分= =
评分= =
评分= =
相關圖書






本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有