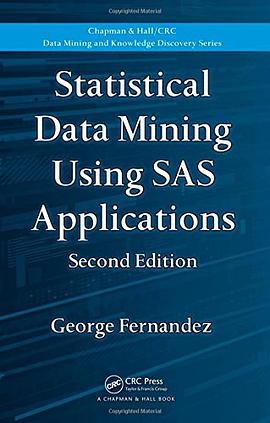
Statistical Data Mining Using SAS Applications, Second Edition

Statistical Data Mining Using SAS Applications, Second Edition pdf epub mobi txt 電子書 下載 在線閱讀 2026

☆☆☆☆☆
出版者:CRC Press
作者:George Fernandez
出品人:
頁數:477
译者:
出版時間:2010-6-18
價格:USD 109.95
裝幀:Hardcover
isbn號碼:9781439810750
叢書系列:
圖書標籤:
  • 數據挖掘
  • sas
  • SAS
  • SAS
  • Data Mining
  • Statistics
  • Machine Learning
  • Predictive Modeling
  • Business Analytics
  • Data Analysis
  • Second Edition
  • Applications
  • Algorithms
想要找書就要到 小哈圖書下載中心
立刻按 ctrl+D收藏本頁
你會得到大驚喜!!

具體描述

深度數據挖掘與統計建模實踐指南:基於現代編程範式 圖書名稱: 深度數據挖掘與統計建模實踐指南:基於現代編程範式 作者: [此處填寫作者姓名] 齣版社: [此處填寫齣版社名稱] ISBN: [此處填寫ISBN] --- 內容概要 本書旨在為數據科學、統計學、計算機科學以及工程領域的專業人士和高級學生提供一個全麵、深入且高度實用的指導手冊,專注於現代數據挖掘的核心概念、先進的統計建模技術,以及如何利用前沿的編程工具鏈(如Python生態係統中的Scikit-learn, TensorFlow/PyTorch, Pandas/NumPy,以及R語言的高級包)高效地實現這些方法。本書的焦點在於“理解其內在機製”與“實現最佳實踐”,而非簡單地羅列軟件操作步驟。 我們摒棄瞭對特定商業軟件操作界麵的過度依賴,轉而深入探討算法的數學基礎、計算復雜性、模型選擇的統計學原理,以及在真實世界大數據環境中進行部署和評估的工程挑戰。全書結構清晰,從基礎的數據預處理與探索性分析(EDA)的精細化步驟入手,逐步構建至復雜的非綫性模型、時間序列分析、高維數據降維技術,並最終涵蓋模型可解釋性(XAI)和因果推斷的現代方法。 第一部分:數據工程與基礎構建(Foundations) 本部分為後續復雜建模打下堅實的數據基礎,強調數據清洗、轉換和特徵工程的重要性,視其為模型性能的決定性因素。 第一章:現代數據科學的工作流與環境搭建 本章首先概述瞭端到端的數據挖掘項目流程,從問題定義到部署。重點介紹Python與R語言在數據科學中的角色定位,並詳細指導讀者搭建高性能的本地及雲端開發環境(包括虛擬環境管理、GPU加速配置)。我們深入探討瞭版本控製(Git/DVC)在數據項目中的關鍵作用,確保分析的可復現性。 第二章:數據清洗、轉換與標準化的高級技術 超越基礎的缺失值插補,本章探討瞭基於模型(如MICE多重插補)和基於領域知識的插補策略。針對異常值檢測,我們詳述瞭基於密度的LOF(Local Outlier Factor)、隔離森林(Isolation Forest)以及基於魯棒統計量的評估方法。數據類型轉換部分側重於特徵編碼的精細化處理,包括Target Encoding、Weight of Evidence (WOE) 在不引入過多信息泄露前提下的應用,以及處理高基數分類變量的策略。 第三章:探索性數據分析(EDA)的深度洞察 EDA不再僅僅是繪圖,而是轉化為結構化的假設生成過程。本章重點介紹多變量關係的挖掘,包括使用Copula函數分析復雜依賴結構,以及使用交互式可視化工具(如Plotly, Bokeh)進行高維數據的探索。此外,我們還講解瞭如何利用統計檢驗(如Permutation Tests)來量化觀測到的模式的顯著性,而非僅僅依賴P值。 第四章:特徵工程的藝術與科學 本章是模型性能的關鍵驅動力。詳細介紹瞭如何從原始數據中構造非綫性特徵、交互項,以及如何利用領域知識(Domain Knowledge)進行特徵設計。針對時間序列數據,講解瞭先進的滯後特徵、傅裏葉變換特徵的應用。特彆關注於自動特徵工程工具包(如Featuretools)的工作原理和限製。 第二部分:經典與集成學習模型精要(Modeling Core) 本部分聚焦於統計學習中經過時間檢驗的核心算法,強調模型背後的統計假設和優化目標。 第五章:綫性模型的高級應用與正則化 本章重溫綫性迴歸和邏輯迴歸,但重點轉嚮解決多重共綫性、模型選擇和維度災難。詳細剖析瞭Ridge、Lasso和Elastic Net迴歸的數學推導及其對模型稀疏性和穩定性的影響。引入瞭廣義可加模型(GAMs)來處理非綫性關係,同時保持模型的可解釋性。 第六章:決策樹、隨機森林與梯度提升機 本章全麵覆蓋瞭基於樹的模型。首先,深入解釋瞭CART、C4.5等算法的原理,特彆是信息增益與基尼不淨度的選擇標準。隨後,詳細分析瞭隨機森林(Bagging)如何通過集成降低方差。核心在於梯度提升(Gradient Boosting),涵蓋瞭經典的GBM、XGBoost、LightGBM和CatBoost的結構差異、優化目標(損失函數)以及Shrinkage、Subsampling等正則化技術的實現細節。 第七章:支持嚮量機(SVM)與核方法 本章探討瞭SVM在小樣本和高維空間中的優勢。詳細闡述瞭核方法的理論基礎,包括多項式核、高斯徑嚮基函數(RBF)核的工作原理,以及如何選擇閤適的核函數和正則化參數C。討論瞭SVM在大規模數據集上的擴展性挑戰及其現代解決方案。 第八章:無監督學習:聚類與降維的深度探索 聚類分析部分,除瞭K-Means,我們深入講解瞭層次聚類(Agglomerative Clustering)的樹狀圖解釋、DBSCAN的空間密度概念以及Mean-Shift算法。在降維方麵,不僅覆蓋瞭PCA,更詳細分析瞭非綫性降維技術如t-SNE和UMAP,強調它們在可視化和特徵提取中的適用場景與局限性。 第三部分:高級建模、驗證與部署(Advanced Topics) 本部分轉嚮現代統計學習中最具挑戰性的領域:深度學習的應用、模型評估的魯棒性以及最終的係統化部署。 第九章:神經網絡基礎與深度學習入門 本章為深度學習構建理論框架。涵蓋瞭前饋網絡(FNN)的構建、反嚮傳播算法的詳細推導、激活函數的選擇(ReLU, Leaky ReLU, Sigmoid的權衡)。重點討論瞭優化器(SGD, Adam, RMSProp)的工作機製、學習率調度策略以及批標準化(Batch Normalization)對訓練穩定性的影響。 第十章:時間序列分析的現代視角 本章超越傳統的ARIMA模型,專注於利用深度學習和復雜迴歸模型處理時間序列數據。講解瞭如何使用循環神經網絡(RNNs,特彆是LSTM和GRU)對序列依賴性進行建模。此外,還涵蓋瞭時間序列的交叉驗證(滾動原點法)以及趨勢、季節性分解的先進技術。 第十一章:模型評估、選擇與統計推斷 本章探討模型驗證的嚴格性。詳細區分瞭Holdout、K-Fold、Leave-One-Out Cross-Validation的適用場景。引入瞭超越準確率和AUC的評估指標,如FPR/FNR麯綫下的麵積、校準麯綫(Calibration Plots)以及Precision-Recall麯綫的深度分析。特彆關注於Bootstraping方法在估計模型穩定性和置信區間中的應用。 第十二章:模型可解釋性(XAI)與因果推斷 在黑箱模型日益普及的背景下,本章是至關重要的實踐環節。我們深入探討瞭模型無關的解釋方法,如SHAP(SHapley Additive exPlanations)值和LIME(Local Interpretable Model-agnostic Explanations)的數學原理和實際應用。此外,本章還介紹瞭結構方程模型(SEM)的基礎,以及傾嚮得分匹配(Propensity Score Matching)和雙重差分(Difference-in-Differences)等因果推斷方法的統計嚴謹性。 附錄:高性能計算與模型部署的工程實踐 附錄提供瞭關於如何使用Dask或Spark進行大規模數據並行計算的指南,以及如何將訓練好的模型封裝成API服務(如使用Flask/FastAPI)進行實時預測的工程流程概述。 --- 本書特色與目標讀者 本書的結構設計確保瞭讀者不僅能“應用”工具,更能“理解”工具背後的統計學和計算邏輯。我們強調統計穩健性、模型泛化能力以及代碼的工程質量。 目標讀者包括: 1. 具備一定統計學或編程基礎,希望將數據挖掘技能提升到專業工程水平的從業人員。 2. 對特定商業軟件的“黑箱”操作感到不滿,渴望深入瞭解算法機製的高級數據分析師和研究人員。 3. 正在攻讀碩士或博士學位,需要將理論知識應用於復雜、前沿數據問題的學生。 本書不提供現成的菜單式點擊指南,而是提供構建、測試和優化尖端數據模型的藍圖。

作者簡介

目錄資訊

讀後感

評分☆☆☆☆☆

这本书应该叫做广告宣传手册。作者应该很牛,但是无法下载宏和数据,通篇掉你胃口 。书中的网站啥都要钱。 哎。。。 这本书应该叫做广告宣传手册。作者应该很牛,但是无法下载宏和数据,通篇掉你胃口 。书中的网站啥都要钱。 哎。。。 这本书应该叫做广告宣传手册。作者应该很...

評分☆☆☆☆☆

这本书应该叫做广告宣传手册。作者应该很牛,但是无法下载宏和数据,通篇掉你胃口 。书中的网站啥都要钱。 哎。。。 这本书应该叫做广告宣传手册。作者应该很牛,但是无法下载宏和数据,通篇掉你胃口 。书中的网站啥都要钱。 哎。。。 这本书应该叫做广告宣传手册。作者应该很...

評分☆☆☆☆☆

这本书应该叫做广告宣传手册。作者应该很牛,但是无法下载宏和数据,通篇掉你胃口 。书中的网站啥都要钱。 哎。。。 这本书应该叫做广告宣传手册。作者应该很牛,但是无法下载宏和数据,通篇掉你胃口 。书中的网站啥都要钱。 哎。。。 这本书应该叫做广告宣传手册。作者应该很...

評分☆☆☆☆☆

这本书应该叫做广告宣传手册。作者应该很牛,但是无法下载宏和数据,通篇掉你胃口 。书中的网站啥都要钱。 哎。。。 这本书应该叫做广告宣传手册。作者应该很牛,但是无法下载宏和数据,通篇掉你胃口 。书中的网站啥都要钱。 哎。。。 这本书应该叫做广告宣传手册。作者应该很...

評分☆☆☆☆☆

这本书应该叫做广告宣传手册。作者应该很牛,但是无法下载宏和数据,通篇掉你胃口 。书中的网站啥都要钱。 哎。。。 这本书应该叫做广告宣传手册。作者应该很牛,但是无法下载宏和数据,通篇掉你胃口 。书中的网站啥都要钱。 哎。。。 这本书应该叫做广告宣传手册。作者应该很...

用戶評價

评分☆☆☆☆☆

這本書應該叫做廣告宣傳手冊 。作者應該很牛,但是無法下載宏和數據,通篇掉你胃口

评分☆☆☆☆☆

這本書應該叫做廣告宣傳手冊 。作者應該很牛,但是無法下載宏和數據,通篇掉你胃口

评分☆☆☆☆☆

這本書應該叫做廣告宣傳手冊 。作者應該很牛,但是無法下載宏和數據,通篇掉你胃口

评分☆☆☆☆☆

這本書應該叫做廣告宣傳手冊 。作者應該很牛,但是無法下載宏和數據,通篇掉你胃口

评分☆☆☆☆☆

這本書應該叫做廣告宣傳手冊 。作者應該很牛,但是無法下載宏和數據,通篇掉你胃口

本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等

© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有