
具体描述
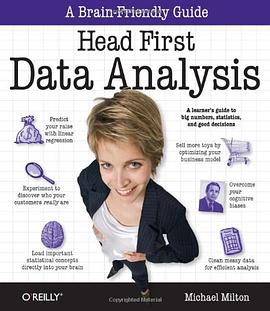
Today, interpreting data is a critical decision-making factor for businesses and organizations. If your job requires you to manage and analyze all kinds of data, turn to "Head First Data Analysis", where you'll quickly learn how to collect and organize data, sort the distractions from the truth, find meaningful patterns, draw conclusions, predict the future, and present your findings to others. Whether you're a product developer researching the market viability of a new product or service, a marketing manager gauging or predicting the effectiveness of a campaign, a salesperson who needs data to support product presentations, or a lone entrepreneur responsible for all of these data-intensive functions and more, the unique approach in "Head First Data Analysis" is by far the most efficient way to learn what you need to know to convert raw data into a vital business tool. You'll learn how to: determine which data sources to use for collecting information; assess data quality and distinguish signal from noise; build basic data models to illuminate patterns, and assimilate new information into the models; cope with ambiguous information; design experiments to test hypotheses and draw conclusions; use segmentation to organize your data within discrete market groups; visualize data distributions to reveal new relationships and persuade others; predict the future with sampling and probability models; clean your data to make it useful; and, communicate the results of your analysis to your audience. Using the latest research in cognitive science and learning theory to craft a multi-sensory learning experience, "Head First Data Analysis" uses a visually rich format designed for the way your brain works, not a text-heavy approach that puts you to sleep.
作者简介
Michael Milton将自己的大半职业生涯献给了非盈利机构,帮助这些机构解析和处理从赞助人那里收集来的数据,提高融资能力。Michael Milton拥有新佛罗里达学院哲学学位及耶鲁大学宗教伦理学学位。多年来,他博览群书,这些书籍虽字字珠玑,却枯燥乏味; 蓦然抬首, 深入浅出(Head First)系列图书让他眼前一亮,他欣然抓住机会,写出了这本同样字字珠玑,兼振奋人心的书。
走出图书馆和书店,人们会看到他在跑步,摄影,以及亲手酿制啤酒。
目录信息
读后感
这本书关注的是假设和建模范围的事情,能清楚地解释概念、模型,且能讲得通俗有趣,已经很不错了。豆瓣评分低大概是觉得太浅吧。 数据分析,尤其是互联网产品经理/运营的数据分析其实不需要太多统计学知识。但要有假设检验的概念。根据多年数据分析经验总结了一下思路: 老板:...
这本书关注的是假设和建模范围的事情,能清楚地解释概念、模型,且能讲得通俗有趣,已经很不错了。豆瓣评分低大概是觉得太浅吧。 数据分析,尤其是互联网产品经理/运营的数据分析其实不需要太多统计学知识。但要有假设检验的概念。根据多年数据分析经验总结了一下思路: 老板:...
找了很久数据分析方面的书,在知乎里看到有人推荐,所以来了,准备拜读。点进去之后是这本书《Head First PHP & MySQL(中文版) 》,大家注意。实际的链接应该是http://www.amazon.cn/%E6%B7%B1%E5%85%A5%E6%B5%85%E5%87%BA%E6%95%B0%E6%8D%AE%E5%88%86%E6%9E%90-%E8%BF%88%E5%8...
在看这本书前,我觉得看数据就像做题一样,配合着“题目”,将有关的模型一个个匹配一遍,接着就往这个模型上靠。跟随着这本书的引言,我开始慢慢地放下心中的急躁,想着目标,观察数据,随着书中故事的递进,揭开数据背后所隐藏的信息。 读这本书的主要目的在于可能要来临的应...
本来想找点深度一点的书,不过当时到了书店后看了两眼发现书的写法很有意思就买下了。 很多人抱怨书的内容不够深入,这点我不反对。不过在我看来,数据分析与其说是理论或技术,倒不如说是一门手艺,仅仅是拿着几个范例数据按照固定的套路算算,看再多的模型,也是...
用户评价
从装帧设计和排版上看,这本书试图营造一种“反传统”的视觉风格,这本无可厚非,毕竟“Head First”系列一直都有这个特点。然而,在这个特定的主题上,这种设计带来的负面影响被放大了。大量的插图、气泡对话框和不同字体颜色的运用,虽然在理论上是为了提高阅读兴趣,但在我看来,它们极大地干扰了对信息层级的判断。当我试图快速定位某个关键算法的输入输出格式时,我不得不穿梭于各种夸张的漫画和高亮标记之间,很多时候,那些用于强调的图示反而成为了阅读的障碍。信息的密度被刻意稀释,使得整本书的篇幅显得过于臃肿,但核心知识点的承载量却非常低。对于需要频繁查阅特定技术细节的读者来说,这种设计极大地降低了工具书的可用性。它看起来像一本有趣的杂志,但做不成一本高效的学习手册。
最让我感到失望的是,这本书在“如何构建一个完整的数据分析项目”这一环节的处理上,几乎是缺失的。它将数据分析拆解成了许多孤立的模块——数据采集、数据清洗、模型选择、结果呈现——并分别对这些模块进行了讲解。然而,真实世界的数据分析是一个连贯且循环的过程,需要对各个阶段之间的相互影响有深刻的理解。这本书从未提供一个端到端(End-to-End)的完整案例,让我们看到一个原始数据文件是如何一步步转化为商业决策的。所有的例子都是片段式的、高度简化的“沙盒”环境。这造成了一个严重的后果:读者虽然学到了一些零散的技能点,但完全不知道如何将这些技能串联起来,去应对一个实际的、脏乱差的项目需求。它教会了你如何使用螺丝刀和扳手,却从不告诉你如何组装一台完整的机器。这种对整体流程的忽视,使得这本书的教育价值远低于一本结构化的项目实战手册。
我最近入手了一本据说非常棒的数据分析入门书籍,但读完之后,我得说,它真的非常侧重于理论的阐述,几乎没有提供任何实际操作的案例或者可以跟着敲的代码示例。书里花了大量的篇幅来讲解统计学的基本概念,比如正态分布、假设检验,这些知识点本身是重要的,但对于一个渴望快速上手、进行实际数据清洗和可视化的读者来说,简直就是一场折磨。我期待的是那种“手把手教你用Python/R解决实际问题”的风格,结果拿到的是一本厚厚的教科书,里面的数学公式多到让人头皮发麻,而且作者似乎认为读者都具备深厚的数理背景。每次读到需要理解一个复杂模型的推导过程时,我都要反复查阅很多其他的资料来辅助理解,这本书完全没有起到引导者的作用。如果你的目标是深入研究数据分析背后的数学原理,或许它合适,但对我这种想尽快将数据转化为洞察的实践者来说,它提供的实用价值非常有限,阅读体验更像是在上枯燥的大学高数课,而不是学习一门应用技术。
这本书的叙事方式简直是一场灾难,它试图用一种非常轻松诙谐的口吻来讲解严肃的主题,结果就是内容被切割得支离破碎,逻辑链条时常断裂。我感觉作者在力图避免使用任何专业术语,但这种过度“口语化”的表达反而让原本清晰的流程变得模糊不清。比如,在介绍数据预处理的步骤时,它会突然插入一个关于作者个人生活的小故事,这个故事和数据处理的关联性微乎其微,读到关键的步骤时,读者不得不花时间去分辨哪些是重点,哪些是“跑题”的闲聊。很多关键概念的定义都隐藏在长篇大论的对话或比喻中,你必须仔细地、逐字逐句地去挖掘,才能找到那个核心的定义。这种阅读节奏非常耗费精力,我常常读完一章后,合上书本,发现自己脑子里留下了一堆零散的、不成体系的概念,而不是一个清晰的数据分析框架。它更像是一系列零碎的“灵感笔记”的集合,而非一本结构严谨的教程。
这本书在选择讨论的工具集方面,表现出一种令人费解的保守倾向。尽管数据分析领域的技术栈发展日新月异,新的库和框架层出不穷,这本书似乎停留在好几年前的技术标准上。它反复强调使用那些已经被更高效、更现代的工具所替代的传统方法。当我尝试将书中的示例代码应用到我当前工作环境中的较新版本库时,遇到了大量的兼容性问题,很多函数已经被弃用或修改了参数。这使得我不得不花费大量时间去搜索引擎上查找“如何在最新版本中实现书里讲的那个功能”,这完全偏离了跟随教程学习的初衷。一本面向“分析”的指南,如果不能与时俱进地介绍当前行业主流、效率最高的工具,其时效性和参考价值就会大打折扣。它更像是一份关于“历史数据分析方法”的文档,而不是一本面向未来的实践指南。
数据分析入门
如果大学学过统计学,这本书没啥干货。如果本身mindset不错,本书的思路也没啥好看的。真的太入门了
入门理想书籍
十分适合做饭的间隙里看。
歪果仁的书写的真有意思,就是内容略简单了些~