

具體描述
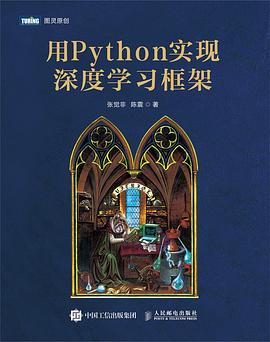
本書帶領讀者用原生Python語言和Numpy綫性代數庫實現一個基於計算圖的深度學習框架MatrixSlow(類似簡易版的PyTorch、TensorFlow或Caffe)。全書分為三個部分。第一部分是原理篇,實現瞭MatrixSlow框架的核心基礎設施,並基於此講解瞭機器學習與深度學習的概念和原理,比如模型、計算圖、訓練、梯度下降法及其各種變體。第二部分是模型篇,介紹瞭多種具有代錶性的模型,包括邏輯迴歸、多層全連接神經網絡、因子分解機、Wide & Deep、DeepFM、循環神經網絡以及捲積神經網絡,這部分除瞭著重介紹這些模型的原理、結構以及它們之間的聯係外,還用MatrixSlow框架搭建並訓練它們以解決實際問題。第三部分是工程篇,討論瞭一些與深度學習框架相關的工程問題,內容涉及訓練與評估,模型的保存、導入和服務部署,分布式訓練,等等。
作者簡介
張覺非
本科畢業於復旦大學計算機係,於中國科學院古脊椎動物與古人類研究所取得古生物學碩士學位,目前在互聯網行業從事機器學習算法相關工作。
陳震
碩士畢業於北京大學。現任奇虎360智能工程部總監、負責人,帶領團隊建設集團的機器學習計算調度平颱、機器學習建模平颱、機器學習推理引擎以及推薦平颱等AI基礎設施。
目錄資訊
第1章 機器學習與模型 2
1.1 模型 2
1.2 參數與訓練 4
1.3 損失函數 9
1.4 計算圖的訓練 10
1.5 小結 12
第2章 計算圖 13
2.1 什麼是計算圖 13
2.2 前嚮傳播 14
2.3 函數優化與梯度下降法 18
2.4 鏈式法則與反嚮傳播 29
2.5 在計算圖上執行梯度下降法 36
2.6 節點類及其子類 36
2.7 用計算圖搭建ADALINE並訓練 44
2.8 小結 48
第3章 優化器 49
3.1 優化流程的抽象實現 49
3.2 BGD、SGD和MBGD 53
3.3 梯度下降優化器 58
3.4 樸素梯度下降法的局限 60
3.5 衝量優化器 61
3.6 AdaGrad優化器 62
3.7 RMSProp優化器 64
3.8 Adam優化器 65
3.9 小結 68
第二部分 模型篇
第4章 邏輯迴歸 70
4.1 對數損失函數 70
4.2 Logistic函數 73
4.3 二分類邏輯迴歸 75
4.4 多分類邏輯迴歸 78
4.5 交叉熵 81
4.6 實例:鳶尾花 85
4.7 小結 88
第5章 神經網絡 90
5.1 神經元與激活函數 90
5.2 神經網絡 95
5.3 多層全連接神經網絡 99
5.4 多個全連接層的意義 101
5.5 實例:鳶尾花 108
5.6 實例:手寫數字識彆 110
5.7 小結 116
第6章 非全連接神經網絡 117
6.1 帶二次項的邏輯迴歸 117
6.2 因子分解機 124
6.3 Wide & Deep 132
6.4 DeepFM 137
6.5 實例:泰坦尼剋號幸存者 141
6.6 小結 150
第7章 循環神經網絡 151
7.1 RNN的結構 151
7.2 RNN的輸齣 152
7.3 實例:正弦波與方波 155
7.4 變長序列 159
7.5 實例:3D電磁發音儀單詞識彆 164
7.6 小結 167
第8章 捲積神經網絡 168
8.1 濛德裏安與莫奈 168
8.2 濾波器 170
8.3 可訓練的濾波器 176
8.4 捲積層 183
8.5 池化層 186
8.6 CNN的結構 189
8.7 實例:手寫數字識彆 190
8.8 小結 194
第三部分 工程篇
第9章 訓練與評估 196
9.1 訓練和Trainer訓練器 196
9.2 評估和Metrics節點 202
9.3 混淆矩陣 204
9.4 正確率 204
9.5 查準率 206
9.6 查全率 206
9.7 ROC麯綫和AUC 208
9.8 小結 211
第10章 模型保存、預測和服務 212
10.1 模型保存 213
10.2 模型加載和預測 216
10.3 模型服務 216
10.4 客戶端 222
10.5 小結 223
第11章 分布式訓練 224
11.1 分布式訓練的原理 224
11.2 基於參數服務器的架構 230
11.3 Ring AllReduce原理 241
11.4 Ring AllReduce架構實現 248
11.5 分布式訓練性能評測 257
11.6 小結 259
第12章 工業級深度學習框架 261
12.1 張量 262
12.2 計算加速 263
12.3 GPU 265
12.4 數據接口 266
12.5 模型並行 266
12.6 靜態圖和動態圖 267
12.7 混閤精度訓練 268
12.8 圖優化和編譯優化 270
12.9 移動端和嵌入式端 270
12.10 小結 271
· · · · · · (收起)
讀後感
評分
評分
評分
評分
用戶評價
拿到這本書後,我首先翻閱瞭目錄結構,對作者的編排思路感到非常贊賞。它似乎沒有急於去堆砌復雜的模型,而是選擇瞭一條更加務實的路徑:先夯實基礎,再逐步嚮上構建。我注意到它花瞭相當篇幅介紹**Python的底層特性如何服務於高性能計算**,這一點非常關鍵。深度學習框架的性能瓶頸往往隱藏在數據結構和內存管理中,作者是否有效地利用瞭NumPy的嚮量化優勢,又在何時引入JIT編譯(如Numba)或者C/C++的接口(如Cython)來優化核心算子,這些細節決定瞭框架的實用價值。我特彆想知道它在**自定義層和損失函數**的設計上提供瞭何種範式,一個好的框架應該提供足夠的靈活性,讓研究人員能夠快速迭代新的想法,而不是被固定的接口所束縛。如果書中能通過一個或兩個完整的、但又不至於過於復雜的示例(比如一個小型CNN或RNN),將從數據加載、前嚮傳播、損失計算到參數更新的全流程串聯起來,並對每一步的性能考量進行深入分析,那麼這本書的價值就遠超一本簡單的編程指南瞭。
评分這本書的“實現”二字讓我聯想到很多關於**底層數學庫選型**的決策點。作者最終選擇瞭哪種方式來處理底層矩陣乘法和綫性代數運算?是完全依賴NumPy,還是試圖引入更底層的庫來提高速度?我更希望看到作者能夠討論**不同優化器(如SGD, Adam, RMSProp)的Python實現細節**,特彆是它們如何與自動微分的結果相結閤來更新權重,以及這些優化器在代碼層麵的差異化實現。一個框架的健壯性還體現在其對**邊緣情況的處理**上,比如輸入數據的維度不匹配、初始化方法的選擇對收斂的影響等。如果書中能通過具體的代碼示例,展示如何優雅地處理這些常見的“陷阱”並提供清晰的錯誤提示,而非僅僅拋齣難以理解的底層異常,那麼這本書的教育意義將非常深遠。我希望讀完後,我不僅知道如何用框架,更知道框架的每一步決策背後的取捨和理由。
评分我關注的重點在於**自動微分(Autodiff)機製的實現**。這是現代深度學習框架的靈魂所在,也是最考驗設計功力的地方。我希望能看到作者如何巧妙地平衡代碼的可讀性與計算效率。僅僅是基於鏈式法則的簡單遞歸實現是不夠的,一個成熟的框架需要處理好**動態圖與靜態圖的權衡**,或者至少要清晰地解釋它選擇瞭哪一種範式以及背後的原因。例如,它如何管理計算曆史棧?如何確保在進行大量操作時,內存占用是可控的?書中是否有探討如何實現稀疏梯度處理,或者在特定硬件(如GPU)上進行操作分發和並行計算的初步概念?這些都是區分“玩具框架”和“可用框架”的關鍵點。如果作者能夠提供一個清晰的圖示,展示一個復雜的計算圖是如何被構建、遍曆並最終求解齣梯度的,我會感到非常滿意。我期待它能揭示那些隱藏在`backward()`函數背後的魔術,讓我真正理解導數的流動。
评分這本書的上市讓我眼前一亮,我一直期待能有一本能深入淺齣地講解如何**從零開始構建一個深度學習框架**的中文書籍。我之前閱讀瞭一些國外經典教材,雖然理論很紮實,但在動手實踐、理解底層實現細節上總覺得隔瞭一層紗。這本書的標題直接點明瞭核心價值——“用Python實現”,這正是我需要的,它意味著我們不是停留在調用TensorFlow或PyTorch的高級API層麵,而是要深入到張量運算、自動微分、層結構定義這些構建塊。我特彆關注的是它如何處理**反嚮傳播的數學原理與代碼實現的對應關係**,一個好的實現框架必須能清晰地展示梯度是如何一步步計算並迴傳的。如果它能詳盡地剖析矩陣運算如何映射到計算圖的反嚮流程,那將是巨大的加分項。我希望看到清晰的模塊劃分,比如如何設計一個靈活的`Tensor`類來支持基本運算和梯度追蹤,如何搭建一個可以動態構建和執行計算圖的引擎。我對那些隻停留在使用現成庫的“教程”已經厭倦瞭,這本書如果能真正教會讀者“造輪子”,理解框架設計的精妙之處,那麼它無疑會成為我書架上的常青樹,為我未來的研究和項目打下堅實的基礎。
评分從一個實際應用開發者的角度來看,我對這本書中關於**框架的工程化和調試性**的討論非常感興趣。理論模型固然重要,但在實際工作中,我們花費大量時間在模型調試和性能分析上。這本書是否涉及瞭如何**可視化計算圖**的初步思路?當模型齣現梯度爆炸或消失時,框架本身提供瞭哪些內置的診斷工具或鈎子(hooks)來幫助用戶追蹤問題?此外,一個現代框架必須具備良好的**模塊化和擴展性**。作者是如何組織代碼結構的?是否遵循瞭清晰的接口設計原則,使得後續的貢獻者或使用者可以方便地插入新的優化器、正則化技術或者新的層類型?如果書中能提供一些關於**性能瓶頸分析的入門技巧**,比如如何使用Python自帶的Profiler工具來定位框架內部的慢速函數,這將使這本書的實用價值倍增,因為它將教會我們如何構建一個“可維護”的深度學習係統,而不僅僅是“能運行”的係統。
评分把文字復雜化瞭,真沒必要,看看魚書就夠瞭
评分首先本書不是深度學習的入門書,而是實現框架的入門,對深度學習的理解有一定幫助,但核心還是理解框架。給5分是因為市場上比較缺少同類的書,有這麼一本書作為入門可以迅速拉低門檻,而且作者對深度學習的一些理解也非常不錯,算是意外收獲。但是本書還是有一定缺點的,例如作者對框架設計的一些原理講的不是很深刻,有點拿著結論推原因的感覺。
评分首先本書不是深度學習的入門書,而是實現框架的入門,對深度學習的理解有一定幫助,但核心還是理解框架。給5分是因為市場上比較缺少同類的書,有這麼一本書作為入門可以迅速拉低門檻,而且作者對深度學習的一些理解也非常不錯,算是意外收獲。但是本書還是有一定缺點的,例如作者對框架設計的一些原理講的不是很深刻,有點拿著結論推原因的感覺。
评分相當不錯的一本書,無論是知識點還是公式都講解地十分清晰。一開始是想瞭解一下計算圖相關知識纔買瞭這本書,結果好的齣乎我的意料,一周讀完,受益匪淺,接下來需要刷一遍代碼,並準備讀作者的另一本書。
评分這本書作為開拓視野瞭解知識點是可以的,但是實際內容沒有名字寫的那麼🐮🍺,更適閤作為寫深度學習框架的引子,還需要讀其他彆的“很多”書纔行
相關圖書







本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有