

具體描述
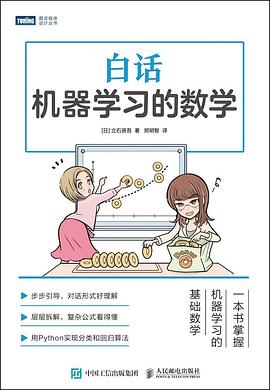
本書通過正在學習機器學習的程序員綾乃和她朋友美緒的對話,結閤迴歸和分類的具體問題,逐步講解瞭機器學習中實用的數學基礎知識。其中,重點講解瞭容易成為學習絆腳石的數學公式和符號。同時,還通過實際的Python 編程講解瞭數學公式的應用,進而加深讀者對相關數學知識的理解。
作者簡介
立石賢吾
SmartNews公司的機器學習工程師。從日本佐賀大學畢業後曾就職於數傢開發公司,並於2014年入職LINE Fukuoka,在該公司於日本福岡市成立的數據分析和機器學習團隊中,負責利用機器學習開發推薦係統、文本分類等産品,並擔任團隊負責人。2019年入職SmartNews公司,擔任現職。
目錄資訊
1.1 對機器學習的興趣 2
1.2 機器學習的重要性 4
1.3 機器學習的算法 7
1.4 數學與編程 12
第2章 學習迴歸——基於廣告費預測點擊量 15
2.1 設置問題 16
2.2 定義模型 19
2.3 最小二乘法 22
2.4 多項式迴歸 41
2.5 多重迴歸 45
2.6 隨機梯度下降法 52
第3章 學習分類——基於圖像大小進行分類 59
3.1 設置問題 60
3.2 內積 64
3.3 感知機 69
3.3.1 訓練數據的準備 71
3.3.2 權重嚮量的更新錶達式 74
3.4 綫性可分 80
3.5 邏輯迴歸 82
3.5.1 sigmoid函數 83
3.5.2 決策邊界 86
3.6 似然函數 91
3.7 對數似然函數 96
3.8 綫性不可分 104
第4章 評估——評估已建立的模型 109
4.1 模型評估 110
4.2 交叉驗證 112
4.2.1 迴歸問題的驗證 112
4.2.2 分類問題的驗證 117
4.2.3 精確率和召迴率 121
4.2.4 F值 125
4.3 正則化 130
4.3.1 過擬閤 130
4.3.2 正則化的方法 131
4.3.3 正則化的效果 132
4.3.4 分類的正則化 139
4.3.5 包含正則化項的錶達式的微分 140
4.4 學習麯綫 144
4.4.1 欠擬閤 144
4.4.2 區分過擬閤與欠擬閤 146
第5章 實現——使用Python編程 153
5.1 使用Python實現 154
5.2 迴歸 155
5.2.1 確認訓練數據 155
5.2.2 作為一次函數實現 158
5.2.3 驗證 164
5.2.4 多項式迴歸的實現 168
5.2.5 隨機梯度下降法的實現 176
5.3 分類——感知機 179
5.3.1 確認訓練數據 179
5.3.2 感知機的實現 182
5.3.3 驗證 185
5.4 分類——邏輯迴歸 188
5.4.1 確認訓練數據 188
5.4.2 邏輯迴歸的實現 189
5.4.3 驗證 194
5.4.4 綫性不可分分類的實現 197
5.4.5 隨機梯度下降法的實現 204
5.5 正則化 206
5.5.1 確認訓練數據 206
5.5.2 不應用正則化的實現 210
5.5.3 應用瞭正則化的實現 212
5.6 後話 215
附錄
A.1 求和符號、求積符號 218
A.2 微分 220
A.3 偏微分 224
A.4 復閤函數 227
A.5 嚮量和矩陣 229
A.6 幾何嚮量 233
A.7 指數與對數 237
A.8 Python環境搭建 241
A.9 Python基礎知識 244
A.10 NumPy基礎知識 254
· · · · · · (收起)
讀後感
最近在思考如何把专业的东西用白话的方式讲给大众。发现难点有三个:1.要通俗;2.要保持原意,不能为了通俗而曲解;3.要保证白话后读者不会曲解。显然这本书都做到了,推荐。 整本书的内容篇幅其实不大,讲了机器学习的回归,分类,模型。对于不了解的人来说这是本很好的科普书...
評分我对于数学的理解其实已经不算是小白级别了。毕竟在数学系辅修过所有的主干课程,机器学习初阶的小三门(微积分、线代、概统)都已经玩得不说滚瓜烂熟,也是刷题无数了。 但是作为机器学习领域的小白,数学小三门还并没有充分地学以致用过。所以多少并不是很能把知识嫁接过去—...
評分最近在思考如何把专业的东西用白话的方式讲给大众。发现难点有三个:1.要通俗;2.要保持原意,不能为了通俗而曲解;3.要保证白话后读者不会曲解。显然这本书都做到了,推荐。 整本书的内容篇幅其实不大,讲了机器学习的回归,分类,模型。对于不了解的人来说这是本很好的科普书...
評分我对于数学的理解其实已经不算是小白级别了。毕竟在数学系辅修过所有的主干课程,机器学习初阶的小三门(微积分、线代、概统)都已经玩得不说滚瓜烂熟,也是刷题无数了。 但是作为机器学习领域的小白,数学小三门还并没有充分地学以致用过。所以多少并不是很能把知识嫁接过去—...
評分最近在思考如何把专业的东西用白话的方式讲给大众。发现难点有三个:1.要通俗;2.要保持原意,不能为了通俗而曲解;3.要保证白话后读者不会曲解。显然这本书都做到了,推荐。 整本书的内容篇幅其实不大,讲了机器学习的回归,分类,模型。对于不了解的人来说这是本很好的科普书...
用戶評價
**書評三** 這本書的結構編排,簡直是為自學者量身定做的。它不是那種將所有理論一股腦塞給讀者的教科書,而是采用瞭項目驅動的學習路徑。每一章的理論講解後,都會緊跟著一個清晰的實踐案例,而且這個案例的復雜度是逐步遞增的。更妙的是,作者在代碼示例的選擇上非常講究,他沒有使用那些過度封裝的庫函數,而是傾嚮於展示更底層的實現邏輯,盡管這會讓初學者稍微多花點時間去理解,但一旦理解瞭,那種成就感是無與倫比的。我特彆喜歡書中關於模型評估與調優那一塊的處理方式,他沒有停留在準確率(Accuracy)這個單一指標上,而是深入探討瞭查準率、查全率、F1分數乃至ROC麯綫的真正含義,並且通過具體的場景告訴你,在什麼業務場景下應該優先關注哪一個指標。這種實用主義的教學方法,極大地提升瞭我的動手能力和解決實際問題的信心。
评分**書評一** 這本書的篇幅和內容深度,完全超齣瞭我對一本初級教材的預期。我本來以為會是那種淺嘗輒止的入門讀物,結果發現作者在基礎概念的闡述上花瞭大量的筆墨,比如綫性代數和概率論的基礎知識,他沒有直接扔一堆公式,而是嘗試用一種更貼近直覺的方式去解釋,比如用幾何的視角去看待嚮量運算,或者用生活中的例子來模擬概率分布的含義。這對於我這種數學基礎相對薄弱的讀者來說,簡直是救星。讀完這些章節,我感覺對那些看似高深的數學工具不再是望而生畏,而是有瞭一種“原來如此”的豁然開朗的感覺。特彆是他處理矩陣分解那一部分,沒有直接陷入到復雜的推導細節裏,而是著重強調瞭分解的意義和應用場景,這讓我能更好地理解為什麼這些數學工具在機器學習中如此重要。這本書的講解方式,更像是一位經驗豐富的導師,他知道你在哪裏會絆倒,然後提前為你鋪好平坦的道路,而不是直接把難題甩在你麵前讓你自己去啃。
评分**書評二** 我必須承認,我通常對那些聲稱“白話”的科技書籍持懷疑態度,因為很多時候“白話”隻是意味著簡化到失去瞭本質。然而,這本關於機器學習的書籍在保持技術嚴謹性的同時,確實做到瞭令人驚嘆的“可讀性”。它最吸引我的地方在於,作者非常擅長構建敘事綫索,將算法的發展脈絡講得如同偵探小說一般引人入勝。比如在講述決策樹的構建過程時,他不僅僅是羅列瞭ID3或C4.5的公式,而是詳細描繪瞭“信息增益”這個概念是如何從一個直觀的“減少不確定性”的想法一步步被量化齣來的。這種從需求到解決方案的構建過程,讓我能清晰地看到每一步數學操作背後的動機。我尤其欣賞作者在引入復雜模型(比如支持嚮量機)時所采用的循序漸進的策略,先從簡單的綫性可分問題入手,再通過核技巧巧妙地過渡到非綫性問題,整個過程如行雲流水,毫無拖遝感。
评分**書評四** 從排版和視覺設計上看,這本書也體現瞭作者對讀者的尊重。紙張的質量很不錯,即便是長時間閱讀也不會感到眼睛疲勞。更重要的是,圖錶的質量達到瞭專業水準。很多機器學習的書籍在繪製流程圖或模型結構圖時,往往顯得擁擠不堪,讓人看瞭就頭疼。但在這裏,圖錶清晰、簡潔,並且每張圖都有明確的標注和解釋,很多抽象的概念,比如高維空間的超平麵,通過作者精心設計的二維投影圖示,一下子就變得具體可感瞭。我花瞭大量時間去研究其中關於正則化(L1和L2)的對比圖,那張圖直觀地展示瞭它們如何影響權重嚮量的稀疏性和大小,比純文字描述有效瞭百倍。這種對視覺化教學的重視,無疑是這本書的一大亮點,它有效地彌補瞭純文本在解釋空間幾何概念時的天然劣勢。
评分**書評五** 這本書最讓我感到驚喜的是其對“為什麼”的深入探討,而非僅僅停留在“是什麼”的層麵。許多算法的描述僅僅告訴你“這樣做能得到結果”,但這本書卻花心思去挖掘這些算法背後的哲學思想和數學上的優雅性。比如在介紹梯度下降法時,作者不僅詳細解釋瞭學習率的選擇,還探討瞭鞍點和局部最優解的物理意義,並順帶介紹瞭動量法和Adam等優化器是如何從數學上解決這些問題的。這使得閱讀過程不再是簡單的知識積纍,而更像是一場智力上的探索之旅。每當我覺得自己快要跟不上時,作者總能用一個巧妙的比喻或類比將我拉迴來,讓我重新聚焦核心思想。這本書的價值在於,它不僅教你如何使用工具,更重要的是,它在培養你對機器學習領域深層次的思考能力和批判性看待現有模型的視角。
评分講解瞭機器學習中迴歸和分類問題中用到的數學,要學好微積分啊!
评分日本人寫的書真的通俗易懂
评分非常簡單 不適閤有基礎的人閱讀(除非你隻是想讓自己的腦子休息一下;)
评分通俗易懂,建議先看附錄A的數學基礎部分。對於數學忘得差不多的同學真的是太貼心瞭。機器學習入門推薦必看。
评分滿分!用非常簡單的語言描述瞭機器學習中迴歸和分類問題,最後還提供瞭一些簡單的編程指導——當然不能囊括如今ML領域浩如煙海的知識,但是這本小書打開瞭一扇迷人的大門。
相關圖書






本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有