
具体描述
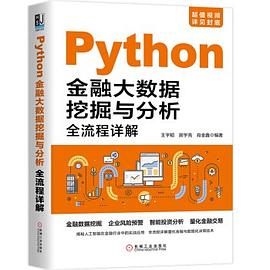
金融从业者每天都要与海量的数据打交道,如何从这些数据中挖掘出需要的信息,并进行相应的分析,是很多金融从业者非常关心的内容。本书以功能强大且较易上手的Python语言为编程环境,全面讲解了金融数据的获取、处理、分析及结果呈现。
全书共16章,内容涉及Python基础知识、网络数据爬虫技术、数据库存取、数据清洗、数据可视化、数据相关性分析、IP代理、浏览器模拟操控、邮件发送、定时任务、文件读写、云端部署、机器学习等,可以实现舆情监控、智能投顾、量化金融、大数据风控、金融反欺诈模型等多种金融应用。无论是编程知识还是金融相关知识,本书都力求从易到难、循序渐进地讲解,并辅以商业实战案例来加深印象。
本书定位为一本金融科技入门读物,但书中的数据挖掘与分析思想对其他行业来说也具备较高的参考价值。本书又是一个金融科技工具箱,里面的代码可以方便地速查速用,解决实际工作中的问题。
本书适合金融行业的从业人员学习。对于大中专院校金融、财会等专业的师生,以及具备一定计算机编程基础,又希望投身金融行业的读者,本书也是不错的参考读物。
作者简介
王宇韬:华能贵诚信托金融科技实验室发起人,宾夕法尼亚大学硕士,上海交通大学学士,两年内通过CFA 3级、FRM 2级、AQF,在华能贵诚信托自主研发了舆情监控系统、资金雷达、流程自动化AI系统、机器视频面试系统等,专注于科技在金融领域的应用。
房宇亮:依图科技高级算法工程师,加州大学洛杉矶分校(UCLA)硕士,南京大学学士,擅长计算机视觉、图像识别、语音识别等人工智能算法。
肖金鑫:本硕均就读于国防科技大学,专攻数据安全方向,在数据爬取与反爬取领域有较深的造诣,曾参加多个重点数据安全科研项目。
目录信息
1.1 Python安装与第一个Python程序
1.1.1 安装Python
1.1.2 编写第一个Python程序
1.1.3 PyCharm的安装与使用
1.2 Python基础知识
1.2.1 变量、行、缩进与注释
1.2.2 数据类型:数字与字符串
1.2.3 数据类型:列表与字典、元组与集合
1.2.4 运算符
1.3 Python语句
1.3.1 if条件语句
1.3.2 for循环语句
1.3.3 while循环语句
1.3.4 try/except异常处理语句
1.4 函数与库
1.4.1 函数的定义与调用
1.4.2 函数的返回值与作用域
1.4.3 常用基本函数介绍
1.4.4 库
第2章 金融数据挖掘之爬虫技术基础
2.1 爬虫技术基础1—网页结构基础
2.1.1 查看网页源代码—F12键
2.1.2 查看网页源代码—右键菜单
2.1.3 网址构成及http与https协议
2.1.4 网页结构初步了解
2.2 爬虫技术基础2—网页结构进阶
2.2.1 HTML基础知识1—我的第一个网页
2.2.2 HTML基础知识2—基础结构
2.2.3 HTML基础知识3—标题、段落、链接
2.2.4 HTML基础知识4—区块
2.2.5 HTML基础知识5—类与id
2.3 初步实战—百度新闻源代码获取
2.3.1 获取网页源代码
2.3.2 分析网页源代码信息
2.4 爬虫技术基础3—正则表达式
2.4.1 正则表达式基础1—findall()函数
2.4.2 正则表达式基础2—非贪婪匹配之(.*?)
2.4.3 正则表达式基础3—非贪婪匹配之.*?
2.4.4 正则表达式基础4—自动考虑换行的修饰符re.S
2.4.5 正则表达式基础5—知识点补充
第3章 金融数据挖掘案例实战1
3.1 提取百度新闻标题、网址、日期及来源
3.1.1 获取网页源代码
3.1.2 编写正则表达式提取新闻信息
3.1.3 数据清洗并打印输出
3.2 批量获取多家公司的百度新闻并生成数据报告
3.2.1 批量爬取多家公司的百度新闻
3.2.2 自动生成舆情数据报告文本文件
3.3 异常处理及24小时实时数据挖掘实战
3.3.1 异常处理实战
3.3.2 24小时实时爬取实战
3.4 按时间顺序爬取及批量爬取多页内容
3.4.1 按时间顺序爬取百度新闻
3.4.2 一次性批量爬取多页内容
3.5 搜狗新闻与新浪财经数据挖掘实战
3.5.1 搜狗新闻数据挖掘实战
3.5.2 新浪财经数据挖掘实战
第4章 数据库详解及实战
4.1 MySQL数据库简介及安装
4.2 MySQL数据库基础
4.2.1 MySQL数据库管理平台phpMyAdmin介绍
4.2.2 创建数据库及数据表
4.2.3 数据表基本操作
4.3 Python与MySQL数据库的交互
4.3.1 安装PyMySQL库
4.3.2 用Python连接数据库
4.3.3 用Python存储数据到数据库
4.3.4 用Python在数据库中查找并提取数据
4.3.5 用Python从数据库中删除数据
4.4 案例实战:把金融数据存入数据库
第5章 数据清洗优化及数据评分系统搭建
5.1 深度分析—数据去重及清洗优化
5.1.1 数据去重
5.1.2 常见的数据清洗手段及日期格式统一
5.1.3 文本内容深度过滤—剔除噪声数据
5.2 数据乱码的处理
5.2.1 编码分析
5.2.2 重新编码及解码
5.2.3 解决乱码问题的经验方法
5.3 舆情数据评分系统搭建
5.3.1 舆情数据评分系统版本1—根据标题评分
5.3.2 舆情数据评分系统版本2—根据正文内容评分
5.3.3 舆情数据评分系统版本3—解决乱码问题
5.3.4 舆情数据评分系统版本4—处理非相关信息
5.4 完整的百度新闻数据挖掘系统搭建
5.4.1 将舆情数据评分存入数据库
5.4.2 百度新闻数据挖掘系统代码整合
5.4.3 从数据库汇总每日评分
第6章 数据分析利器:NumPy与pandas库
6.1 NumPy库基础
6.1.1 NumPy库与数组
6.1.2 创建数组的几种方式
6.2 pandas库基础
6.2.1 二维数据表格DataFrame的创建与索引的修改
6.2.2 Excel工作簿等文件的读取和写入
6.2.3 数据的读取与编辑
6.2.4 数据表的拼接
6.3 利用pandas库导出舆情数据评分
6.3.1 汇总舆情数据评分
6.3.2 导出舆情数据评分表格
第7章 数据可视化与数据相关性分析
7.1 用Tushare库调取股价数据
7.1.1 Tushare库的基本用法
7.1.2 匹配舆情数据评分与股价数据
7.2 舆情数据评分与股价数据的可视化
7.2.1 数据可视化基础
7.2.2 数据可视化实战
7.3 舆情数据评分与股价数据相关性分析
7.3.1 皮尔逊相关系数
7.3.2 相关性分析实战
第8章 金融数据挖掘之爬虫技术进阶
8.1 爬虫技术进阶1—IP代理简介
8.1.1 IP代理的工作原理
8.1.2 IP代理的使用方法
8.2 爬虫技术进阶2—Selenium库详解
8.2.1 网络数据挖掘的难点
8.2.2 模拟浏览器ChromeDriver的下载与安装
8.2.3 Selenium库的安装
8.2.4 Selenium库的使用
第9章 金融数据挖掘案例实战2
9.1 新浪财经股票实时数据挖掘实战
9.1.1 获取网页源代码
9.1.2 数据提取
9.2 东方财富网数据挖掘实战
9.2.1 获取网页源代码
9.2.2 编写正则表达式提取数据
9.2.3 数据清洗及打印输出
9.2.4 函数定义及调用
9.3 裁判文书网数据挖掘实战
9.4 巨潮资讯网数据挖掘实战
9.4.1 获取网页源代码
9.4.2 编写正则表达式提取数据
9.4.3 数据清洗及打印输出
9.4.4 函数定义及调用
第10章 通过PDF文本解析上市公司理财公告
10.1 PDF文件批量下载实战
10.1.1 爬取多页内容
10.1.2 自动筛选所需内容
10.1.3 理财公告PDF文件的自动批量下载
10.2 PDF文本解析基础
10.2.1 用pdfplumber库提取文本内容
10.2.2 用pdfplumber库提取表格内容
10.3 PDF文本解析实战—寻找合适的理财公告
10.3.1 遍历文件夹里所有的PDF文件
10.3.2 批量解析每一个PDF文件
10.3.3 将合格的PDF文件自动归档
第11章 邮件提醒系统搭建
11.1 用Python自动发送邮件
11.1.1 通过腾讯QQ邮箱发送邮件
11.1.2 通过网易163邮箱发送邮件
11.1.3 发送HTML格式的邮件
11.1.4 发送邮件附件
11.2 案例实战:定时发送数据分析报告
11.2.1 用Python提取数据并发送数据分析报告邮件
11.2.2 用Python实现每天定时发送邮件
第12章 基于评级报告的投资决策分析
12.1 获取券商研报网站的表格数据
12.1.1 表格数据的常规获取方法
12.1.2 用Selenium库爬取和讯研报网表格数据
12.2 pandas库的高阶用法
12.2.1 重复值和缺失值处理
12.2.2 用groupby()函数分组汇总数据
12.2.3 用pandas库进行批量处理
12.3 评估券商分析师预测准确度
12.3.1 读取分析师评级报告数据进行数据预处理
12.3.2 用Tushare库计算股票收益率
12.3.3 计算平均收益率并进行分析师预测准确度排名
12.4 策略延伸
12.4.1 涨停板的考虑
12.4.2 按分析师查看每只股票的收益率
12.4.3 计算多阶段股票收益率
第13章 用Python生成Word文档
13.1 用Python创建Word文档的基础知识
13.1.1 初识python-docx库
13.1.2 python-docx库的基本操作
13.2 用Python创建Word文档的进阶知识
13.2.1 设置中文字体
13.2.2 在段落中新增文字
13.2.3 设置字体大小及颜色
13.2.4 设置段落格式
13.2.5 设置表格样式
13.2.6 设置图片样式
13.3 案例实战:自动生成数据分析报告Word文档
第14章 基于股票信息及其衍生变量的数据分析
14.1 策略基本思路
14.2 获取股票基本信息及衍生变量数据
14.2.1 获取股票基本信息数据
14.2.2 获取股票衍生变量数据
14.2.3 通过相关性分析选取合适的衍生变量
14.2.4 数据表优化及代码汇总
14.3 数据可视化呈现
14.4 用xlwings库生成Excel工作簿
14.4.1 xlwings库的基本用法
14.4.2 案例实战:自动生成Excel工作簿报告
14.5 策略深化思路
第15章 云服务器部署实战
15.1 云服务器的购买与配置
15.2 程序的云端部署
15.2.1 安装运行程序所需的软件
15.2.2 实现程序24小时不间断运行
第16章 机器学习之客户违约预测模型搭建
16.1 机器学习在金融领域的应用
16.2 决策树模型的基本原理
16.2.1 决策树模型简介
16.2.2 决策树模型的建树依据
16.3 案例实战:客户违约预测模型搭建
16.3.1 模型搭建
16.3.2 模型预测及评估
16.3.3 模型可视化呈现
· · · · · · (收起)
读后感
用户评价
我一直对量化投资和金融风控领域有着浓厚的兴趣,但一直苦于没有一本能够系统梳理相关技术和实践的书籍。市面上的书籍要么过于理论化,要么过于碎片化。这本书的标题“Python金融大数据挖掘与分析全流程详解”让我看到了希望。我特别想了解书中在“金融大数据挖掘”方面有哪些创新性的方法和应用。例如,如何利用自然语言处理(NLP)技术从海量新闻、研报、公告中提取有价值的信息,从而辅助投资决策?如何利用机器学习和深度学习模型进行市场情绪分析、事件驱动交易信号的识别?在“分析”方面,我希望看到一些关于如何构建有效的风险管理体系的探讨,比如如何利用大数据进行反欺诈、信用评估、市场风险监测等。更重要的是,“全流程详解”意味着我期待这本书能够提供一套完整的、可复制的实践框架,帮助我从零开始构建自己的金融大数据分析项目。
我是一名刚入行不久的金融数据分析师,虽然掌握了一些基础的Python编程和统计学知识,但在面对海量的金融数据时,总有一种力不从心之感。市面上关于Python数据分析的书籍很多,但大多侧重于通用数据处理,对于金融领域的特殊性涉及不多。这本书的标题“Python金融大数据挖掘与分析全流程详解”正是我苦苦寻找的。我非常关注书中对于“挖掘”和“分析”的具体方法论。在挖掘方面,是否会介绍一些在金融领域常用的挖掘技术,例如识别市场异常信号、预测股票价格波动、构建信用风险模型等?这些技术在实际操作中是如何应用的?在分析方面,除了常规的统计分析,是否会深入讲解一些更高级的分析方法,比如基于图网络的金融关联分析,或者利用深度学习进行因子挖掘和策略开发?更重要的是,“全流程详解”意味着它应该能串联起这些技术,形成一套完整的解决方案,而不是零散的知识点堆砌。我期待这本书能够提供清晰的思路和可操作的代码示例,帮助我从“知道”变成“做到”。
对于我这样希望转型进入金融科技行业的开发者来说,这本《Python金融大数据挖掘与分析全流程详解》简直是及时雨。我对书中“全流程详解”的承诺非常看重,因为在实际工作中,很多时候项目会涉及到数据采集、清洗、特征工程、模型训练、评估部署等多个环节,缺乏一个贯穿始终的指导性文档会让人寸步难行。我希望书中不仅会讲解各种Python库(如Pandas, NumPy, Scikit-learn, TensorFlow/PyTorch等)在金融数据处理中的应用,更会侧重于讲解如何将这些工具串联起来,形成一套完整的金融大数据分析流水线。例如,在数据采集部分,是否会详细介绍如何通过API或爬虫获取股票、期货、期权等各类金融市场数据?在模型训练和评估部分,是否会针对金融数据的特性,介绍一些特殊的验证方法,如时间序列交叉验证,以及如何评估模型在真实市场环境下的表现?我对能够获得一套从数据到价值的完整解决方案充满了期待。
这本书的封面设计就透露着一种沉甸甸的专业感,深邃的蓝色背景搭配金色的标题,仿佛在预示着这是一场挖掘金融宝藏的旅程。拿到手后,立刻被它的厚度所震撼,这绝对不是一本可以随意翻阅的快餐读物,而是需要沉下心来,一步步啃食的知识盛宴。我尤其期待书中关于“全流程详解”的部分,因为在实际工作中,很多时候我们只会接触到某个环节,比如数据清洗或者模型构建,但对于整个流程的把握却不够清晰。这本书如果能系统地梳理从数据获取、预处理、特征工程,到模型选择、训练、评估,再到最终的部署和业务应用,整个闭环的知识体系,那将极大地提升我们解决实际金融大数据问题的能力。比如,在数据获取阶段,是否会详细讲解不同金融数据源(如交易所数据、财经新闻、社交媒体等)的特点、爬取方法和API接口使用?在数据预处理部分,又会涉及到哪些针对金融数据的特殊处理技巧,比如缺失值、异常值、时间序列数据的对齐等?我对这些细节充满了好奇,希望这本书能带来耳目一新的启发。
从我多年的金融从业经验来看,真正有价值的金融大数据分析,不仅仅在于掌握高深的算法,更在于理解金融市场的内在逻辑,以及如何将技术手段与业务需求相结合。这本书如果能够做到“详解”,我期待它能不仅仅停留在技术的层面,而是能够深入浅出地讲解技术背后的金融含义。例如,在介绍某个量化交易策略时,是否会解释该策略在金融理论上的依据?在构建风控模型时,是否会探讨模型解释性对金融机构合规性的重要性?我尤其关心“大数据”这个关键词,它意味着书中会涉及到如何处理PB级别的数据,如何进行高效的分布式计算,以及如何应对金融数据特有的高频、高维度、非平稳等特点。希望这本书能提供一些在大规模数据上进行实验和验证的实战案例,让我们这些有着丰富业务经验但技术稍显薄弱的从业者,能够通过学习这本书,更好地驾驭金融大数据,做出更明智的决策。
看了部分,还行,比较言简意赅。
金融从业者每天都要与海量的数据打交道,如新闻舆情数据、股价数据、宏观经济数据、个人信用数据等。如何从这些数据中挖掘出需要的信息,并进行相应的分析,是很多金融从业者非常关心的内容。例如,我们利用网络新闻数据可以搭建舆情监控系统,实现企业风险预警;利用股价数据进行相关量化金融分析,可以寻找合适的交易机会;利用个人信用数据,可以进行大数据风控和金融反欺诈等。 数据分析的工具层出不穷,从Excel软件、R语言,到现在非常火的Python语言,可以说科技的发展给我们配备了很多数据分析的利器。Python语言功能强大且较易上手,本书就采用Python语言来进行数据的挖掘与分析。
由浅入深,比较实用
金融从业者每天都要与海量的数据打交道,如新闻舆情数据、股价数据、宏观经济数据、个人信用数据等。如何从这些数据中挖掘出需要的信息,并进行相应的分析,是很多金融从业者非常关心的内容。例如,我们利用网络新闻数据可以搭建舆情监控系统,实现企业风险预警;利用股价数据进行相关量化金融分析,可以寻找合适的交易机会;利用个人信用数据,可以进行大数据风控和金融反欺诈等。 数据分析的工具层出不穷,从Excel软件、R语言,到现在非常火的Python语言,可以说科技的发展给我们配备了很多数据分析的利器。Python语言功能强大且较易上手,本书就采用Python语言来进行数据的挖掘与分析。
金融从业者每天都要与海量的数据打交道,如新闻舆情数据、股价数据、宏观经济数据、个人信用数据等。如何从这些数据中挖掘出需要的信息,并进行相应的分析,是很多金融从业者非常关心的内容。例如,我们利用网络新闻数据可以搭建舆情监控系统,实现企业风险预警;利用股价数据进行相关量化金融分析,可以寻找合适的交易机会;利用个人信用数据,可以进行大数据风控和金融反欺诈等。 数据分析的工具层出不穷,从Excel软件、R语言,到现在非常火的Python语言,可以说科技的发展给我们配备了很多数据分析的利器。Python语言功能强大且较易上手,本书就采用Python语言来进行数据的挖掘与分析。