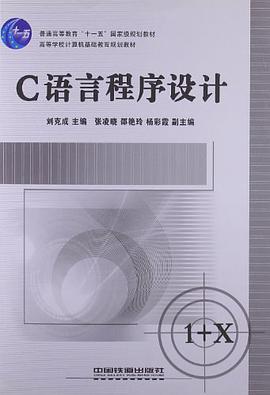
《普通高等教育"十一五"国家级规划教材•高等学校计算机基础教育规划教材:C语言程序设计》共分10章,系统地介绍了程序设计的基本概念,C语言的各种数据类型、运算符与表达式、流程控制结构、模块化程序设计方法和文件系统的基本操作,针对面向对象编程基础也进行了初步阐述。
现代数据科学与人工智能前沿探索 本书聚焦于当前信息技术领域最具活力和变革性的两个方向——数据科学和人工智能,旨在为读者提供一个全面、深入且紧跟行业前沿的知识体系。 第一部分:数据驱动的思维与基础(Data-Driven Thinking and Foundations) 本部分将奠定数据科学的理论基石,强调在海量数据环境中进行有效决策和洞察提取的能力。 第一章:数据科学概论与方法论 数据科学的范式转变: 探讨从传统统计学到现代数据科学的演进,明确数据科学家在企业决策链中的核心作用。讨论数据驱动文化的重要性及其在不同行业(金融、医疗、零售)的落地实践。 研究设计与问题定义: 强调数据科学项目成功的第一步——准确定义商业或科学问题。介绍 CRISP-DM 和 KDD 等主流方法论框架,并深入剖析如何将模糊的业务需求转化为可量化的数据指标(KPIs)。 数据伦理、隐私与治理: 鉴于数据应用的日益广泛,本章将详细讨论数据收集、存储和使用的法律法规(如 GDPR、CCPA),以及算法偏见、公平性(Fairness)、可解释性(Explainability, XAI)和透明度的重要性。 计算环境与工具栈: 介绍现代数据科学工作流所需的关键技术栈,包括分布式计算框架(如 Hadoop 生态系统、Spark 基础架构)、主流编程语言(Python/R)及其核心库(Pandas, NumPy, SciPy)的最新特性和优化技巧。 第二章:数据采集、清洗与预处理 大数据源的获取与集成: 覆盖从结构化数据库(SQL/NoSQL,如 PostgreSQL, MongoDB)到半结构化(JSON, XML)和非结构化数据(文本、图像、日志流)的获取技术。重点介绍 Web Scraping 的规范化方法和 API 调用策略。 数据质量管理(DQM): 识别和处理真实世界数据中的常见问题,包括缺失值(Missing Values)的插补技术(均值、中位数、高级回归插补),异常值(Outliers)的检测(如 Z-Score、IQR、LOF 算法)与处理。 特征工程的艺术与科学: 这是数据科学中最关键的环节之一。本章详细讲解特征构建、转换和选择的多种策略: 数值型特征: 标准化(Standardization)、归一化(Normalization)、对数/幂次变换以处理偏态分布。 类别型特征: 独热编码(One-Hot Encoding)、目标编码(Target Encoding)、频率编码及其在高维稀疏数据中的应用。 时间序列特征: 提取滞后特征、滚动窗口统计量、季节性分解。 维度约减技术: 深入探讨主成分分析(PCA)的理论与实践,以及在处理高维稀疏数据时的非线性降维方法,如t-SNE和UMAP,用于可视化和噪声消除。 第二部分:机器学习与深度学习核心(Core Machine Learning and Deep Learning) 本部分系统介绍从经典机器学习算法到前沿深度学习模型的原理、实现及优化。 第三章:经典机器学习算法精讲 监督学习: 回归模型: 线性回归、岭回归(Ridge)、Lasso 回归、弹性网络(Elastic Net)的正则化原理及其对模型复杂度的控制。 分类模型: 逻辑回归的高级应用、支持向量机(SVM)的核技巧(Kernel Trick)及其在小样本数据集上的优势。 集成学习的威力: 深入剖析 Bagging(如随机森林 Random Forest)和 Boosting(如 AdaBoost, Gradient Boosting Machine, GBM)的工作机制。重点对比 XGBoost, LightGBM 和 CatBoost 在工业界的应用性能和参数调优策略。 无监督学习与聚类: 详解 K-Means、DBSCAN 等密度聚类算法。介绍层次聚类和混合模型(GMM)在数据分割中的应用。 模型评估与选择: 详细阐述交叉验证(Cross-Validation)的各种策略(K-Fold, Stratified K-Fold, Time Series Split)。深入理解评估指标的适用场景:准确率、精确率、召回率、F1-Score、ROC 曲线与 AUC、PR 曲线。 第四章:深度学习架构与实践 神经网络基础回顾与优化: 快速回顾多层感知机(MLP)。重点讲解现代优化器(Adam, RMSProp, Nesterov Momentum)的迭代机制,以及激活函数(ReLU, GeLU, Swish)对收敛速度和梯度消失/爆炸问题的缓解作用。 卷积神经网络(CNN)的进阶: 不仅限于 LeNet 和 AlexNet,本书将聚焦于现代架构如 ResNet(残差连接的机制)、Inception 模块、以及高效网络 MobileNet/EfficientNet 的设计思想。讨论迁移学习(Transfer Learning)在计算机视觉中的标准操作流程。 循环神经网络(RNN)及其演变: 讲解标准 RNN 的局限性。深入解析 LSTM 和 GRU 的门控机制,理解它们如何解决长期依赖问题。介绍 Bi-RNNs 和其在序列标注任务中的应用。 Transformer 架构的革命: 详细解析 Transformer 模型的核心——自注意力机制(Self-Attention)和多头注意力(Multi-Head Attention)。阐述其如何彻底改变了自然语言处理(NLP)领域,为 BERT、GPT 等大型语言模型奠定理论基础。 第三部分:前沿应用与工程化(Advanced Applications and Engineering) 本部分关注如何将理论模型转化为可扩展、可维护的实际生产系统。 第五章:自然语言处理(NLP)的深度应用 词向量的演进: 从 Word2Vec、GloVe 到 FastText,理解词嵌入的分布假设和局限性。 预训练模型(Pre-trained Models)的应用: 深入分析 BERT 家族(如 RoBERTa, ELECTRA)的预训练任务(Masked Language Modeling, Next Sentence Prediction)及其在下游任务(文本分类、命名实体识别、问答系统)中的微调(Fine-tuning)策略。 生成式模型与提示工程(Prompt Engineering): 探讨 GPT 模型的架构基础及其在内容生成、摘要、机器翻译中的表现。引入提示工程的基础概念,如何通过设计输入来引导大型语言模型(LLMs)产生期望的输出。 第六章:时间序列分析与预测 时间序列的分解与平稳性检验: 介绍加法模型和乘法模型。使用 ADF/KPSS 检验评估序列的平稳性。 经典统计模型: 详细讲解 ARIMA、SARIMA 模型及其参数(p, d, q)的确定过程(ACF/PACF 图分析)。 基于机器学习的时间序列建模: 如何使用 LSTMs 或 TCN(Temporal Convolutional Networks)处理非线性和复杂依赖关系的时间序列数据。讨论特征工程在金融市场预测中的独特挑战。 第七章:数据科学工程化(MLOps 基础) 模型部署与服务化: 介绍模型从训练完成到投入生产的整个生命周期管理。讨论 RESTful API 接口设计(如使用 Flask/FastAPI)以及 Docker 容器化技术在保证环境一致性中的作用。 模型监控与再训练: 讨论生产环境中模型性能衰减(Model Drift)的检测方法,包括数据漂移和概念漂移。制定自动化的模型再训练和版本控制策略。 可解释性(XAI)工具箱: 介绍 LIME 和 SHAP 框架,用于解释复杂模型的局部和全局预测,满足监管和业务透明度的要求。 本书特色: 本书在理论深度与工程实践之间找到了黄金平衡点。每一章节都辅以大量的 Python 实际代码示例(基于 TensorFlow 2.x 或 PyTorch),并结合 真实世界数据集 进行项目驱动式学习。它不仅教授“如何做”,更深入解释“为什么这样做”,培养读者独立分析和解决复杂数据问题的能力,是希望从基础知识迈向高级数据科学和人工智能应用领域的学习者和专业人士的理想参考书。